SAIA Plattform
SAIA ist der skalierbare KI-Accelerator (AI), der unsere KI-Dienste hostet.
Zu diesen Diensten gehören Chat AI und CoCo AI, weitere werden in Kürze hinzukommen.
API-Schlüssel für die SAIA-API (Application Programming Interface) können beantragt und innerhalb Ihres Codes zur Nutzung der Dienste verwendet werden.
API-Schlüssel sind nicht erforderlich, um die Web-Oberfläche von Chat AI zu nutzen Web-Oberfläche.
Die SAIA-API eignet sich für interaktive Inferenz-Szenarien.
Falls Sie eine große Anzahl (z. B. Tausende von LLM-Anfragen) asynchron verarbeiten können, ist das Batch-Verfahren unseres HPC-Clusters die bessere Wahl.
Ihre Batch-Aufgabe wird zuverlässiger, schneller und kostengünstiger abgeschlossen.
Informieren Sie sich über die Einrichtung Ihres HPC-Clusters und die Nutzung von LLMs, um zu erfahren, wie Sie eine Batch-Inferenz-Aufgabe auf dem Cluster einrichten können.
vLLM ist eine weitere beliebte Wahl für LLM-Inferenz.
API-Antrag
Wenn ein Benutzer über einen API-Schlüssel verfügt, kann er die verfügbaren Modelle direkt in seiner Terminal- oder Python-Umgebung nutzen.
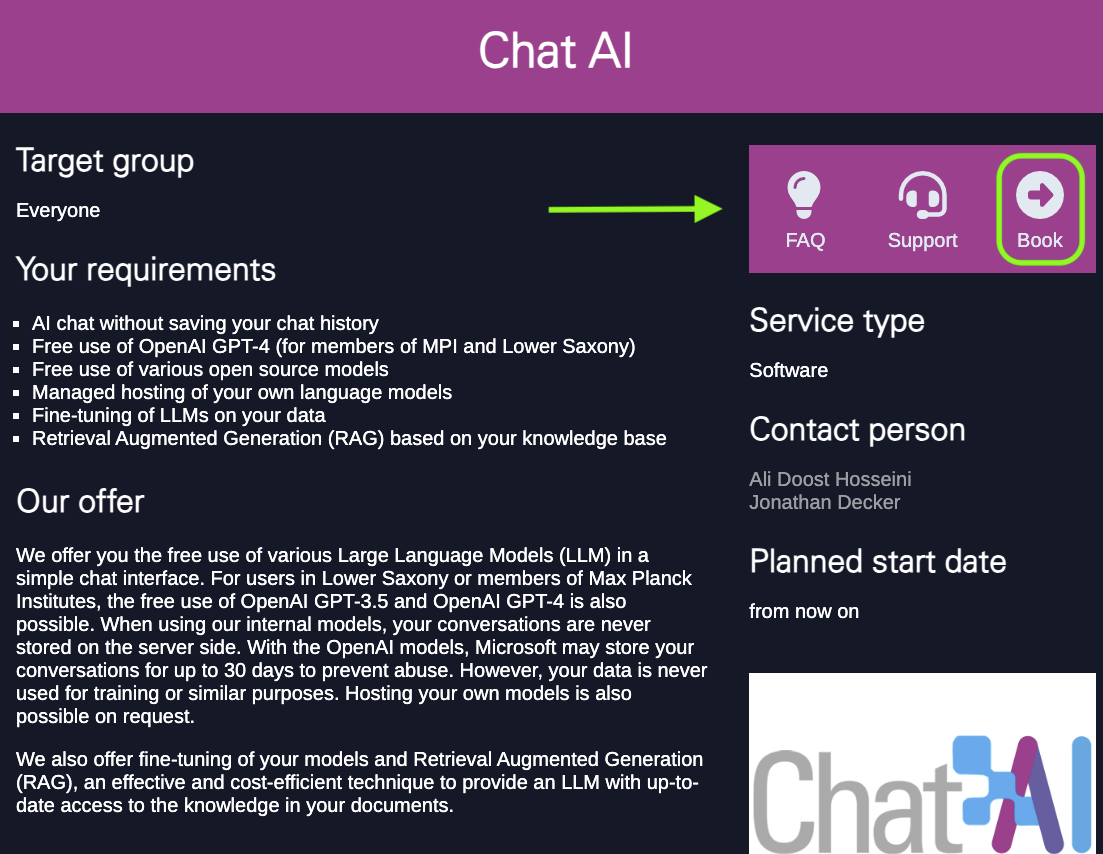
Um Zugang zu einem API-Schlüssel zu erhalten, besuchen Sie die KISSKI LLM-Service-Seite und klicken Sie auf „Buchen“.
Dort finden Sie ein Formular, in dem Sie Ihre Anmeldeinformationen und Ihre Absichten bezüglich des API-Schlüssels angeben können.
Bitte verwenden Sie dieselbe E-Mail-Adresse, die Ihrem Academic Cloud-Konto zugeordnet ist.
Sobald Sie den Schlüssel erhalten haben, teilen Sie ihn nicht mit anderen Benutzern!
API-Nutzung
Der API-Service ist kompatibel mit dem OpenAI API-Standard.
Wir bieten die folgenden Endpunkte:
/chat/completions/completions/embeddings/models/documents
Minimalbeispiel für die API
Sie können Ihren API-Schlüssel verwenden, um direkt über die Terminal-Eingabeaufforderung auf Chat AI zuzugreifen.
Im Folgenden finden Sie ein Beispiel zur Text-Vervollständigung über die API.
Ersetzen Sie <api_key> durch Ihren eigenen API-Schlüssel.
Modellnamen für die API
Weitere Informationen zu den jeweiligen Modellen finden Sie in der Modellliste.
| Modellname | Funktionen |
|---|---|
| apertus-70b-instruct-2509 | Text |
| devstral-2-123b-instruct-2512 | Codierung |
| deepseek-v4-flash-0731 | Text |
| gemma-4-31b-it | Text, Bild |
| glm-5.3-flash | Text, Bild |
| glm-4.7 | Text |
| meta-llama-3.1-8b-instruct | Text |
| mistral-medium-3.5-128b | Text, Bild |
| openai-gpt-oss-120b | Text |
| qwen3.5-122b-a10b | Text, Bild |
| qwen3.5-397b-a17b | Text, Bild |
| qwen3.6-35b-a3b | Text, Bild |
| qwen3.8-27b | Text, Bild |
| qwen3-30b-a3b-instruct-2507 | Text |
| qwen3-coder-next | Text, Code |
| qwen3-omni-30b-a3b-instruct | Text, Omni |
| e5-mistral-7b-instruct | Embeddings |
| multilingual-e5-large-instruct | Embeddings |
| qwen3-embedding-4b | Embeddings |
Eine vollständige, aktuelle Liste der verfügbaren Modelle können Sie mit dem folgenden Befehl abrufen:
Beispiele für die API-Nutzung
Die OpenAI (externen) Modelle sind nicht allgemein für die API-Nutzung verfügbar.
Für eine detailliertere Konfiguration Ihrer Anfragen, z. B. die Einstellung von frequency_penalty, seed, max_tokens usw., verweisen wir auf die OpenAI-API-Referenzseite.
Chat
Es ist möglich, eine gesamte Unterhaltung in Ihre Anfrage einzubinden.
Diese Unterhaltung kann aus einer vorherigen Sitzung mit demselben Modell oder einem anderen stammen, oder zwischen Ihnen und einem Freund/Kollegen, falls Sie weitere Fragen stellen möchten (stellen Sie sicher, dass Sie Ihre System-Nachricht entsprechend anpassen, z. B. „Du bist ein Freund/Kollege, der etwas erklären möchte, das verwirrend war“).
Für eine einfachere Nutzung können Sie die Chat AI-Modelle auch über die Ausführung einer Python-Datei nutzen.
Fügen Sie dazu den folgenden Code in eine Datei ein:
In bestimmten Fällen kann das Modell eine lange Antwort generieren, die mit der oben genannten Methode lange dauern kann, da die gesamte Antwort zunächst generiert und dann auf dem Bildschirm ausgegeben wird.
Stattdessen können Sie Streaming verwenden, um die Antwort bereits während der Generierung zu erhalten.
Für bestimmte Reasoning-Modelle ist es möglich, über die API explizit das Reasoning zu aktivieren oder zu deaktivieren, was in der Modell-Dokumentation oft beschrieben ist.
Zum Beispiel finden Sie die Dokumentation zur Aktivierung oder Deaktivierung des Reasoning für Qwen 3.6 35B A3B hier.
Wenn Sie Visual Studio Code oder Jetbrains als IDE verwenden, ist die empfohlene Methode, um die Nutzung Ihres API-Schlüssels zu maximieren, insbesondere für Code-Vervollständigung, die Installation des Continue-Plugins und die entsprechende Konfiguration.
Weitere Details finden Sie unter CoCo AI.
Azure API
Einige unserer Kunden kommen möglicherweise mit der Azure OpenAI API in Kontakt.
Diese API ist mit der OpenAI-API kompatibel, mit geringfügigen Unterschieden in den JSON-Antworten und der Endpunkt-Verarbeitung.
Der offizielle OpenAI Python-Client bietet einen AzureOpenAI-Client, um diese Unterschiede zu berücksichtigen.
In SAIA, da die externen, nicht-open-weight-Modelle von Microsoft Azure stammen, haben wir eine Übersetzungsschicht erstellt, um die OpenAI-Kompatibilität der Azure-Modelle sicherzustellen.
Bekannte Unterschiede:
- Hinzufügen von
content_filter_resultsin den Antworten von Azure-Modellen.
Bild
Die API-Spezifikation ist kompatibel mit der OpenAI Image API.
Allerdings wird das Abrufen von Bildern aus dem Web nicht unterstützt und Bilder müssen als Teil der Anfrage hochgeladen werden.
Sehen Sie sich das folgende minimale Beispiel in Python an.
Text zu Bild
Ersetzen Sie <key> durch den von GWDG bereitgestellten Schlüssel.
Dieser curl-Befehl verwendet Flux.1-schnell als Backend-Modell.
Bild zu Bild
Ersetzen Sie <key> durch den von GWDG bereitgestellten Schlüssel und <img> durch Ihr Bild.
Dieser curl-Befehl verwendet Qwen-Image-Edit-2511 als Backend-Modell.
Sprache zu Text
Ersetzen Sie <key> durch den von GWDG bereitgestellten Schlüssel, wählen Sie zwischen Transkriptionen oder Übersetzungen, vtt oder srt oder text, und Ihre Audiodatei.
Dieser curl-Befehl verwendet whisper-large-v2 als Backend-Modell.
Embeddings
Embeddings sind nur über die API verfügbar und unterstützen die gleiche API wie die OpenAI Embeddings API.
Sehen Sie sich das folgende minimale Beispiel an.
Sehen Sie sich das folgende Code-Beispiel an, um RAG-Anwendungen mit llamaindex zu entwickeln: gitlab-ce.gwdg.de/hpc-team-public/chat-ai-llamaindex-examples
RAG/Arcanas
Arcanas sind ebenfalls über die API-Schnittstelle zugänglich.
Ein minimales Beispiel mit curl lautet:
Docling
SAIA stellt Docling als Dienst über die API-Schnittstelle an folgendem Endpunkt bereit:
Ein minimales Beispiel mit curl lautet:
Die Antwort ist eine JSON-Antwort wie folgt:
Um nur das Feld „markdown“ aus der Antwort zu extrahieren, können Sie das jq-Tool in der Kommandozeile verwenden (kann mit sudo apt install jq installiert werden).
Sie können die Ausgabe auch einfach in einer Datei speichern, indem Sie > <output-file-name> an den Befehl anhängen.
Hier ist ein Beispiel, um eine PDF-Datei in Markdown zu konvertieren und sie in output.md zu speichern:
Sie können erweiterte Einstellungen in Ihrer Anfrage hinzufügen, indem Sie Abfrageparameter hinzufügen:
| Parameter | Werte | Beschreibung |
|---|---|---|
response_type | markdown, html, json oder tokens | Der Ausgabedateityp |
extract_tables_as_images | true oder false | Ob Tabellen als Bilder zurückgegeben werden sollen |
image_resolution_scale | 1, 2, 3, 4 | Skalierungsfaktor für die Bildauflösung |
Zum Beispiel, um Tabellen als Bilder zu extrahieren, die Bildauflösung mit Faktor 4 zu skalieren und in HTML zu konvertieren, rufen Sie auf:
Dies ergibt eine Ausgabe wie:
API-Grenzwerte
Sie können Ihre aktuellen API-Nutzungsgrenzen und verbleibenden Kontingente direkt in den HTTP-Antwortkopfzeilen überprüfen.
Führen Sie den folgenden Befehl aus (ersetzen Sie <your-API-Key> durch Ihren tatsächlichen Schlüssel und passen Sie den Endpunkt bei Bedarf an):
Die Antwort enthält sowohl den Körper als auch die Rate-Limit-Kopfzeilen.
Beispiel-Ausgabe:
Interpretation der Kopfzeilen
X-RateLimit-Limit-*: Maximale Anzahl an Anfragen pro Zeitfenster (Minute, Stunde, Tag).X-RateLimit-Remaining-*: Anzahl an verbleibenden Anfragen vor Erreichen des Limits.ratelimit-reset: Zeit (in Sekunden), bis der Zähler zurückgesetzt wird.
Entwicklerreferenz
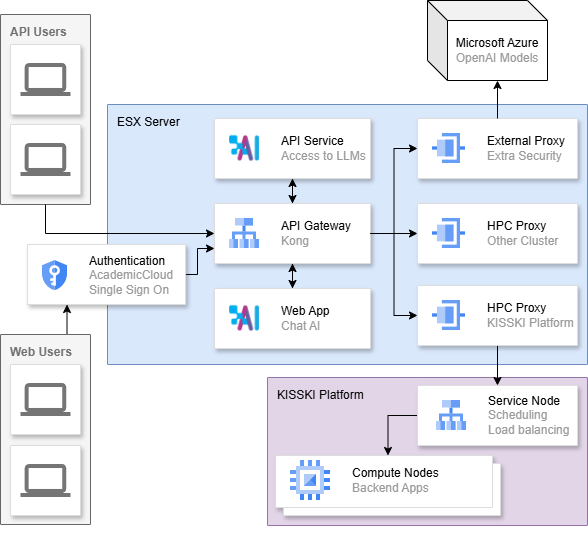
Die GitHub-Repositories SAIA-Hub, SAIA-HPC und Chat AI enthalten alle Komponenten für die Architektur im obigen Diagramm.
Zitierweise
Wenn Sie SAIA in Ihrer Forschung, Dienstleistungen oder Publikationen verwenden, zitieren Sie uns bitte wie folgt:
Weitere Dienste
Falls Sie weitere Fragen haben, kontaktieren Sie uns gerne unter support@gwdg.de.