Herzlich willkommen auf den neuen Seiten der Dokumentation der Dienste der GWDG zur Künstlichen Intelligenz (KI).
Sie finden hier Informationen zu den von uns bereitgestellten KI-Diensten, zu deren Preisstruktur und den verschiedenen Zugangsmöglichkeiten, sowie weiteres nützliches Wissen rund um das Thema KI.
Unsere Kund*innen haben sich gewünscht, dass wir die bisherige Darstellung unserer Services, welche auf Englisch auf den Seiten unserer GWDG HPC Dokumentation verfügbar ist, unter verschiedenen Gesichtspunkten neu gestalten und insbesondere auf Deutsch anbieten.
Wir haben vor, die englische Dokumentation nach und nach zu genau dieser neuen Seite zu migrieren, die Sie gerade lesen.
In dem Menü links haben wir die Darstellung für unterschiedliche Zielgruppen bzw. Rollen der Besucher*innen dieser Dokumentation aufbereitet: Einen allgemeinen Überblick über die KI-Dienste (Produkte) finden Sie in dem Abschnitt Produkte, Mitarbeiter*innen des Einkaufs finden notwendige Informationen unter Beschaffung, in Kürze stellen wir Hinweise zur Verwaltung von Mitarbeitenden-Zugängen für Organisations-Admins in dem Abschnitt Administration bereit, ein Handbuch für Anwender*innen mit wichtigen Hinweisen zur Nutzung unserer Dienste ist unter Benutzerdokumentation verfügbar, darüber hinaus haben wir eine Technische Dokumentation für Entwickler*innen und zeigen grundsätzliche Anlaufstellen und Möglichkeiten zur Vernetzung in dem Abschnitt AI Community.
Falls Sie nach Informationen zu einem bestimmten Thema suchen, können Sie dafür die Suchleiste links benutzen.
Tipp
Wenden Sie sich gerne mit Ihren Fragen an unsere freundlichen Support-Mitarbeiter*innen, insbesondere dann, wenn Sie Anregungen haben oder hier bestimmte für Sie wichtige Informationen vermissen.
Die Kolleg*innen helfen Ihnen dann gerne weiter und wir können unser hier dokumentiertes Angebot auf diese Weise schrittweise ausbauen und verbessern.
Die Academic Cloud ist ein modulares Serviceportal, das bundesweit verfügbar ist für Universitäten, Hochschulen und Forschungseinrichtungen. Als gemeinsame Plattform ermöglicht sie die Bereitstellung, Weiterentwicklung und Nutzung digitaler Dienste über institutionelle Grenzen hinweg und unterstützt die institutionsübergreifende Zusammenarbeit.
Innerhalb der Academic Cloud finden Sie unseren KI-Service in zwei Produktpaketen mit je zwei unterschiedlichen Kostenmodellen. Für „Chat AI" gibt es zudem eine kostenlose Variante für Test- und Evaluierungszwecke. Wenn Sie nur Zugang via API suchen, sind beide Produktpakete als „Nur-API"-Varianten verfügbar. Die zwei Produktpakete sind:
Details
Aktuell sind in den Prepaid- und Flexible-Verträgen für Chat AI neben Arcana/RAG und CoCo AI auch weitere Dienste (Image AI, Voice AI, Protein AI) für eine Testperiode bis zur vollständigen Produktreife der einzelnen Dienste enthalten. Der Zugriff via API auf unsere selbst-gehosteten Open-Weight-Modelle ist grundsätzlich in den Chat AI-Verträgen enthalten.
Chat AI Webdienst mit funktionenreicher Oberfläche, der Zugriff auf eine große Auswahl an großen Open-Weight-Sprachmodellen (LLMs) bietet, die im Rechenzentrum der GWDG in Göttingen gehostet werden.
Chat AI Free - Kostenloser Zugang für Test- und Evaluierungszwecke.
Chat AI External Models zur Einbindung kommerzieller Frontier-Modelle von externen Cloud-Anbietern in unsere Web-Tools und zudem Zugriff via API auf diese Modelle.
Abgesehen von der Free-Variante sind beide Produkte als Prepaid- oder Flexible-Kostenmodelle verfügbar. Das Prepaid-Modell ist ein Guthabensystem mit festem Budget und das Flexible-Modell ist ein Pay-as-you-go-System mit monatlichem Abrechnungszyklus.
Unterabschnitte von Produkte
Chat AI
Chat AI ist ein Webdienst, der über eine funktionenreiche, benutzerfreundliche Oberfläche Zugriff auf eine große Auswahl an großen Sprachmodellen (LLMs) bietet. Er bietet eine sorgfältig ausgewählte Auswahl beliebter Open-Weight-Modelle, die in unserem eigenen Rechenzentrum laufen, sowie anonymen Zugriff auf externe Modelle von kommerziellen Anbietern.
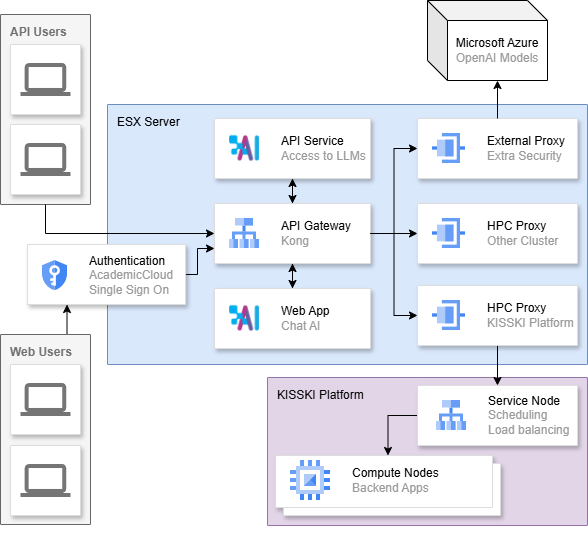
Die Web-Oberfläche wird auf der Cloud-Infrastruktur von GWDG gehostet und leitet Ihre Anfragen sicher über unseren skalierbaren SAIA-Backend-Service an das ausgewählte Modell weiter, wobei entweder auf lokale HPC-Hardware oder, bei Modellen, die als extern gekennzeichnet sind, auf den Service-Endpunkt des kommerziellen Anbieters umgeleitet wird. Unser KI-Team aktualisiert die Liste der unterstützten Modelle regelmäßig und entwickelt kontinuierlich neue Funktionen.
Chat AI ist unsere datenschutzfreundliche, sichere Alternative zu kommerziellen LLM-Diensten: Wir garantieren, dass Ihre Chatverläufe und andere Nutzerdaten nicht auf unseren Systemen gespeichert werden.1
Der Dienst ist über seine Web-Oberfläche erreichbar. Um die Modelle über die API zu nutzen, verweisen wir auf API-Antrag, und um die Modelle über Visual Studio Code zu nutzen, verweisen wir auf CoCo AI.
Wenn Sie lediglich eine schnelle Änderung Ihrer Persönlichkeit (Persona) benötigen, ist dieser der richtige Ort für Sie.
Tipp
Sie benötigen ein Academic Cloud-Konto, um auf die KI-Dienste zugreifen zu können. Verwenden Sie die föderierte Anmeldung oder erstellen Sie ein neues Konto. Details finden Sie auf dieser Seite.
Ausnahmen gelten, siehe unsere Nutzungsbedingungen. Zum Beispiel werden Daten, die Sie bewusst mithilfe von Arcana speichern, aus Gründen der Funktionalität beabsichtigt behalten. ↩︎
Unterabschnitte von Chat AI
Grundwissen
Info
Auf den Seiten des Basiswissen-Bereichs finden Sie verständliche Erklärungen zu grundlegenden Konzepten der Künstlichen Intelligenz. Unabhängig von technischen Vorkenntnisen sollen die Themen den Einstieg in die Nutzung der KI-Dienste erleichtern.
Bitte beachten Sie: Die Inhalte dienen der allgemeinen Information und sind kein Ersatz für technische Dokumentationen oder vertragliche Vereinbarungen.
Wir erweitern in Kürze die Dokumentation zu grundlegendem Wissen zu den KI-Diensten.
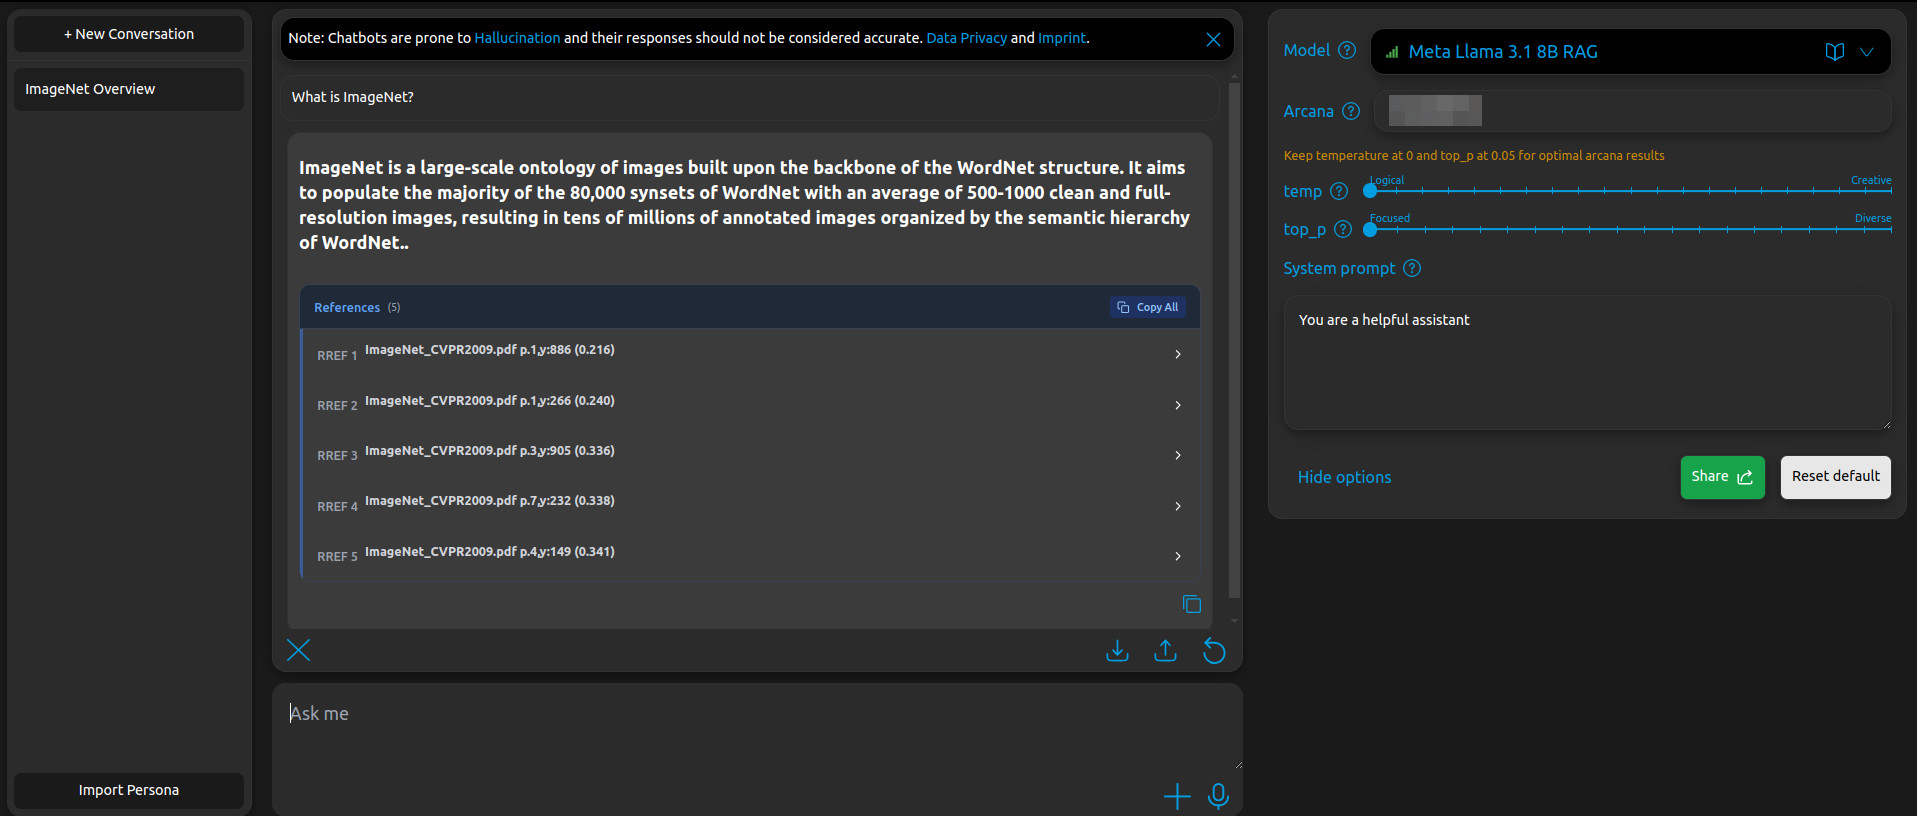
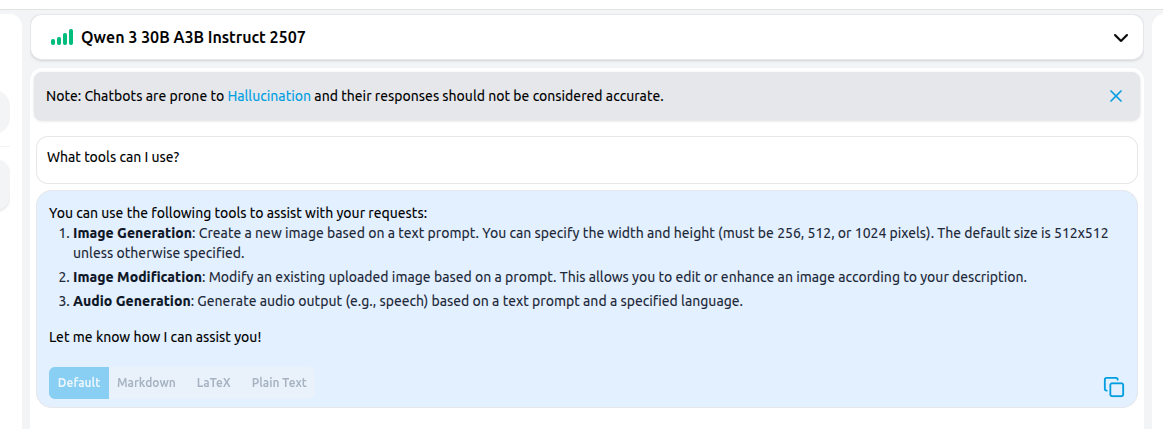
Speicher Speicher sind Informationen, die der Chatbot aus dem Gespräch lernt, um sich personalisierter zu verhalten.
Personas Definieren Sie Rollen und Tonarten für den Assistenten (z.B. Vorstellungsgesprächsinterviewer, Tutor, informeller Stil). Mit Personas können Sie das Verhalten des Modells schnell wechseln.
Chat AI Free Verträge gewähren Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen für Test- und Evaluierungszwecke. Alle Nutzenden müssen über eine Academic ID und eine gültige E-Mail-Adresse verfügen. Der Dienst ist kostenlos und kann auf individueller Basis ohne weitere vertragliche Vereinbarungen in Anspruch genommen werden.
Chat AI Prepaid
Chat AI Prepaid Verträge gewähren Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen. Sie richten sich an Organisationen, die feste Budgets und jährliche Zahlungspläne bevorzugen. Ein Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen. Die Nutzung der KI-Modelle über unsere Weboberfläche oder per API ist optional.
Chat AI Flexible
Chat AI Flexible Verträge gewähren Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen. Sie richten sich an Organisationen, die monatliche Zahlungspläne für eine flexible Nutzung der KI-Modelle benötigen. Die üblichen Anwendungsfälle sind öffentlich zugängliche Anwendungen. Ein Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen. Die Nutzung der KI-Modelle über unsere Weboberfläche oder per API ist optional.
Chat AI Externe Modelle Prepaid
Chat AI Externe Modelle Prepaid Verträge gewähren Zugang zu den extern gehosteten KI-Modellen. Sie richten sich an Organisationen, die feste Budgets und jährliche Zahlungspläne bevorzugen. Ein Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen.
Die Nutzung der KI-Modelle über unsere Weboberfläche setzt einen Chat AI -Vertrag (Prepaid oder Flexible) voraus, Zugang per API ist diesen Fällen optional.
Chat AI Externe Modelle Flexible
Chat AI Externe Modelle Flexible Verträge gewähren Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen. Sie richten sich an Organisationen, Sie richten sich an Organisationen, die monatliche Zahlungspläne für eine flexible Nutzung der KI-Modelle benötigen. Die üblichen Anwendungsfälle sind öffentlich zugängliche Anwendungen. Ein Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen.
Die Nutzung der KI-Modelle über unsere Weboberfläche setzt einen Chat AI -Vertrag (Prepaid oder Flexible) voraus, Zugang per API ist diesen Fällen optional.
Angebotsanfragen
Anfragen richten Sie bitte an support@gwdg.de. Weitere Details zum Anfrageprozess finden Sie unter dem Link Angebotsanfragen.
Kurz-Anleitung
Zugang & Anmeldung
Ein Academic-Cloud-Account ist Voraussetzung. Der Zugang erfolgt über föderiertes Login oder die Erstellung eines neuen Kontos (siehe GWDG-Dokumentation).
Web-Interface
Auf https://chat-ai.academiccloud.de können Sie beim ersten Einstieg eine Guided-Tour erhalten, die Sie durch sämtliche Funktionen der Weboberfläche führt.
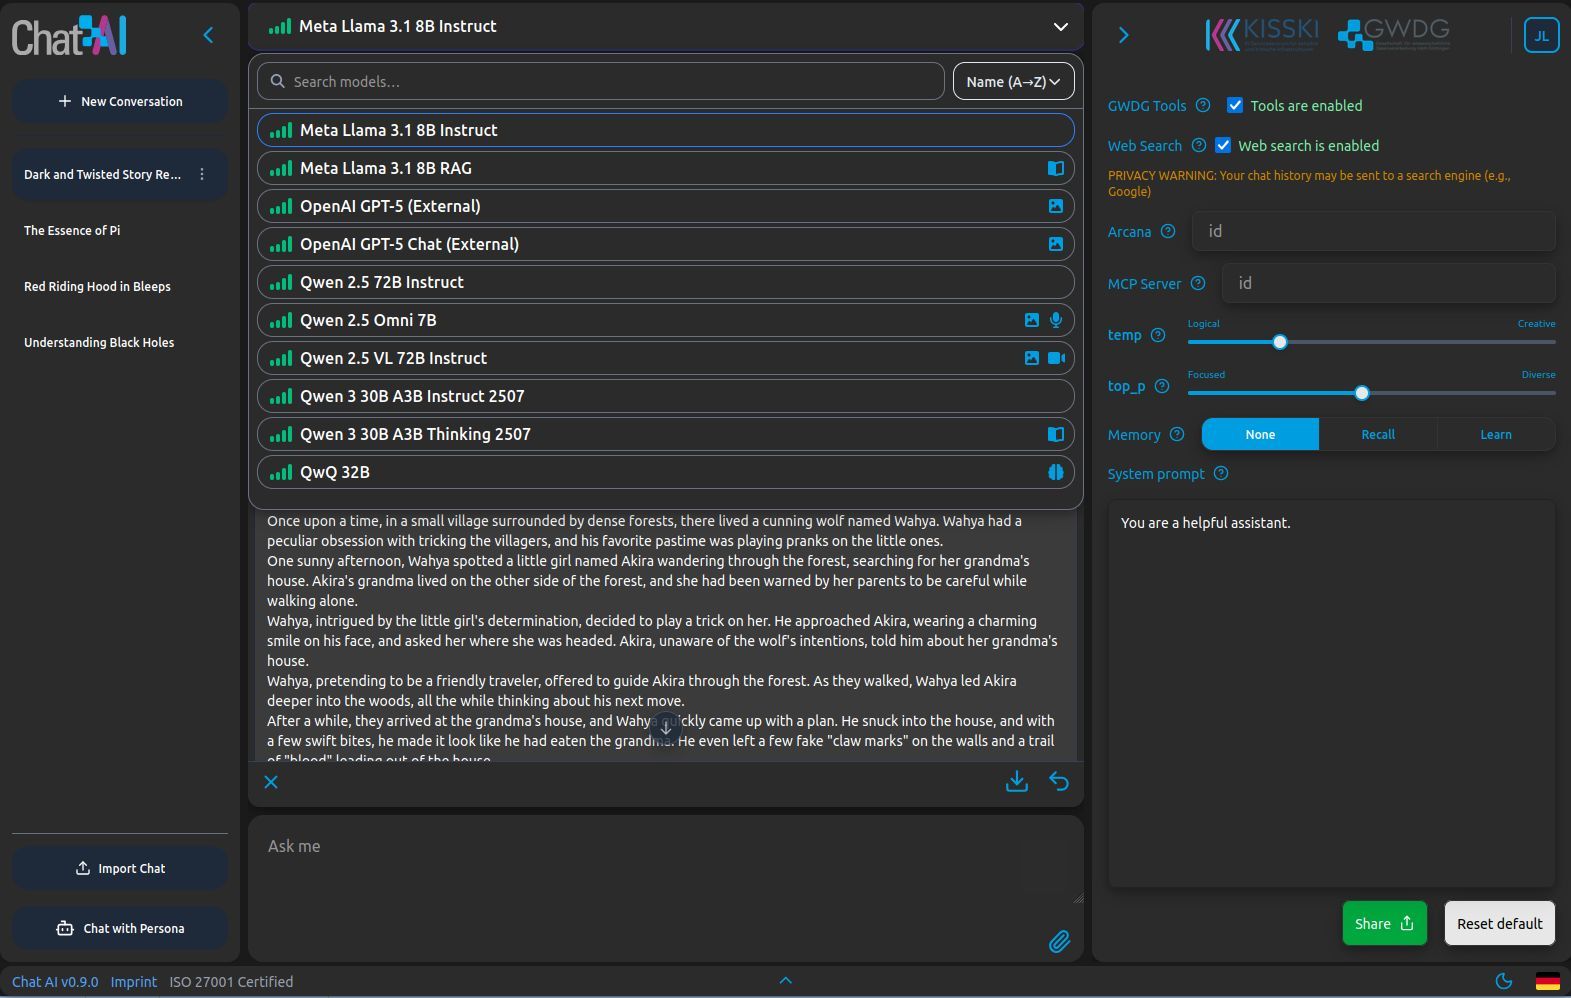
Wählen Sie ein Modell aus der Dropdown-Liste (interne bzw. selbst-gehostete Open-Weight-Modelle sind ohne Hinweis, externe Modelle tragen “(External)”).
Geben Sie Ihren Prompt ein, passen Sie bei Bedarf Temperatur, Top-p und weitere Completion-Optionen an (Standard-Einstellungen sind bereits voreingestellt).
Nutzen Sie vordefinierte Personas oder erstellen Sie eigene, um das Verhalten des Modells gezielt zu steuern.
An dieser Stelle ergänzen wir in Kürze die Entwicklerdokumentation dieses KI-Dienstes - bei Bedarf bitte das aktuelle Git-Repository konsultieren.
Eine Übersicht von Community-Beiträgen finden sie hier.
Administration
Info
Instituts-Admins können über das Admin-Portal Budget-Limits für definierte Nutzergruppen festlegen. Damit wird sichergestellt, dass Gesamtausgaben-Volumen nicht überschritten werden. Eine detaillierte Anleitung zur Konfiguration erscheint demnächst im Abschnitt Administration der Dokumentation.
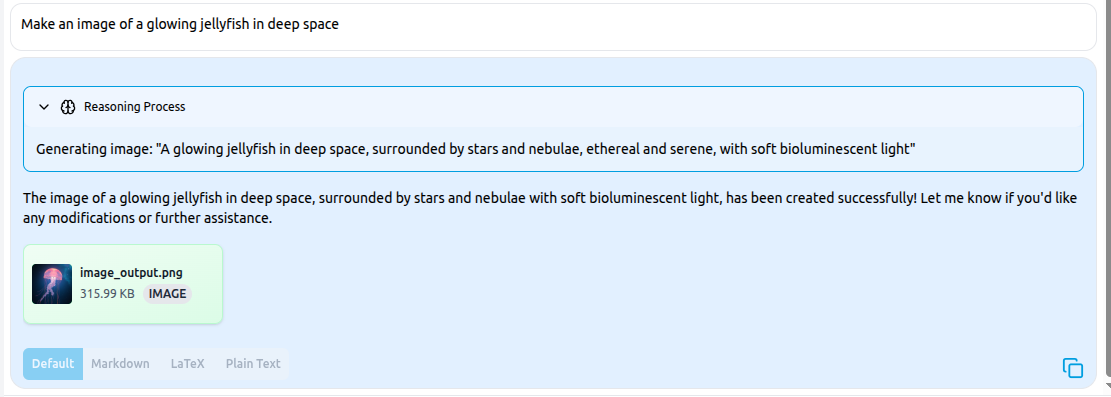
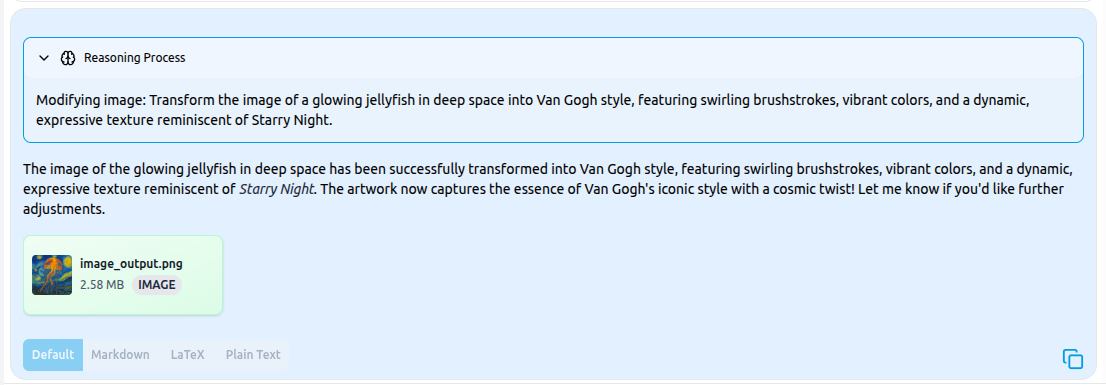
Image AI ist ein generativer KI-Tool zur Erstellung visueller Inhalte. Er unterstützt die Text-zu-Bild-Generierung, bei der eine natürlichsprachliche Beschreibung in ein neues Bild umgewandelt wird, sowie die Bild-zu-Bild-Transformation, bei der ein bestehendes Bild anhand eines Prompts oder eines Stilbeispiels verändert oder neu gestaltet wird. Wie bei anderen GWDG-Diensten werden die Nutzerdaten sicher gehalten und nicht gespeichert oder zur Weiterbildung von KI-Modellen verwendet. Die einfache, benutzerfreundliche Web-Oberfläche erleichtert das Erstellen und Speichern von Bildern.
Aktuelle Modelle
Image-AI bietet moderne Open-Weight Modelle, die auf unserer Plattform mit hohen Standards zum Datenschutz gehostet werden. Die Daten, die an diese Modelle gesendet werden - einschließlich der Prompts und Bilder - werden an keiner Stelle in unseren Systemen gespeichert.
Verfügbare Modelle werden regelmäßig aktualisiert, sobald neuere, leistungsfähigere Versionen veröffentlicht werden. Wir wählen Modelle für unsere Dienste basierend auf Nutzerbedarf, Kosten und Leistung in verschiedenen Benchmarks. Bestimmte Modelle sind für spezifische Aufgaben besonders gut geeignet, was unten nach bestem Wissen beschrieben wird.
Bild-zu-Bild, semantische und optische Bearbeitung
Unterabschnitte von Image AI
Grundwissen
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zur grundlegendem Wissen zu diesem KI-Dienst.
Unser Angebot
Open-Weight Modelle zur Bilderzeugung, gehostet von GWDG
FLUX.1-schnell
FLUX.1-schnell ist ein schnelles, leistungsstarkes Text-zu-Bild-Generationsmodell, das auf Geschwindigkeit optimiert ist, während gleichzeitig eine hohe visuelle Qualität erhalten bleibt. Dieses Modell wurde von Black Forest Labs entwickelt.
Wichtige Fähigkeiten:
Schnelle Generierung von Bildern aus Textprompts.
Erhält trotz Fokus auf Geschwindigkeit eine kohärente Komposition und Stil.
Unterstützt vielfältige künstlerische und fotorealistische Ausgaben.
Gut in der Darstellung komplexer Szenen mit angemessener Treue.
Das Qwen-Image-Edit-2511-Modell nimmt Bilder und einen Textprompt als Eingabe. Sie können ein Bild hochladen und es bearbeiten, indem Sie eine Textbeschreibung als Prompt angeben. Seine Fähigkeiten für sowohl semantische als auch optische Bearbeitung machen dieses Modell zu einem leistungsfähigen Werkzeug zur Bildbearbeitung. Ein weiteres wichtiges Merkmal ist die Möglichkeit, Text innerhalb Ihres hochgeladenen Bildes hinzuzufügen, zu löschen oder zu ändern. Weitere Informationen zu diesem Modell finden Sie auf dieser Seite.
Beschaffung
Info
Image AI ist aktuell in den Chat AI Verträgen als Bonusleistung ohne Zusatzkosten enthalten. Während dieser Testphase des Dienstes git es keinen rechtlichen Anspruch auf die kostenlose Dienstleistung.
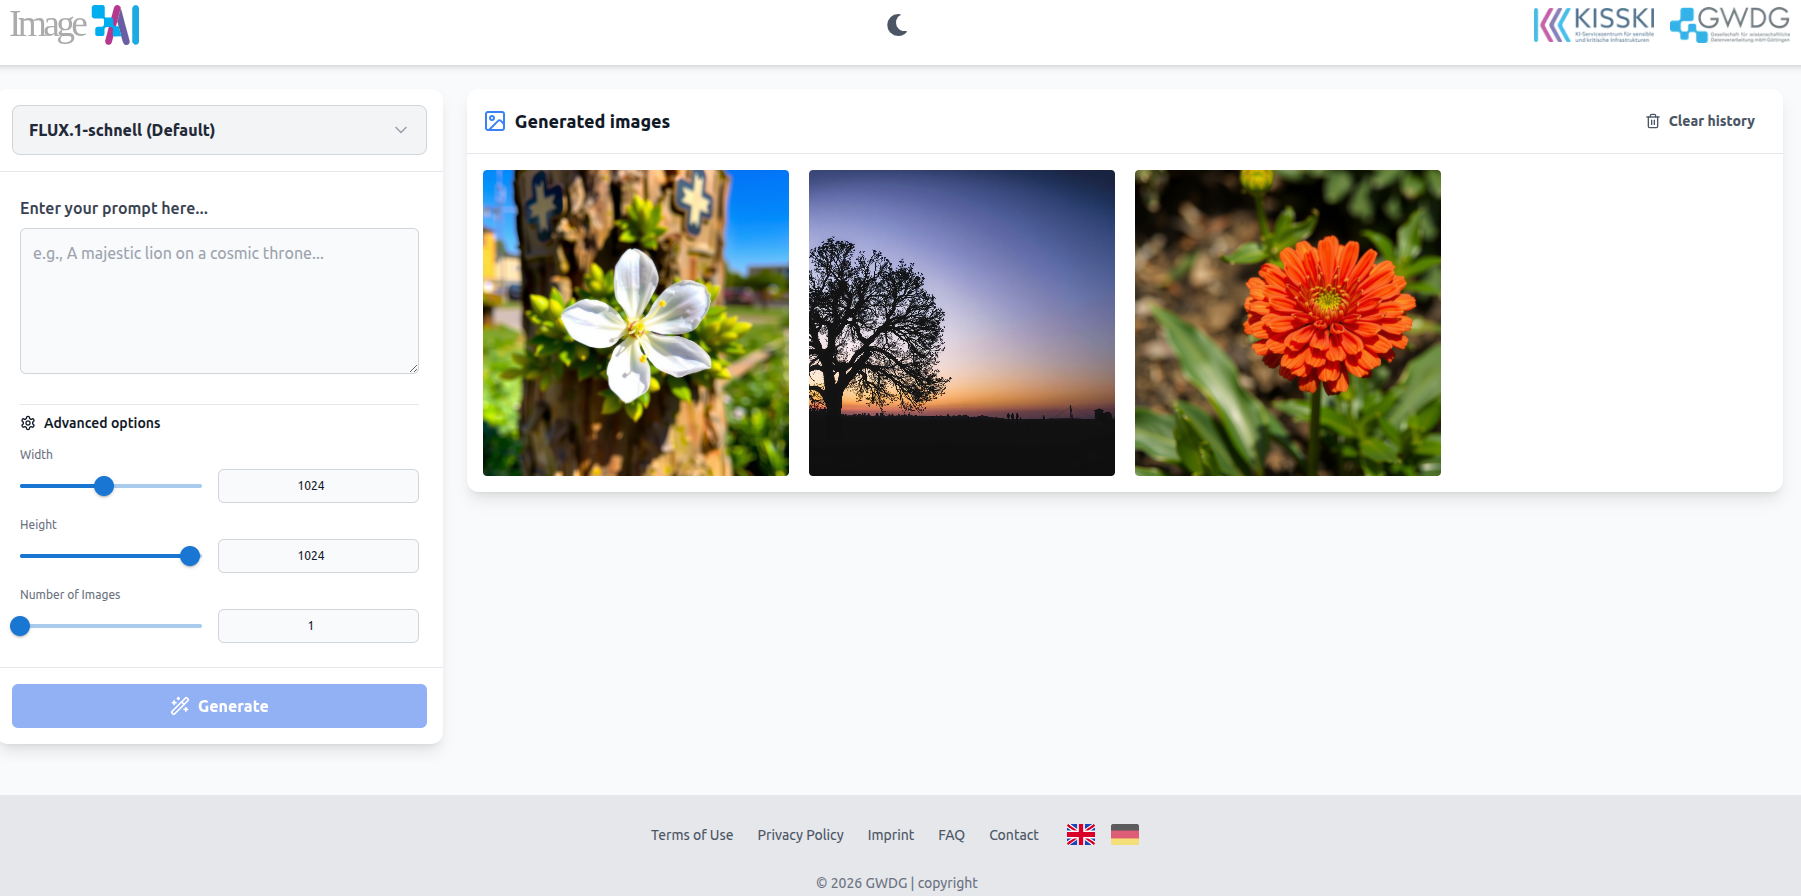
Hier ist eine kurze Beschreibung der Komponenten der Web-Oberfläche:
Modellauswahl: Wählen Sie das Modell aus, das Sie verwenden möchten.
Prompt: Geben Sie Ihre Textbeschreibung ein, um ein Bild zu generieren.
Hochladen: Laden Sie ein Bild hoch, um es mit dem Bild-zu-Bild-Modell zu bearbeiten.
Erweiterte Optionen: Legen Sie Breite, Höhe und Anzahl der Ausgabebilder fest.
Entwicklerdokumentation
Info
An dieser Stelle ergänzen wir in Kürze die Entwicklerdokumentation dieses KI-Dienstes.
Administration
Info
Image AI befindet sich in der Testphase und ist noch kein kostenpflichtiger Dienst. Entsprechend gibt es noch keine Notwendigkeit Budgets und Zugriff zu steuern.
Wir werden die die Dokumentation an dieser Stelle ergänzen, sobald Funktionen für Administration für dieses KI-Dienstes implementiert sind.
SAIA Plattform
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu diesem KI-Dienst.
Die aktuelle Beschreibung des Dienstes mit allen relevanten Informationen finden Sie in unserer GWDG HPC Dokumentation.
Unterabschnitte von SAIA Plattform
Grundwissen
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zur grundlegendem Wissen zu diesem KI-Dienst.
Unser Angebot
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zur unserem Angebot zu diesem KI-Dienst.
Beschaffung
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Beschaffung dieses KI-Dienstes.
Kurz-Anleitung
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Kurz-Anleitung dieses KI-Dienstes.
Entwicklerdokumentation
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Entwicklerdokumentation dieses KI-Dienstes.
Administration
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Administration dieses KI-Dienstes.
Voice AI
Info
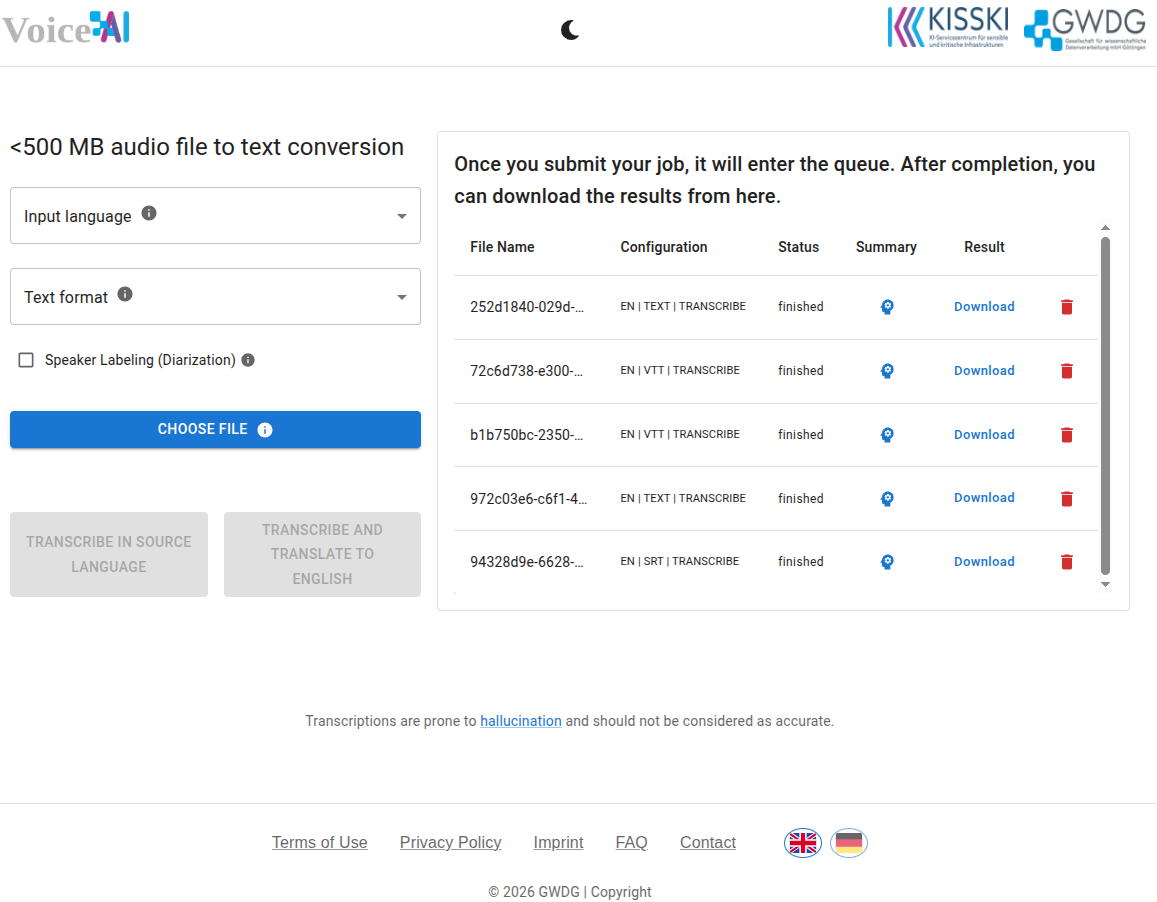
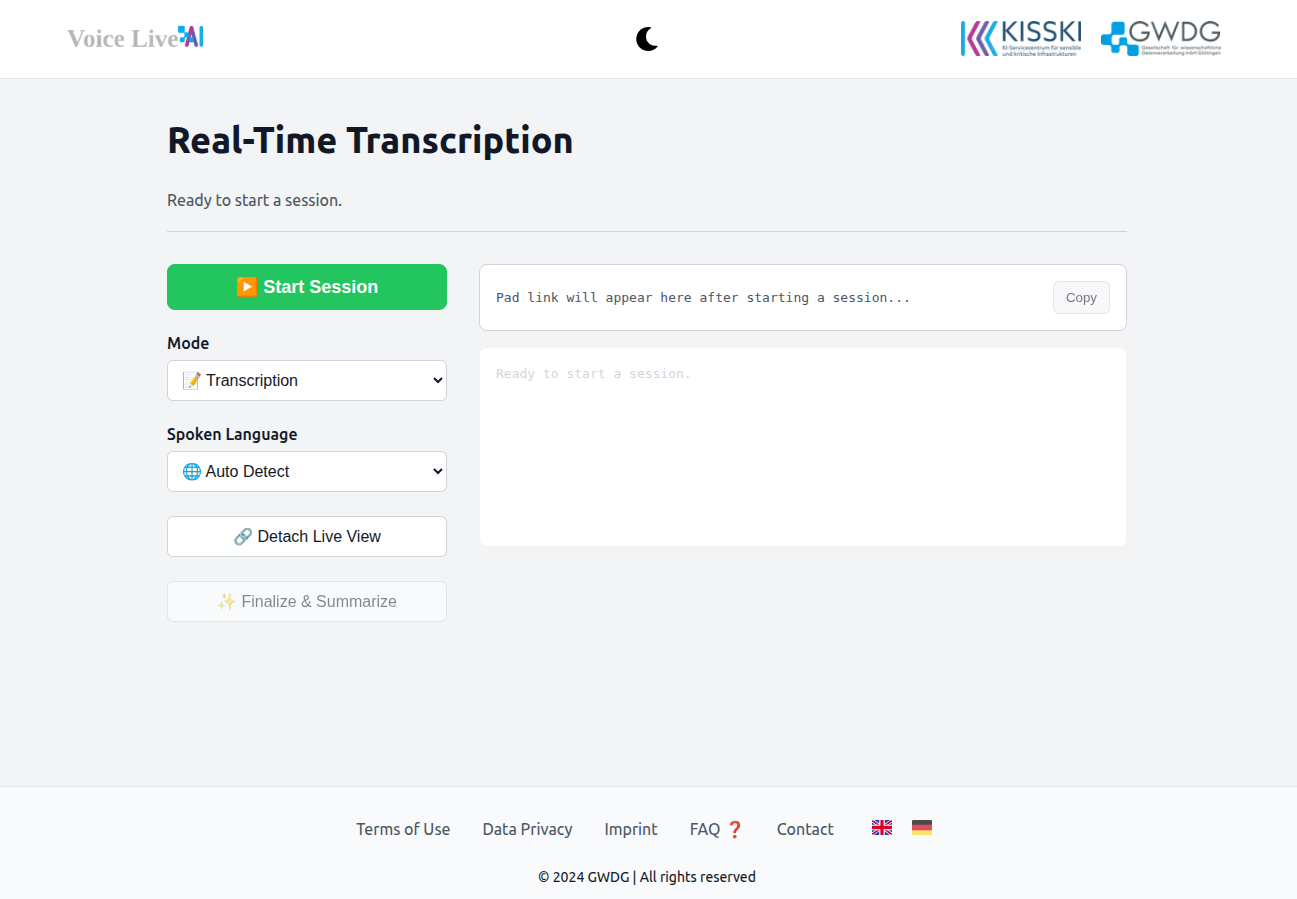
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu diesem KI-Dienst.
Die aktuelle Beschreibung des Dienstes mit allen relevanten Informationen finden Sie in unserer GWDG HPC Dokumentation.
Unterabschnitte von Voice AI
Grundwissen
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zur grundlegendem Wissen zu diesem KI-Dienst.
Unser Angebot
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zur unserem Angebot zu diesem KI-Dienst.
Beschaffung
Info
Voice AI ist aktuell in den Chat AI Verträgen als Bonusleistung ohne Zusatzkosten enthalten. Während dieser Testphase des Dienstes git es keinen rechtlichen Anspruch auf die kostenlose Dienstleistung.
Kurz-Anleitung
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Kurz-Anleitung dieses KI-Dienstes.
Entwicklerdokumentation
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Entwicklerdokumentation dieses KI-Dienstes.
Administration
Info
An dieser Stelle ergänzen wir in Kürze die Dokumentation zu der Administration dieses KI-Dienstes.
Beschaffung
Produkt-Anfragen
Voraussetzungen
Es gibt verschiedene Zugangspunkte zu unseren KI-Services. Im Allgemeinen erfolgt der Zugang über unser Web-Frontend innerhalb der Academic Cloud. Zumindest Ihr Institutionsadministrator benötigt ein Konto innerhalb der Academic Cloud – die Academic ID.
Eine Video-Anleitung zur Erstellung einer Academic ID finden Sie auf der kisski Website.
Um anzufragen, ob Ihre Institution Zugang zur Academic Cloud erhalten kann, wenden Sie sich bitte an die Academic Cloud Website hier.
Anfrage Inhalte
Bitte fügen Sie Ihrer Anfrage folgende Informationen bei:
Name und Anschrift Ihrer Einrichtung
Zugangspunkt (siehe unten)
Ansprechpartner und Kontaktdaten in Ihrer Einrichtung
Sind sie bereits Kunde der Academic Cloud?
Wenn Sie Neukunde sind: Verfügt Ihre Einrichtungen über einen Identity-Provider, wenn ja welcher Art?
Für welche Angebote fragen Sie an und mit welcher SpezifikationDetails
Beispiel:
- Chat AI Prepaid in Kategorie AC3.1 mit Vollzugriff
- Chat AI Externe Modelle Flexible mit Vollzugriff, Soft-Limit 4.000,- € monatlich, Hard-Limit 5.000,- € monatlich
Wieviele berechtigte Accounts benötigt Ihre Einrichtung maximal?
Welche Besonderheiten sind für Ihre Einrichtung zu berücksichtigen
Wie ist UmsatzsteuerID Ihrer Einrichtung
Zugangspunkt über Academic Cloud
Bitte senden Sie Ihre Anfrage wie oben beschrieben an support@gwdg.de.
Zugangspunkt über DFN
Wenn Sie über unsere Partnerschaft mit dem DFN auf die KI-Services zugreifen möchten, müssen Sie zudem die entsprechenden Verträge zwischen Ihnen, der GWDG und dem DFN unterzeichnen. Bitte fügen Sie Ihrer Anfrage an support@gwdg.de unter Besonderheiten hinzu, dass sie eine Beauftragung über den DFN planen. Wir stellen Ihnen dann die notwendigen Dokumente und Anweisungen zur Unterzeichnung der Verträge zur Verfügung.
Zugangspunkt über KI:Connect
Über KI:Connect erfoolgt die Nutzung unserer Dienste via API-Endpunkt. Bitte fügen Sie Ihrer Anfrage an support@gwdg.de unter Besonderheiten hinzu, dass sie die Nutzung über KI:Connect planen.
Rechtlich besteht KEINE Notwendigkeit, eine AVV mit uns abzuschließen, es ist jedoch nützlich, falls jemand versehentlich personenbezogene Daten gemäß DSGVO eingibt.
Institutionen, die im Rahmen unserer Partnerschaft mit KI:Connect auch Zugang zu externen Modellen via API nutzen, benötigen einen zusätzlichen API-Schlüssel. Bitte kontaktieren Sie hierfür kisski-support@gwdg.de.
Unterabschnitte von Beschaffung
Chat AI Free
Chat AI Free
Chat AI Free gewährt Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen für Test- und Evaluierungszwecke. Alle Nutzenden müssen über eine Academic ID und eine gültige E-Mail-Adresse verfügen. Der Dienst ist kostenlos und kann auf individueller Basis in Anspruch genommen werden.
Einschränkungen für Chat AI Free
Für die kostenlose Variante werden minimale Cluster-Ressourcen zugewiesen.
Reduzierte Liste verfügbarer Open Weight KI-Modelle
Für „Chat AI Free" gibt es keinen zusätzlichen Vertrag. Nutzende müssen unsere Nutzungsbedingungen unter den angegebenen Links akzeptieren.
Chat AI Prepaid
Chat AI Prepaid
Chat AI Prepaid gewährt Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen. Es richtet sich an Organisationen, die feste Budgets und jährliche Zahlungspläne wünschen und gleichzeitig während eines laufenden Vertragszyklus eine gewisse Budgetflexibilität bewahren möchten. Der Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen.
Die Nutzung der KI-Modelle über unsere Weboberfläche oder per API ist optional.
Es gibt Verträg für „Chat AI Prepaid" in mehreren Varianten:
Wahl des Academic Cloud Benutzerkontingents
Der Academic Cloud Basis-Vertrag definiert die maximale Anzahl von Benutzern für Ihre Organisation, die ein Academic Cloud-Konto registrieren dürfen. Für den Chat AI Prepaid-Vertrag kann das Kontingent frei gewählt werden. Die empfohlene Benutzerzahl gibt an, wie viele Benutzer erfahrungsgemäß mit dem gegebenen Budget unterstützt werden können. Ihre spezifische Organisation kann basierend auf Ihren Bedürfnissen ein anderes Kontingent wählen. Das Academic Cloud Benutzerkontingent ist im Preis des Chat AI Prepaid-Vertrags nicht enthalten und muss separat bestellt werden.
Preistabelle für Chat AI Prepaid
Kontingent
Empfohlene Benutzerzahl
€ pro Jahr
AC1.3
30
1.000
AC2.1
100
2.000
AC2.3
300
3.750
AC3.1
1.000
7.500
AC3.3
3.000
15.000
ACCampus
10.000
30.000
ACCampusPlus
30.000
60.000
ACCampusMax
100.000
100.000
Wahl zwischen Vollzugriff und Nur-API-Zugriff
Vollzugriff: Die Organisation kann die KI-Modelle über unsere Weboberfläche und/oder per API nutzen.
Nur-API-Zugriff: Die Organisation kann die KI-Modelle nur via API nutzen.
Ein Academic Cloud Basis-Vertrag ist für diese Option weiterhin erforderlich, um die Administratoren der Organisation zu registrieren.
Zusätzliche Dokumente für den Vertrag
Auftragsdatenverarbeitung (AVV) mit der GWDG
Datenschutzbeauftragte und weisungsberechtigte Personen
Fachverantwortliche für das IDM
Alle Vertragsunterlagen werden mit dem Angebot zur Verfügung gestellt.
Chat AI Flexible gewährt Zugang zu den von der GWDG gehosteten Open-Weight-Models in Göttingen. Es richtet sich an Organisationen, die monatliche Zahlungspläne für eine flexible Nutzung der KI-Modelle benötigen. Die üblichen Anwendungsfälle sind öffentlich zugängliche Anwendungen. Der Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen.
Die Nutzung der KI-Modelle über unsere Weboberfläche oder per API ist optional.
Es gibt Verträg für „Chat AI Flexible" in mehreren Varianten:
Wahl des Academic Cloud Benutzerkontingents
Der Academic Cloud Basis-Vertrag definiert die maximale Anzahl von Benutzern für Ihre Organisation, die ein Academic Cloud-Konto registrieren dürfen. Das Academic Cloud Benutzerkontingent ist im Preis des Chat AI Flexible-Vertrags nicht enthalten und muss separat bestellt werden.
Für den Chat AI Flexible-Vertrag gibt es kein Kontingent, das dem Academic Cloud Benutzerkontingent entspricht. Stattdessen definiert die Organisation Nutzungslimits, und die monatlichen Kosten werden basierend auf der tatsächlichen Nutzung berechnet (siehe unten).
Wahl der Chat AI Flexible Limits
Organisationen definieren monatliche Nutzungslimits für die KI-Modelle initial mit dem Vertrag. Diese Limits können nur über eine Support-Anfrage von Organisationsadministratoren geändert werden, die als weisungsberechtigt benannt wurden.
Soft Budget Limit obligatorisch: Die Organisation definiert ein Soft-Budget-Limit für die monatliche Nutzung der KI-Modelle. Wenn das Soft-Budget-Limit erreicht wird, wird die Organisation benachrichtigt. Das Soft-Budget-Limit dient als Warnung für die Organisation, dass sich die monatliche Nutzung einem bestimmten Wert nähert. Die Organisation kann dann entscheiden, die Nutzung der KI-Modelle fortzusetzen oder zu reduzieren. Sie kann auch entscheiden, das Hard-Budget-Limit (falls gesetzt) zu erhöhen, um zu verhindern, dass die Nutzung im aktuellen Monat gesperrt wird.
Hard Budget Limit empfohlen: Die Organisation kann ein Hard-Budget-Limit für die monatliche Nutzung der KI-Modelle definieren. Wenn das Hard-Budget-Limit erreicht wird, wird die Organisation benachrichtigt und die Nutzung der KI-Modelle wird bis zum nächsten Monat gesperrt. Das Hard-Budget-Limit dient dazu, unerwartete Kosten für die Organisation zu verhindern.
Wahl zwischen Vollzugriff und Nur-API-Zugriff
Vollzugriff: Die Organisation kann die KI-Modelle über unsere Weboberfläche und/oder per API nutzen.
Nur-API-Zugriff: Die Organisation kann die KI-Modelle nur via API nutzen.
Ein Academic Cloud Basis-Vertrag ist für diese Option weiterhin erforderlich, um die Administratoren der Organisation zu registrieren.
Zusätzliche Dokumente für den Vertrag
Auftragsdatenverarbeitung (AVV) mit der GWDG
Datenschutzbeauftragte und weisungsberechtigte Personen
Fachverantwortliche für das IDM
Alle Vertragsunterlagen werden mit dem Angebot zur Verfügung gestellt.
Abrechnung
Die Abrechnung basiert auf der tatsächlichen Nutzung der KI-Modelle gemäß der aktuellen Preisliste.
Die Abrechnung beginnt ab einem Mindestverbrauch von Token im Wert von 1.000,- € netto.
Wenn der Tokenverbrauch 1.000,- € netto übersteigt, beginnt die monatliche Abrechnung.
Der Rechnungsbetrag entspricht dem Nutzungsvolumen des Vormonats (oder 1.000 €, wenn das Nutzungsvolumen erreicht wurde), zuzüglich des Nutzungsvolumens des Vormonats als Vorauszahlung.
Wenn die tatsächliche Nutzung des aktuellen Monats geringer ist als die Vorauszahlung des Vormonats, wird die Differenz auf den nächsten Monat übertragen.
Chat AI Prepaid gewährt Zugang zu den extern gehosteten KI-Modellen. Es richtet sich an Organisationen, die feste Budgets und jährliche Zahlungspläne wünschen und gleichzeitig während eines laufenden Vertragszyklus eine gewisse Budgetflexibilität bewahren möchten. Der Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen.
Die Nutzung der KI-Modelle über unsere Weboberfläche oder per API ist optional.
Es gibt Verträg für „Chat AI Externe Modelle Prepaid" in mehreren Varianten:
Wahl des Academic Cloud Benutzerkontingents
Der Academic Cloud Basis-Vertrag definiert die maximale Anzahl von Benutzern für Ihre Organisation, die ein Academic Cloud-Konto registrieren dürfen. Für den Chat AI Prepaid-Vertrag kann das Kontingent frei gewählt werden. Die empfohlene Benutzerzahl gibt an, wie viele Benutzer erfahrungsgemäß mit dem gegebenen Budget unterstützt werden können. Ihre spezifische Organisation kann basierend auf Ihren Bedürfnissen ein anderes Kontingent wählen. Das Academic Cloud Benutzerkontingent ist im Preis des Chat AI Prepaid-Vertrags nicht enthalten und muss separat bestellt werden.
Preistabelle für Chat AI Prepaid
Kontingent
Empfohlene Benutzerzahl
€ pro Jahr
AC1.3
30
1.000
AC2.1
100
2.000
AC2.3
300
3.750
AC3.1
1.000
7.500
AC3.3
3.000
15.000
ACCampus
10.000
30.000
ACCampusPlus
30.000
60.000
ACCampusMax
100.000
100.000
Wahl zwischen Vollzugriff und Nur-API-Zugriff
Vollzugriff: Die Organisation kann die KI-Modelle über unsere Weboberfläche und/oder per API nutzen.
Nur-API-Zugriff: Die Organisation kann die KI-Modelle nur via API nutzen.
Ein Academic Cloud Basis-Vertrag ist für diese Option weiterhin erforderlich, um die Administratoren der Organisation zu registrieren.
Zusätzliche Dokumente für den Vertrag
Auftragsdatenverarbeitung (AVV) mit der GWDG
Datenschutzbeauftragte und weisungsberechtigte Personen
Fachverantwortliche für das IDM
Alle Vertragsunterlagen werden mit dem Angebot zur Verfügung gestellt.
Chat AI Externe Modelle Flexible gewährt Zugang zu extern gehosteten KI-Modellen. Es richtet sich an Organisationen, die monatliche Zahlungspläne für eine flexible Nutzung der KI-Modelle benötigen. Die üblichen Anwendungsfälle sind öffentlich zugängliche Anwendungen und interne Tools mit variabler Nutzung. Der Vertrag ist für 12 Monate gültig und kann auf Anfrage verlängert werden. Die Organisation muss zudem einen Academic Cloud Basis-Vertrag unterzeichnen.
Die Nutzung der KI-Modelle über unsere Weboberfläche oder per API ist optional.
Es gibt Verträg für „Chat AI Externe Modelle Flexible" in mehreren Varianten:
Wahl des Academic Cloud Benutzerkontingents
Der Academic Cloud Basis-Vertrag definiert die maximale Anzahl von Benutzern für Ihre Organisation, die ein Academic Cloud-Konto registrieren dürfen. Das Academic Cloud Benutzerkontingent ist im Preis des Chat AI Externe Modelle Flexible-Vertrags nicht enthalten und muss separat bestellt werden.
Für den Chat AI Externe Modelle Flexible-Vertrag gibt es kein Kontingent, das dem Academic Cloud Benutzerkontingent entspricht. Stattdessen definiert die Organisation Nutzungslimits, und die monatlichen Kosten werden basierend auf der tatsächlichen Nutzung berechnet (siehe unten).
Wahl der Chat AI Externe Modelle Limits
Organisationen definieren monatliche Nutzungslimits für die KI-Modelle initial mit dem Vertrag. Diese Limits können nur über eine Support-Anfrage von Organisationsadministratoren geändert werden, die als weisungsberechtigt benannt wurden.
Soft Budget Limit obligatorisch: Die Organisation definiert ein Soft-Budget-Limit für die monatliche Nutzung der KI-Modelle. Wenn das Soft-Budget-Limit erreicht wird, wird die Organisation benachrichtigt. Das Soft-Budget-Limit dient als Warnung für die Organisation, dass die monatliche Nutzung sich einem bestimmten Wert nähert. Die Organisation kann dann entscheiden, die Nutzung der KI-Modelle fortzusetzen oder zu reduzieren. Sie kann auch entscheiden, das Hard-Budget-Limit (falls gesetzt) zu erhöhen, um zu verhindern, dass die Nutzung im aktuellen Monat gesperrt wird.
Hard Budget Limit empfohlen: Die Organisation kann ein Hard-Budget-Limit für die monatliche Nutzung der KI-Modelle definieren. Wenn das Hard-Budget-Limit erreicht wird, wird die Organisation benachrichtigt und die Nutzung der KI-Modelle wird bis zum nächsten Monat gesperrt. Das Hard-Budget-Limit dient dazu, unerwartete Kosten für die Organisation zu verhindern.
Wahl zwischen Vollzugriff und Nur-API-Zugriff
Vollzugriff: Die Organisation kann die KI-Modelle über unsere Weboberfläche und/oder per API nutzen.
Nur-API-Zugriff: Die Organisation kann die KI-Modelle nur via API nutzen. Ein Academic Cloud Basis-Vertrag ist für diese Option weiterhin erforderlich, um die Administratoren der Organisation zu registrieren.
Zusätzliche Dokumente für den Vertrag
Auftragsdatenverarbeitung (AVV) mit der GWDG
Datenschutzbeauftragte und weisungsberechtigte Personen
Fachverantwortliche für das IDM
Alle Vertragsunterlagen werden mit dem Angebot zur Verfügung gestellt.
Die Abrechnung beginnt bei einem Mindestverbrauch von Token im Wert von 1.000,- € netto.
Wenn der Tokenverbrauch 1.000,- € netto übersteigt, beginnt die monatliche Abrechnung.
Der Rechnungsbetrag entspricht dem Nutzungsvolumen des Vormonats (oder 1.000 €, wenn das Nutzungsvolumen erreicht wurde), zuzüglich des Nutzungsvolumens des Vormonats als Vorauszahlung.
Wenn die tatsächliche Nutzung des aktuellen Monats geringer ist als die Vorauszahlung des Vormonats, wird die Differenz auf den nächsten Monat übertragen.
Die Preistabelle zeigt nur beispielhafte Preise und ist nicht bindend. Wir finalisieren aktuell die Performancetests für die verschiedenen Modelle und werden die gültigen Preise demnächst hier bekannt geben.
Tipp
Die Preise für die Nutzung unserer externen Modelle erfahren Sie bei dem jeweiligen externen Anbieter unter folgenden Links:
Hintergrundinformationen zur Berechnung der Preise finden sie unter Token Kostenberechnung.
Administration
Info
Für Organisations-Admins bieten wir verschiedene Instrumente für Zugriffssteuerung und Kostenkontrolle an. Über das IDM-Portal können Budget-Limits festgelegt werden, über das SAIA Dashboard können API-Keys verwaltet werden. Übersichten über die organisationsweite Nutzung und entstandene Kosten werden aktuell von uns erarbeitet.
Wir werden die Dokumentation zur Steuerung von Budgets und API-Keys durch Organisations-Admins in diesem Abschnitt demnächst erläutern.
Der Zugriff auf diesen Dienst erfordert eine Academic-Cloud-ID. Die Nutzung einer Academic-Cloud-ID unterliegt der Annahme der Nutzungsbedingungen der “Academic Cloud”.
§3 Autorisierte Nutzung
Benutzer sind verpflichtet, die Technologie oder Dienste ausschließlich für autorisierte und rechtmäßige Zwecke zu nutzen, indem sie alle geltenden Gesetze, Vorschriften und Rechte anderer einhalten, einschließlich nationaler, bundesstaatlicher, staatlicher, lokaler und internationaler Gesetze.
§4 Entwicklung
Sie erkennen an, dass wir ähnliche Software, Technologie oder Informationen von anderen Quellen entwickeln oder beschaffen können. Diese Anerkennung begründet keine Einschränkungen unserer Entwicklungs- oder Wettbewerbsbemühungen.
§5 Updates
Die GWDG wird durch regelmäßge Updates, die innerhalb und außerhalb des dedizierten Wartungsfensters der GWDG innerhalb vertratbarer Fristen stattfinden kann, den Service aktuell halten.
§6 Verbote
(1) Benutzer sind es untersagt, diesen Dienst zur Übertragung, Erzeugung und Verbreitung von Inhalten (Eingabe und Ausgabe) zu verwenden, die:
Kinderpornographie oder sexuellen Missbrauch darstellen, auch die Fälschung, Täuschung oder Nachahmung desselben;
sexuell explizit sind und für nicht-bildende oder nicht-wissenschaftliche Zwecke eingesetzt werden;
diskriminierend sind, Gewalt, Hassreden oder illegale Aktivitäten fördern;
Datenschutzgesetze verletzen, einschließlich der Sammlung oder Verbreitung personenbezogener Daten ohne Zustimmung;
betrügerisch, irreführend, schädlich oder täuschend sind;
Selbstverletzung, Belästigung, Mobbing, Gewalt und Terrorismus fördern;
illegale Aktivitäten fördern oder geistige Eigentumsrechte und andere rechtliche und ethische Grenzen im Online-Verhalten verletzen;
versuchen, unsere Sicherheitsmaßnahmen zu umgehen oder Handlungen zu veranlassen, die etablierte Richtlinien vorsätzlich verletzen;
Einzelpersonen, insbesondere in Bezug auf sensible oder geschützte Merkmale, ungerechtfertigt oder nachteilig beeinflussen könnten;
(2) Benutzern ist es untersagt, folgende Aktivitäten durchzuführen:
Reverse-Engineering, Dekompilierung oder Disassemblierung der Technologie;
Unautorisierte Aktivitäten wie Spamming, Malware-Verbreitung oder störende Verhaltensweisen, die die Dienstqualität beeinträchtigen;
Modifizierung, Kopie, Vermietung, Verkauf oder Verbreitung unseres Dienstes;
Nachverfolgung oder Überwachung von Einzelpersonen ohne deren ausdrückliche Zustimmung.
(3) Geschützte Daten oder vertrauliche Information zu verarbeiten, insofern nicht die rechtliche Rahmenbedingungen erfüllt sind.
Der Dienst ist zwar technisch dafür konzipiert sensible Daten verarbeiten zu können, d.h. Daten die u.a.
vertrauliche oder sensible Informationen enthalten;
sensible oder kontrollierte Daten beinhalten, etwa besonders geschützte Daten wie in Artikel 9(1) DSGVO gelistet;
oder Forschung mit menschlichen Probanden;
Allerdings muss der notwendige Rechtsrahmen bestehen oder geschaffen werden, um die rechtmäßige Verarbeitung sicherzustellen. Dies kann beispielsweise die Schließung eines Auftragsverarbeitungsvertrags gemäß Art. 28 DSGVO erfordern.
(4) Wenn Sie diesen Dienst im Auftrag einer Organisation und nicht als Privatperson nutzen, so sollte ein Auftragsverarbeitungsvertrag zwischen ihrer Organisation und der GWDG geschlossen werden.
Sollten Unsicherheiten bzgl. Sicherheit oder Datenschutz des Dienstes vorhanden sein, so bitten wir um Kontakt des Datenschutzbeauftragen bei dem Mailpostfach support@gwdg.de mit dem Titel “Datenschutz KI Dienste”.
(5) Für Forschungszwecke könnten in bestimmten Fällen die Nutzungsszenarien in (1) gestattet sein. Hierbei müssen für den Einsatszweck begrenzten Fälle schriftliche Absprachen zwischen den Nutzenden und der GWDG getroffen werden.
(6) Insbesondere bei der Nutzung der serverseitigen RAG Systems dürfen in die Arcanas keine Kontextdaten hochgeladen werden, die unter (1) und (3) aufgeführt sind. Falls ein gültiger Rechtsrahmen besteht, der eine solche Nutzung zulässt, so haben individuelle Vertragsabreden vorrang.
§7 Beendigung und Aussetzung
(1) Sie können die Nutzung der KI Dienste und Ihre rechtlichen Beziehungen zu uns jederzeit beenden, indem Sie den Dienst nicht mehr nutzen. Wenn Sie ein Verbraucher in der EU sind, haben Sie das Recht, diese Bedingungen innerhalb von 14 Tagen nach Annahme durch Kontaktaufnahme mit dem Support zu widerrufen.
(2) Wir behalten uns das Recht vor, Ihren Zugriff auf die KI Dienste auszusetzen oder zu beenden oder Ihr Konto zu deaktivieren, wenn Sie gegen diese Nutzungsrichtlinien verstoßen, wenn dies zur Einhaltung gesetzlicher Vorschriften erforderlich ist oder wenn Sie durch die Nutzung unseres Dienstes ein Risiko oder Schaden für uns, unsere Nutzer oder Dritte darstellen.
(3) Wir werden Ihnen vor der Deaktivierung Ihres Kontos eine Benachrichtigung senden, es sei denn, dies ist nicht möglich oder gesetzlich erlaubt. Wenn Sie glauben, dass Ihr Konto irrtümlich gesperrt oder deaktiviert wurde, können Sie sich an den Support wenden, um dies anzufechten.
(4) Wir behalten uns das Recht vor, rechtliche Schritte zu ergreifen, um unsere geistigen Eigentumsrechte und die Sicherheit unserer Nutzer zu schützen. Bei Verletzung dieser Bedingungen oder bei der Ausübung illegaler Aktivitäten durch die Nutzung unseres Dienstes können zivilrechtliche Sanktionen, Schadensersatz, Verwaltungsstrafen, Strafverfolgung oder andere rechtliche Optionen verfolgt werden.
§8 Korrektheit der Ergebnisse
Die von unseren Diensten generierten Ausgaben sind nicht immer einzigartig, korrekt oder präzise. Sie können Ungenauigkeiten enthalten, selbst wenn sie detailliert erscheinen. Benutzer sollten sich nicht ausschließlich auf diese Ergebnisse verlassen, ohne ihre Genauigkeit unabhängig zu überprüfen. Darüber hinaus kann die von unseren Diensten bereitgestellte Information unvollständig oder veraltet sein, und einige Ergebnisse können nicht mit unseren Perspektiven übereinstimmen. Daher sollten Benutzer Vorsicht walten lassen und die Dienste nicht für wichtige Entscheidungen verwenden, insbesondere in Bereichen wie Medizin, Recht, Finanzen und anderen professionellen Bereichen, in denen Fachwissen unerlässlich ist. Es ist wichtig zu verstehen, dass KI und maschinelles Lernen ständig weiterentwickelt werden, und obwohl wir uns bemühen, die Genauigkeit und Zuverlässigkeit unserer Dienste zu verbessern, sollten Benutzer immer die Genauigkeit der Ergebnisse bewerten und sicherstellen, dass sie ihren spezifischen Anforderungen entsprechen, indem sie sie vor der Verwendung oder Verbreitung manuell überprüfen. Darüber hinaus sollten Benutzer davon absehen, Ergebnisse im Zusammenhang mit Einzelpersonen für Zwecke zu verwenden, die erhebliche Auswirkungen auf diese haben könnten, wie z.B. rechtliche oder finanzielle Entscheidungen. Schließlich sollten Benutzer sich bewusst sein, dass unvollständige, ungenaue oder anstößige Ergebnisse auftreten können, die nicht die Ansichten der GWDG oder ihrer verbundenen Parteien widerspiegeln.
§9 Haftungsbeschränkung
(1) Allgemeine Haftungsbeschränkung: Die GWDG übernimmt keinerlei Haftung für Schadensersatzansprüche von Nutzer:Innen basierend auf der Inanspruchnahme der KI Dienste. Die hier dargelegte und in den weiteren Abschnitten genauer erklärte Haftungsbeschränkung leitet sich daraus ab, dass die GWDG ausschließlich eine Platform zur Nutzung von KI Modellen bereitstellt. Die GWDG kann auf dieser Platform keinerlei technische Maßnahmen bereit stellen, um in die durch die KI Modelle generierten Antworten dergestalt einzugreifen, dass ein Schaden bei unsachgemäßer Nutzung durch die Nutzenden ausgeschlossen werden kann. Daher verbleibt die vollständige Haftung für Schadensersatzansprüche durch unsachgemäße Nutzung dieser Platform bei den Nutzenden.
Hiervon ausgenommen sind Ansprüche basierend auf der Verletzung von Leben, Körper, Gesundheit, durch grobem Verschulden oder durch vorsätzliche oder grob fahrlässige Pflichtverletzung. Ebenfalls ist die Verletzung von Kardinalpflichten vom grundsätzlichem Haftungsausschluss ausgeschlossen.
(2) Urheberrecht: Die Nutzer:Innen der KI Dienste haben die vollständige und alleinige Verantwortung die geltenden Bestimmmungen des Urheberrechts zu beachten und einzuhalten. Die GWDG weist die Nutzer:Innen explizit darauf hin, dass die bereitgestellten KI Modelle von Dritten trainiert wurden und der GWDG kein Erklärung vorliegt, die die verwendeten Materialien auf freie Lizenzen einschränkt. Es kann folglich von der GWDG nicht ausgeschlossen werden, dass die bereitgestellten KI Modelle mithilfe urheberrechtlich geschützter Inhalte trainiert wurden. Antworten, die die KI Modelle den Nutzer:Innen geben, können folglich urheberechtlich geschützte Inhalte beinhalten. Die GWDG weißt explizit die Nutzenden darauf hin, dass ein direktes Weiterverwenden von erhaltenen Antworten nicht empfohlen ist. Die Prüfung des Urheberrechts für solche Fälle liegt alleine bei den Nutzer:Innen. Die GWDG übernimmt keinerlei Hauftung für etwaige Schadensersatzansprüche aus Urheberrechtsverletzungen.
(3) Vertraulichen Informationen:
Wir können keine Haftung für Verlust/Veröffentlichung von Daten übernehmen, die die Nutzenden in Ihren Anfragen bereitstellen. Ausgenommen ist hiervon ein grobfahrlässiges Handeln sowie Kardinalpflichten.
(4) Patentrecht: Die Nutzer:Innen der KI Dienste haben die vollständige und alleinige Verantwortung die geltenden Bestimmmungen des Patentrechts zu beachten und einzuhalten. Antworten der bereitgestellten KI Modelle können in ihrer konzeptionellen Idee patentgeschützte Inhalte beinhalten. Die GWDG weißt explizit die Nutzenden darauf hin, dass ein direktes Weiterverwenden von Ideen und Konzepten die in den erhaltenen Antworten vermittelt werden, nicht empfohlen ist. Die Verantowrtung zur Prüfung des Patentschutzes für solche Fälle liegt alleine bei den Nutzer:Innen. Die GWDG übernimmt keinerlei Hauftung für etwaige Schadensersatzansprüche aus Patentverletzungen.
(5) Fehlinformationen: Die GWDG weist die Nutzer:Innen der KI Dienste darauf hin, dass es eine intrinsische Eigenschaft der bereitgestellten KI Modelle ist, sich Inhalte frei auszudenken - dies firmiert bei KI Modellen unter dem Stichwort “Halluzination”. Die Informationen, die in den Antworten enthalten sind können veraltet, frei erfunden, unpassend, aus dem Kontext genommen, oder falsch sein. Dies stellt keine Fehlfunktionen der bereitgestellten Platform dar, da dies technisch von dem Werkzeug der KI Modelle zu erwarten ist. Die unabhängige und kritische Überprüfung der erhaltenen Informationen obliegt einzig und alleine der Nutzer:Innen. Die GWDG übernimmt keinerlei Haftung für die Informationen, die in den Antworten der KI Modelle steckt.
Weitere Information hierzu in “§8 Genauigkeit”.
(6) Bei der Nutzung des serverseitigen RAG Systems tragen die Nutzer:Innen die alleinige Verantwortung für die Rechtmäßigkeit der Dokumente, die sie in die Arcanas hochladen, abspeichern und indizieren. Die GWDG übernimmt keinerlei Haftung für die Dokumente, die von den Nutzer:Innen in das RAG System hochgeladen wurden.
§10 Dienstleistungen von Drittanbietern
Unsere Dienstleistungen können die Integration von Software, Produkten oder Dienstleistungen von Drittanbietern umfassen, die als “Dienstleistungen von Drittanbietern” bezeichnet werden. Diese können Ausgaben liefern, die von diesen Dienstleistungen stammen, die als “Ausgaben von Drittanbietern” bekannt sind. Es ist wichtig zu verstehen, dass Dienstleistungen von Drittanbietern unabhängig arbeiten und von ihren eigenen Nutzungsbedingungen und -bestimmungen geregelt werden, die von unseren getrennt sind. Daher sollten Nutzer sich bewusst sein, dass wir nicht für Dienstleistungen von Drittanbietern oder deren zugehörige Nutzungsbedingungen und -bestimmungen verantwortlich sind. Wir kontrollieren diese Dienstleistungen nicht und sind daher nicht haftbar für Verluste oder Schäden, die durch deren Nutzung entstehen können. Nutzer entscheiden sich selbst dafür, mit Dienstleistungen von Drittanbietern zu interagieren, und übernehmen die volle Verantwortung für alle Ergebnisse, die sich daraus ergeben können. Darüber hinaus bieten wir keine Zusicherungen oder Garantien hinsichtlich der Leistung oder Zuverlässigkeit von Dienstleistungen von Drittanbietern.
§11 Feedback
Wir schätzen Ihr Feedback zu unseren Dienstleistungen und Produkten und ermutigen Sie, Ihre Gedanken zu teilen, um uns bei der Verbesserung zu helfen. Durch die Bereitstellung von Feedback verstehen Sie, dass wir es offenlegen, veröffentlichen, ausnutzen oder verwenden können, um unsere Angebote zu verbessern, ohne dass wir Ihnen eine Entschädigung schulden. Wir behalten uns das Recht vor, Feedback für jeden Zweck ohne Einschränkung durch Vertraulichkeitspflichten zu verwenden, unabhängig davon, ob es als vertraulich gekennzeichnet ist oder nicht.
§12 Datenschutz
Die Privatsphäre der Nutzeranfragen ist für uns von grundlegender Bedeutung. Weitere Information finden Sie in der Datenschutzerklärung.
§13 Schlussbestimmungen
Die Allgemeinen Geschäftsbedingungen bleiben auch bei rechtlicher Unwirksamkeit einzelner Punkte in ihren übrigen Teilen verbindlich und wirksam. Anstelle der unwirksamen Punkte treten, soweit vorhanden, die gesetzlichen Vorschriften. Soweit dies für eine Vertragspartei eine unzumutbare Härte darstellen würde, wird der Vertrag jedoch im Ganzen unwirksam.
Teil B: Service-Spezifische Module
B.1 ChatAI Externe Modelle
Externe Modelle (Azure, Research Partners, LUIS)
B.2 ImageAI Service
Durch die Nutzung des Dienstes sind die Nutzer sich bewusst, dass die Ausgabe des Dienstes KI-generiert ist. Der Dienst nutzt fortschrittliche Technologie der Künstlichen Intelligenz (KI), um Bilder aus Prompts zu generieren und Benutzeranweisungen und Parametern zu verarbeiten.
Ergänzung zu §8 Korrektheit der Ergebnisse Die von der KI erzeugten Ergebnisse sind möglicherweise nicht immer akkurat, vollständig oder zuverlässig. Die Nutzer erkennen dies an und stimmen zu:
Die KI-Funktionen für Bilderzeugung dienen der Unterstützung der Nutzer, sollten aber nicht ausschließlich für kritische Aufgaben verwendet werden.
Die Genauigkeit der von der KI generierten Inhalte kann in Abhängigkeit von Faktoren wie der Qualität des Inputs, der Komplexität der Sprache und der gewählten Parameter, Anweisungen und dem Kontext variieren.
Wie bei den meisten KI-Systemen, die allgemeine und unterschiedliche Aufgaben erfüllen, besteht auch bei diesem Dienst die Gefahr von „Halluzinationen“. In diesem Sinne können die von der KI generierten Bilder falsche oder irreführende Informationen enthalten, die als Fakten dargestellt werden.
Das Risiko von Vorurteilen (Bias) besteht auch beim Dienst. Die von der KI generierten Outputs könnten aufgrund der Trainingsdaten voreingenommen sein.
Menschliche Überwachung und Kontrollen seitens der Nutzer werden als erforderlich gesehen, um sicherzustellen, dass die Outputs zuverlässig sind und den Nutzer-Inputs entsprechen.
Ergänzung zu §9 Haftungsbeschränkung (2) Urheberrecht Der Plattformbetreiber ist Eigentümer aller geistigen Eigentumsrechte an dem Dienst, einschließlich, aber nicht beschränkt auf Software, Algorithmen, Geschäftsgeheimnisse und KI generierte Inhalte. Den Nutzern wird eine begrenzte, nicht exklusive und nicht übertragbare Lizenz zur Nutzung des Dienstes für die vorgesehenen Zwecke gewährt.
Die Nutzer sind verpflichtet, die Urheberrechts- und Eigentumshinweise und Lizenzen zu beachten und die unerlaubte Verbreitung oder Vervielfältigung von urheberrechtlich geschützten Inhalten zu verhindern. Der Plattformbetreiber behaltet sich das Recht vor, Inhalte, von denen er annimmt, dass sie Urheberrechte verletzen, zu entfernen oder zu sperren und die Konten von mutmaßlichen Verstößen zu deaktivieren.
B.3 VoiceAI Service
Ergänzung zu §8 Korrektheit der Ergebnisse Die von unseren Diensten generierten Ergebnisse sind möglicherweise nicht immer eindeutig, vollständig korrekt oder präzise. Sie können Ungenauigkeiten enthalten, selbst wenn sie detailliert erscheinen. Benutzer sollten sich nicht ausschließlich auf diese Ergebnisse verlassen, ohne deren Richtigkeit unabhängig zu überprüfen. Darüber hinaus kann die Transkription, die unsere Dienste liefern, nicht immer vollständig oder genau sein. Daher sollten Benutzer Vorsicht walten lassen und die Dienste nicht allein für wichtige Entscheidungen nutzen. Es ist entscheidend, zu verstehen, dass KI und maschinelles Lernen ständig weiterentwickelt werden. Obwohl wir uns bemühen, die Genauigkeit und Zuverlässigkeit unserer Dienste zu verbessern, sollten Benutzer stets die Richtigkeit der Ergebnisse überprüfen und sicherstellen, dass sie ihren spezifischen Anforderungen entsprechen. Dies sollte vor der Nutzung oder Verbreitung durch menschliche Überprüfung erfolgen. Zudem sollten Benutzer darauf verzichten, Ergebnisse, die sich auf Personen beziehen, für Zwecke zu nutzen, die erhebliche Auswirkungen auf diese haben könnten, wie z. B. rechtliche oder finanzielle Entscheidungen. Schließlich sollten Benutzer wissen, dass unvollständige oder ungenaue Ergebnisse auftreten können, die nicht notwendigerweise die Ansichten von GWDG oder deren verbundenen Partnern widerspiegeln.
Ergänzung zu §9 Haftungsbeschränkung (2) Urheberrecht
Wir besitzen alle Rechte, Titel und Interessen an und in Bezug auf den Dienst.
Benutzer sind verpflichtet, Urheberrechte und andere Eigentumsrechte zu wahren und die unerlaubte Vervielfältigung oder Verbreitung urheberrechtlich geschützter Inhalte zu verhindern.
Wir behalten uns das Recht vor, Inhalte zu entfernen oder zu blockieren, die nach unserer Ansicht Urheberrechte verletzen, sowie die Konten wiederholter Verstöße zu deaktivieren.
Ergänzung zu §12 Datenschutz
Der Datenschutz Ihrer Anfragen ist uns von grundlegender Bedeutung. Daher speichern unsere Dienste Ihre Audio-/Gesprächsinhalte nicht auf dauerhafter Speicherung, außer bei BBB-Transkriptionen (zukünftiger Dienst), die in lokaler MySQL-Datenbank gespeichert werden, und bei Audio-Datei-Transkriptions-Ergebnissen, die auf unserem Datenübertragungs-Knoten gespeichert werden – beide werden nach 30 Tagen gelöscht. Die Anzahl der Anfragen pro Benutzer und die jeweiligen Zeitstempel werden protokolliert, um die Nutzung des Systems zu überwachen und Abrechnungen durchzuführen.
Zu technischen Zwecken sammelt der Webserver folgende Daten:
Zugriffsdatum
Name des auf dem Zugriffsgerät installierten Betriebssystems
Name des verwendeten Browsers
Quellsystem, über das der Zugriff erfolgt ist
IP-Adresse des Zugriffsgeräts
Diese Daten werden ebenfalls in den Logdateien unseres Systems gespeichert. Diese Daten werden nicht zusammen mit Ihren sonstigen personenbezogenen Daten gespeichert. Weitere detaillierte Informationen zum Datenschutz finden Sie in der Datenschutzerklärung, die Benutzer beim Nutzung dieses Dienstes akzeptieren müssen.
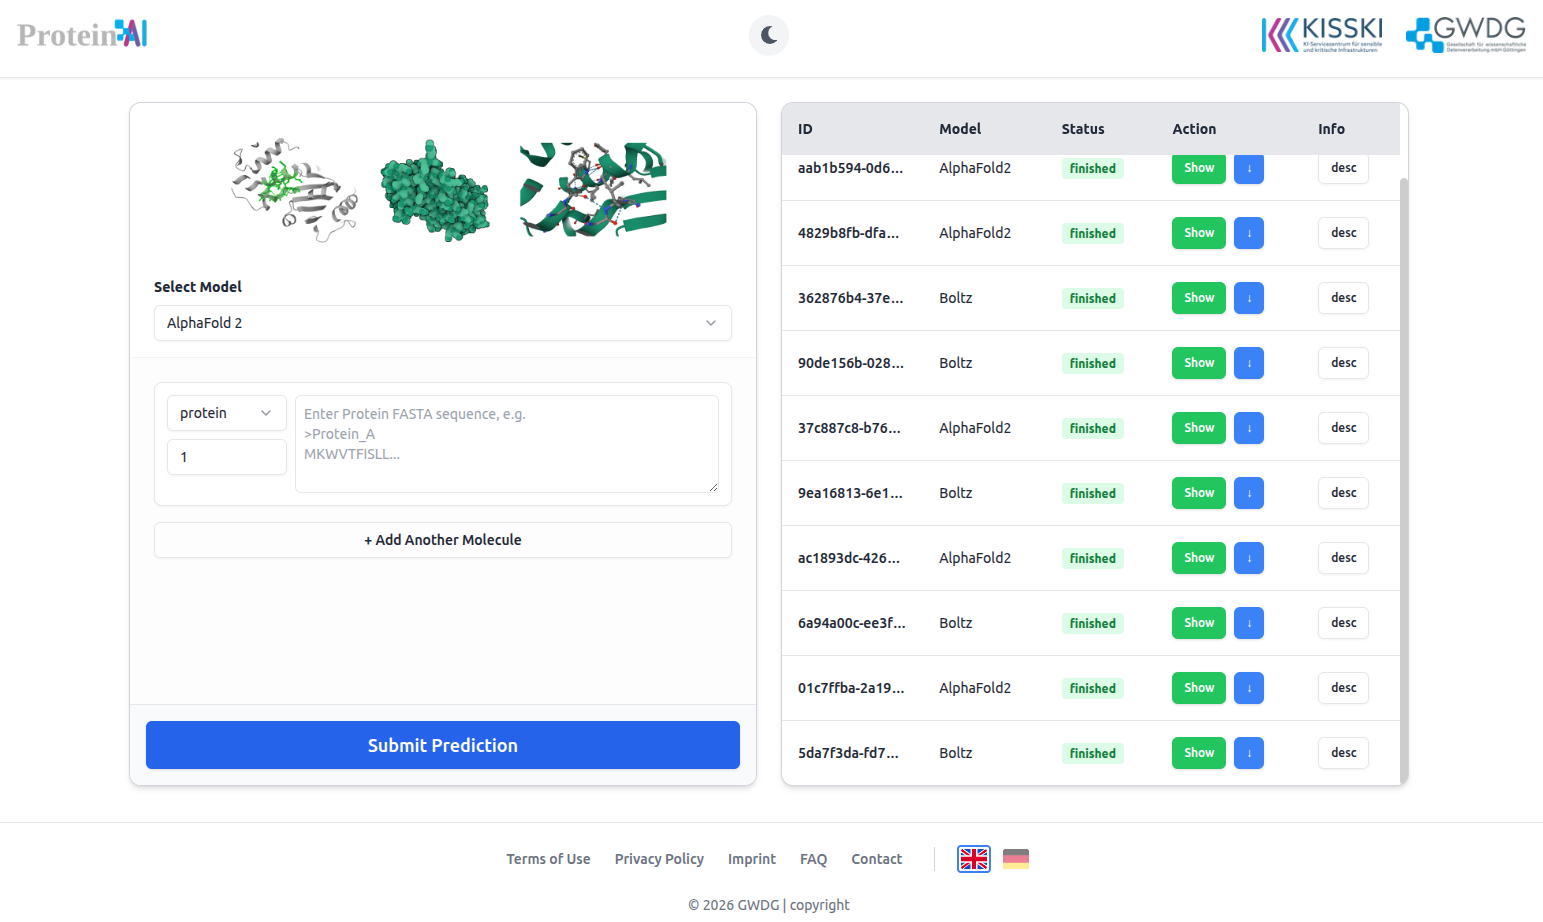
B.4 ProteinAI Service
Ergänzung zu §12 Datenschutz Der Datenschutz Ihrer Anfragen ist uns von grundlegender Bedeutung. Proteinsequenzen und vorhergesagte Strukturen werden temporär (für 30 Tage) auf dem GWDG-Server gespeichert. In dieser Zeit hat nur der jeweilige Benutzer Zugriff auf seine Daten. Wir greifen zu keinem Zeitpunkt ohne Zustimmung des Benutzers auf diese Daten auf unseren Servern zu. Die Anzahl der Anfragen pro Benutzer und die jeweiligen Zeitstempel werden protokolliert, um die Nutzung des Systems zu überwachen und Abrechnungen durchzuführen.
Zu technischen Zwecken sammelt der Webserver folgende Daten:
Zugriffsdatum
Name des auf dem Zugriffsgerät installierten Betriebssystems
Name des verwendeten Browsers
Quellsystem, über das der Zugriff erfolgt ist
IP-Adresse des Zugriffsgeräts
Diese Daten werden ebenfalls in den Logdateien unseres Systems gespeichert. Diese Daten werden nicht zusammen mit Ihren sonstigen personenbezogenen Daten gespeichert. Weitere detaillierte Informationen zum Datenschutz finden Sie in der Datenschutzerklärung, die Benutzer beim Nutzung dieses Dienstes akzeptieren müssen.
Datenschutzbestimmungen KI-Dienste
1. Allgemeine Informationen
(Gilt für alle Dienste)
Verantwortlich für die Datenverarbeitung
Der Verantwortliche für die Datenverarbeitung im Sinne des Art. 4 Nr. 7 DSGVO und anderer nationaler Datenschutzgesetze der Mitgliedsstaaten sowie sonstiger datenschutzrechtlicher Bestimmungen ist die:
Gesellschaft für wissenschaftliche Datenverarbeitung mbH Göttingen
Burckhardtweg 4
37077 Göttingen
Deutschland
Tel: +49 (0) 551 39-30001
E-Mail: support@gwdg.de
Website: www.gwdg.de
Vertreten durch den Geschäftsführer.
Verantwortliche Stelle ist die natürliche oder juristische Person, die allein oder gemeinsam mit anderen über die Zwecke und Mittel der Verarbeitung von personenbezogenen Daten entscheidet.
Ansprechpartner / Datenschutzbeauftragter
Gesellschaft für wissenschaftliche Datenverarbeitung mbH Göttingen
Datenschutzbeauftragter
Burckhardtweg 4
37077 Göttingen
Deutschland
Tel: +49 (0) 551 39-30001
E-Mail: support@gwdg.de
Zweck der Datenverarbeitung
Wir verarbeiten personenbezogene Daten unserer Nutzer grundsätzlich nur soweit dies zur Bereitstellung einer funktionsfähigen Website sowie unserer Inhalte und Leistungen erforderlich ist.
Die Aufnahme von Nutzereingaben über unsere Website und die Verarbeitung von User-Inputs auf unserem System ist notwendig, um mit dem gewählten KI Dienst eine Antwort generieren zu können.
Die Speicherung in Logfiles erfolgt, um die Funktionalität der Website zu gewährleisten. Darüber hinaus helfen uns die Daten, die Website zu optimieren und die Sicherheit unserer IT-Systeme zu gewährleisten. Eine Nutzung der Daten zu Marketingzwecken findet in diesem Zusammenhang nicht statt.
Die Verarbeitung personenbezogener Daten unserer Nutzer erfolgt regelmäßig nur nach Einwilligung des Nutzers. Eine Ausnahme gilt in solchen Fällen, in denen eine vorherige Einholung einer Einwilligung aus tatsächlichen Gründen nicht möglich ist und die Verarbeitung der Daten durch gesetzliche Vorschriften gestattet ist.
Rechtsgrundlage für die Verarbeitung personenbezogener Daten
Soweit wir für Verarbeitungsvorgänge personenbezogener Daten eine Einwilligung der betroffenen Person einholen, dient Art. 6 Abs. 1 lit. a EU-Datenschutzgrundverordnung (DSGVO) als Rechtsgrundlage.
Bei der Verarbeitung von personenbezogenen Daten, die zur Erfüllung eines Vertrages, dessen Vertragspartei die betroffene Person ist, dient Art. 6 Abs. 1 lit. b DSGVO als Rechtsgrundlage. Dies gilt auch für Verarbeitungsvorgänge, die zur Durchführung vorvertraglicher Maßnahmen erforderlich sind.
Soweit eine Verarbeitung personenbezogener Daten zur Erfüllung einer rechtlichen Verpflichtung erforderlich ist, der unser Unternehmen unterliegt, dient Art. 6 Abs. 1 lit. c DSGVO als Rechtsgrundlage.
Für den Fall, dass lebenswichtige Interessen der betroffenen Person oder einer anderen natürlichen Person eine Verarbeitung personenbezogener Daten erforderlich machen, dient Art. 6 Abs. 1 lit. d DSGVO als Rechtsgrundlage.
Ist die Verarbeitung zur Wahrung eines berechtigten Interesses unseres Unternehmens oder eines Dritten erforderlich und überwiegen die Interessen, Grundrechte und Grundfreiheiten des Betroffenen das erstgenannte Interesse nicht, so dient Art. 6 Abs. 1 lit. f DSGVO als Rechtsgrundlage für die Verarbeitung.
Rechte der betroffenen Personen
Ihnen stehen verschiedene Rechte in Bezug auf die Verarbeitung ihrer personenbezogenen Daten zu. Nachfolgend sind diese aufgeführt, zusätzlich sind Verweise auf die Artikel (DSGVO) bzw. Paragraphen (BDSG (2018)) mit detaillierteren Informationen angegeben.
Auskunftsrecht (DSGVO Art. 15, BDSG §34)
Sie können von dem Verantwortlichen eine Bestätigung darüber verlangen, ob personenbezogene Daten, die Sie betreffen, von uns verarbeitet werden. Dies schließt das Recht ein, Auskunft darüber zu verlangen, ob die betreffenden personenbezogenen Daten in ein Drittland oder an eine internationale Organisation übermittelt werden.
Recht auf Berichtigung (DSGVO Art. 16)
Sie haben ein Recht auf Berichtigung und/oder Vervollständigung gegenüber dem Verantwortlichen, sofern die verarbeiteten personenbezogenen Daten, die Sie betreffen, unrichtig oder unvollständig sind. Der Verantwortliche hat die Berichtigung unverzüglich vorzunehmen.
Recht auf Löschung / „Recht auf Vergessen werden“ / Recht auf Einschränkung der Verarbeitung (DSGVO Art. 17, 18, BDSG §35)
Sie haben das Recht, die unverzügliche Löschung ihrer personenbezogenen Daten vom Verantwortlichen zu verlangen. Alternativ können Sie die Einschränkung der Verarbeitung vom Verantwortlichen verlangen.
Einschränkungen sind in der DSGVO und dem BDSG unter den genannten Artikeln bzw. Paragraphen genannt.
Recht auf Unterrichtung (DSGVO Art. 19)
Haben Sie das Recht auf Berichtigung, Löschung oder Einschränkung der Verarbeitung gegenüber dem Verantwortlichen geltend gemacht, ist dieser verpflichtet, allen Empfängern, denen die Sie betreffenden personenbezogenen Daten offengelegt wurden, diese Berichtigung oder Löschung der Daten oder Einschränkung der Verarbeitung mitzuteilen, es sei denn, dies erweist sich als unmöglich oder ist mit einem unverhältnismäßigen Aufwand verbunden.
Ihnen steht gegenüber dem Verantwortlichen das Recht zu, über diese Empfänger unterrichtet zu werden.
Recht auf Datenübertragbarkeit (DSGVO Art. 20)
Sie haben das Recht, die Sie betreffenden personenbezogenen Daten, die Sie dem Verantwortlichen bereitgestellt haben, in einem strukturierten, gängigen und maschinenlesbaren Format zu erhalten.
Ergänzend zur DSGVO ist festzustellen, dass sich die Datenübertragbarkeit bei Massendaten / Nutzerdaten ausschließlich auf die technische Lesbarkeit beschränkt. Das Recht auf Datenübertragbarkeit umfasst nicht, dass die vom Nutzer in einem proprietären Format erstellen Daten vom Verantwortlichen in ein “gängiges”, d.h. standardisiertes Format konvertiert werden.
Widerspruchsrecht (DSGVO Art. 21, BDSG §36)
Sie haben das Recht, Widerspruch gegen die Verarbeitung einzulegen, wenn diese ausschließlich auf Basis einer Abwägung des Verantwortlichen geschieht (vgl. DSGVO Art. 6 Abs. 1 lit f).
Recht auf Widerruf der datenschutzrechtlichen Einwilligungserklärung (DSGVO Art. 7 Abs. 3)
Sie haben das Recht, Ihre datenschutzrechtliche Einwilligungserklärung jederzeit zu widerrufen. Durch den Widerruf der Einwilligung wird die Rechtmäßigkeit der aufgrund der Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt.
Recht auf Beschwerde bei einer Aufsichtsbehörde (DSGVO Art. 77)
Unbeschadet eines anderweitigen verwaltungsrechtlichen oder gerichtlichen Rechtsbehelfs steht Ihnen das Recht auf Beschwerde bei einer Aufsichtsbehörde, insbesondere in dem Mitgliedstaat ihres Aufenthaltsorts, ihres Arbeitsplatzes oder des Orts des mutmaßlichen Verstoßes, zu, wenn Sie der Ansicht sind, dass die Verarbeitung der Sie betreffenden personenbezogenen Daten gegen die DSGVO verstößt.
Geltungsbereich im Falle individueller Vereinbarungen
Wenn Sie Zugriff auf unser KI Dienste durch ihre Organisation erhalten, gelten die Richtlinien und Datenschutzhinweise Ihres Unternehmens.
Im Falle eines Konflikts zwischen diesen Datenschutzbestimmungen und den Bedingungen einer bzw. mehrerer Vereinbarung(en) mit der GWDG, z.B. einem mit der GWDG geschlossenem Auftragsverarbeitungsvertrags, sind stets die Bedingungen dieser Vereinbarung(en) ausschlaggebend. Kardinalpflichten genießen stets Vorrang vor diesen allgemeinen Bestimmungen.
Sie können im Zweifelsfall bei Ihrem Institut in Erfahrung bringen, welche Datenschutzrichtlinien für Sie gelten.
2. Allgemeine technische Datenverarbeitung bei der Nutzung von KI Modellen
Beschreibung und Umfang der Datenverarbeitung
Zu Abrechnungszwecken werden bei jeder Anfrage auf dem Server der GWDG die folgenden Daten abgespeichert und gelogged:
Zeitstempel der Anfrage
NutzerID
Länge der Anfrage und Länge der Antwort
Diese Daten werden außerdem in den Logfiles unseres Systems gespeichert. Diese Daten werden nicht zusammen mit anderen personenbezogenen Daten des Nutzenden gespeichert.
Je nachdem ob lokal gehostete Modelle oder externe Modelle genutzt werden, gelten leicht unterschiedliche Datenschutzbestimmungen.
Für die automatisiert generierten Antworten kann keinerlei Haftung übernommen werden. Antworten können gänzlich falsch sein, falsche Teilinformationen beinhalten oder können unrechtmäßigen Inhalt besitzen.
Dauer der Speicherung
Die Abrechnungsdaten werden ein Jahr gespeichert.
Umfang der Verarbeitung personenbezogener Daten
Wir verarbeiten personenbezogene Daten unserer Nutzer grundsätzlich nur soweit dies zur Bereitstellung einer funktionsfähigen Website sowie unserer Inhalte und Leistungen erforderlich ist.
Die Verarbeitung personenbezogener Daten unserer Nutzer erfolgt regelmäßig nur nach Einwilligung des Nutzers (Art. 6 Abs. 1 lit. a DSGVO). Eine Ausnahme gilt in solchen Fällen, in denen eine vorherige Einholung einer Einwilligung aus tatsächlichen Gründen nicht möglich ist und die Verarbeitung der Daten durch gesetzliche Vorschriften gestattet ist.
3. Dienst-spezifische Module
3.1 ChatAI-Dienst
Übersicht über den Service
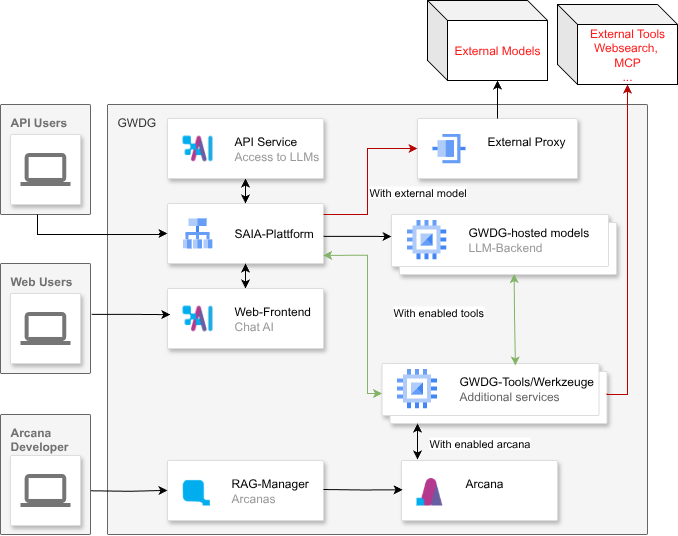
Der Service ChatAI besteht aus mehreren Komponenten, insbesondere einem Web-Frontend und Large Language Modellen im Backend. Das Frontend bietet Nutzer:Innen ein Webinterface, um Benutzeranfragen direkt mittels Browser eingeben zu können. Weiterhin kann das gewünschte Modell ausgewählt und gewisse Einstellungen können vorgenommen werden. Das Frontend leitet alle Anfragen weiter an das ausgewählte Modell-Backend. Es wird hierbei aus Datenschutzgründen zwischen lokal von der GWDG gehosteten Modellen und externen Modellen von anderen Anbietern unterschieden, wobei die externen Modelle als solche gekennzeichnet sind.
Das Backend, wird mittels der GWDG-Plattform SAIA gehostet, es nimmt alle Anfragen entgegen und leitet diese an das entsprechende Modell weiter. Im Falle von externen Modellen, werden die Anfragen, genauer, die im Browser übermittelte Historie inklusive der Zwischentexte der Modelle, sowie etwaige “Memories”, wie von der Nutzer:in getätigt, an den jeweiligen externen Anbieter weitergeleitet. Bei den selbst gehosteten Modellen werden die Anfragen nur auf den Systemen der GWDG verarbeitet.
Zusätzlich können vom Frontend oder via API sogenannte Werkzeuge (“GWDG Tools” im Frontend genannt, “Tools” in der OpenAI API) von den Nutzenden aktiviert werden. Werkzeuge greifen in die Anfragen der Nutzenden ein und stellen vielfältig erweiterte Funktionalitäten bereit. Die meisten angebotenen Werkzeuge nutzen von der GWDG bereitstellte Dienste. Manche Funktionalitäten (bspw. Websuche) können jedoch nur durch externe Dienste bereitgestellt werden, diese Funktionalitäten werden dann im Frontend mit einer Datenschutz-Warnung versehen.
Nutzung der Chat-AI Webseite (Frontend)
Beschreibung und Umfang der Datenverarbeitung
Bei jedem Aufruf von chat-ai.academiccloud.de erfasst das System automatisiert Daten und Informationen vom Computersystem des aufrufenden Rechners.
Folgende Daten werden hierbei in jedem Fall erhoben:
Zeitstempel des Zugriffs
Name des auf dem zugreifenden Gerät installierten Betriebssystems (User-Agent)
Name des verwendeten Browsers (User-Agent)
Die IP-Adresse des zugreifenden Geräts
Die Daten werden ebenfalls in den Logfiles unseres Systems gespeichert. Eine Speicherung dieser Daten zusammen mit anderen personenbezogenen Daten des Nutzenden findet nicht statt.
Info
Sämtliche im Browser angezeigten Daten von Chat-AI werden nur Clientseitig im Browser der Nutzenden vorgehalten und nur bei der Benutzer-gewünschten Anfrage für die notwendige Verarbeitung an die Server übermittelt, d.h. während die Daten von den Backend-Modellen verarbeitet werden. Nach dem Ende einer Session im Browser sind keine Eingaben des Nutzers mehr vorhanden.
Nutzung von GWDG-gehosteten Modellen
Beschreibung und Umfang der Datenverarbeitung
Um die bei der GWDG gehosteten Modelle zu nutzen, werden die Eingaben/Anfragen von den Nutzenden auf den Systemen der GWDG verarbeitet. Der Schutz der Privatsphäre von Nutzeranfragen ist für uns von grundlegender Bedeutung. Aus diesem Grund speichert unser Dienst, in Kombination mit den bei der GWDG gehosteten lokalen Modellen, weder die Inhalte ihrer Anfragen (Chatverlauf) noch werden Aufforderungen oder Antworten zu irgendeinem Zeitpunkt auf einem persistenten Speicher abgelegt.
Dauer der Speicherung
Die Eingaben werden auf dem Server der GWDG nur während der Verarbeitung durch die Large Language Modelle selbst vorgehalten, d.h. während die Daten auf den eigenen Systemen verarbeitet werden.
Nutzung von externen Modellen von Azure
Beschreibung und Umfang der Datenverarbeitung
Um die Modelle von Azure zu nutzen, senden wir von unserem Server aus die jeweilige Anfrage (Eingabe des Nutzenden) an die Server von Microsoft (externer Dienstleister) weiter. Zur Erfüllung des Services werden folgende Daten weitergeleitet:
Anfrage der Nutzenden
Informationen über die Nutzenden selbst werden von der GWDG nicht weitergegeben.
Allerdings wird die Anfrage der Nutzenden ungefiltert weitergegeben, d.h., dass persönliche Informationen, die in der Anfrage selbst enthalten sind, an den externen Dienstleister weitergegeben werden.
Die durch die GWDG-Server anonymisierten Anfragen an den externen Dienstleister werden gemäß des Microsoft Data Processing Addendums ausschließlich im Falle eines Missbrauchsversuchs, z.B. zum Erstellen von Hass- oder sexualisierten Inhalten, für bis zu 30 Tage geloggt. Dies geschieht automatisch, wenn das Backend feststellt, dass ein Missbrauchsversuch vorliegt. Dabei kann es nicht ausgeschlossen werden, dass legitime Anfragen fälschlicherweise als Missbrauchsversuch gewertet und geloggt werden.
Widerspruchs- und Beseitigungsmöglichkeit
Die Erfassung der Eingabe des Nutzers sowie die Prozessierung durch Microsoft ist für die Nutzung der externen Modelle zwingend erforderlich. Es besteht seitens des Nutzenden zwar weiterhin die Widerspruchsmöglichkeit, aber mit dem Widerspruch ist die Nutzung der Externen Modelle gleichzeitig nicht mehr möglich.
Nutzung von Partnermodellen aus der Forschung
Beschreibung und Umfang der Datenverarbeitung
Die GWDG hat Forschungspartner, die Modelle extern auf Ihren Rechenressourcen hosten. Dazu leitet die GWDG die entsprechende Nutzeranfrage an den Forschungspartner weiter. Informationen über die Nutzer:Innen selbst werden dabei nicht weitergeleitet. Allerdings werden die Nutzeranfragen ungefiltert weitergeleitet, d.h. personenbezogene Daten, die in der Anfrage selbst enthalten sind, werden zu den Forschungspartnern weitergeleitet.
Der Datenverabreitung liegt eine Vereinbarung über die Gemeinsame Verantwortlichkeit zwischen der GWDG und den entsprechenden Forschungspartnern zugrunde.
Die entsprechenden Modelle die bei den Forschungspartnern gehosted werden sind im Webinterface von ChatAI durch ein nachgestelltes “(Research Partner)” eindeutig gekennzeichnet.
Die Nutzung dieser Modelle erfolgt auf eigenes Risiko.
Nutzung von Modellen am LUIS
Die Leibniz Universität IT Services (LUIS) betreiben im Rahmen des KISSKI-Projekts einen Inferenzcluster, der große Sprachmodelle bereitstellt. Diese Modelle sind im Menü des ChatAI-Dienstes mit LUIS gekennzeichnet.
Beschreibung und Umfang der Datenverarbeitung
Um die am LUIS gehosteten Modelle zu nutzen, werden die Eingaben/Anfragen der Nutzenden auf den Systemen des LUIS verarbeitet. Der Schutz der Privatsphäre von Nutzeranfragen ist für uns von grundlegender Bedeutung. Aus diesem Grund speichert unser Dienst in Kombination mit den am LUIS gehosteten Modellen weder den Chatverlauf noch werden Fragen oder Antworten zu irgendeinem Zeitpunkt auf einem persistenten Speicher abgelegt.
Dauer der Speicherung
Die Eingaben werden auf dem Server des LUIS nur während der Verarbeitung durch die Sprachmodelle selbst vorgehalten, d.h. während eine Antwort auf die Anfrage generiert wird.
Nutzung von Werkzeugen / GWDG-Tools
Werkzeuge erweitern die Fähigkeiten und die Mächtigkeit von ChatAI, bspw. durch eine Internetsuche, eine Vektordatenbank, externe MCP-Server oder die Erstellung von Bildern, Audio etc.
In sofern nicht explizit aufgeführt werden die Werkzeuge GWDG-intern bereitstellt.
Websuche und MCP-Server Dienste sind externe Dienste.
Werkzeuge müssen via Opt-In von Nutzenden im Frontend ausgewählt oder über die API angefordert werden.
Die von der GWDG zur Verfügung gestellten Werkzeuge werden typischerweise dem ausgewählten Modell bekannt gemacht, die Modelle entscheiden dann basierend auf der Nutzeranfrage ob sie ein oder mehrere Werkzeuge nutzen möchten - bspw. wenn der Nutzende das Modell auffordert ein Bild zu generieren.
In dem Fall werden die Werkzeuge mit Parametern aufgerufen, welche von der Nutzeranfrage abhängen.
Die Vektordatenbank (Arcana) ist ein Sonderfall.
Alle Aktivitäten der Werkzeuge werden transparent in Chat-AI für die Nutzenden dargestellt.
GWDG-interne Werkzeuge
Beschreibung und Umfang der Datenverarbeitung
GWDG interne Werkzeuge wie Bilderzeugung bekommen die Anfrage der Modelle übermittelt (bspw. ’erstelle eine Audioausgabe “Hallo Datenschützer”’), verarbeiten diese und stellen das Ergebnis den Modellen zur Verfügung. Zu keinem Zeitpunkt werden Anfragen oder Antworten (inkl. Artefakte wie Bilder) dauerhaft gespeichert sondern Antworten und Artefakte direkt an Nutzende zurück gegeben.
Vektordatenbank / RAG System / Arcana
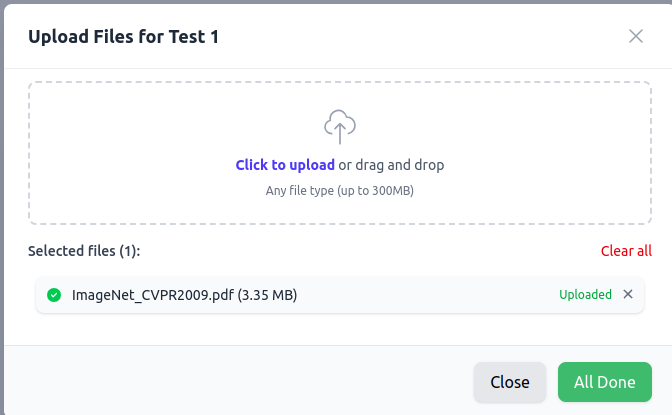
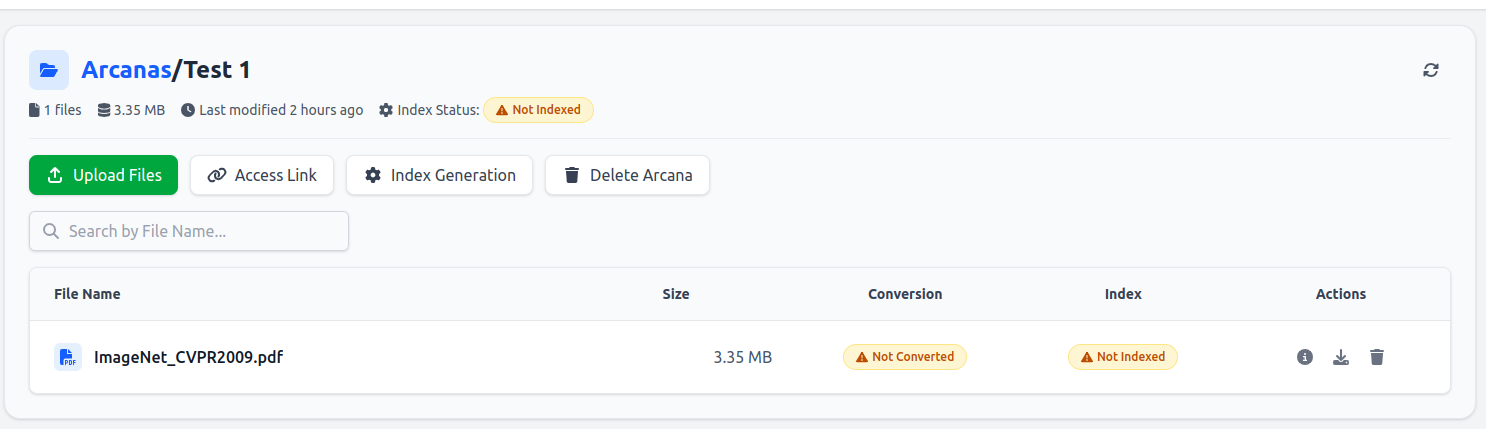
Das Arcana-System der GWDG stellt für die Nutzenden eine Datenbank zur Verfügung die Datensätze in ChatAI durchsuchbar macht und als Referenzen nutzt. Das gesamte System wird GWDG-intern zur Verfügung gestellt, es besteht aus einer WebUI - dem RAGmanager und einer Integration in ChatAI.
Beschreibung und Umfang der Datenverarbeitung
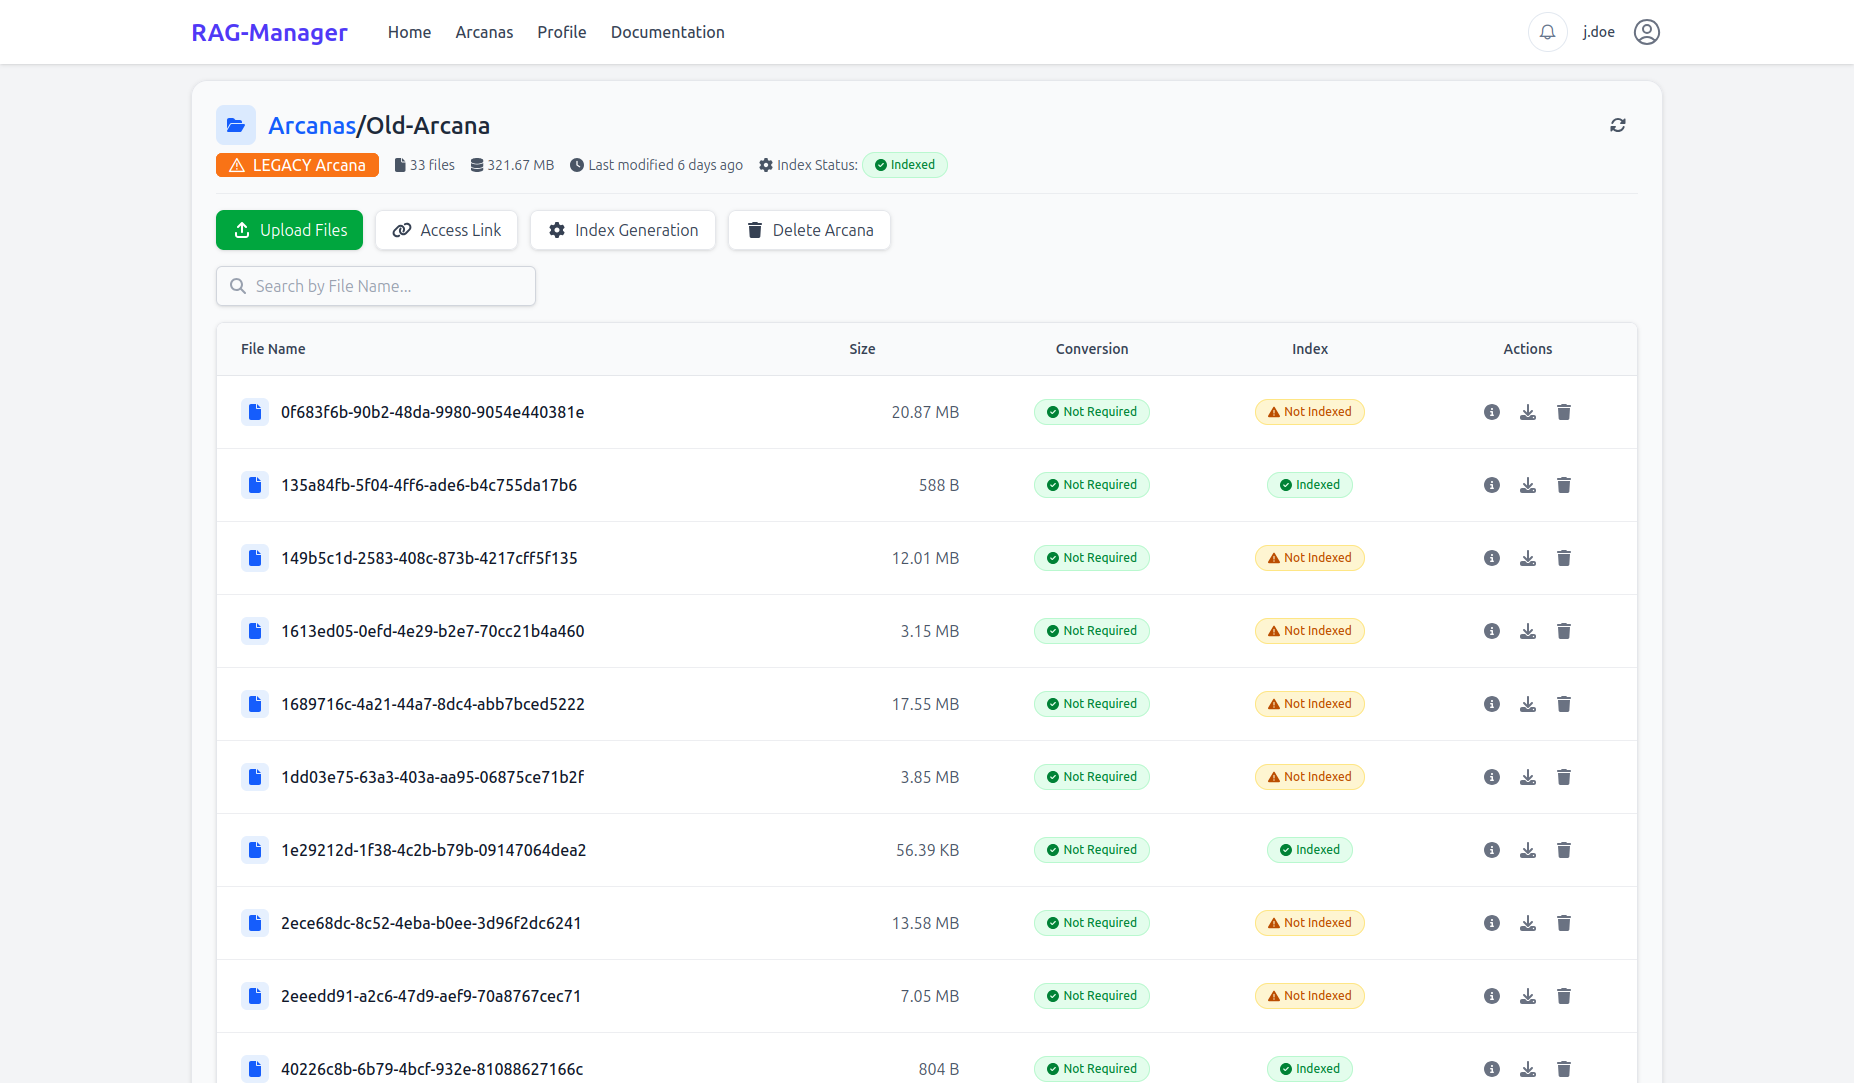
Grundsätzlich wird zwischen der Rolle der Entwickler:In und der Nutzer:In unterschieden. Die Entwickler:In stellt Kontextdaten bereit, die genutzt werden um serverseitig einen Index zu bauen. Dieser Index ist persistent/gespeichert und kann über mehrere Sessions und von mehreren Nutzer:Innen genutzt werden. Der Index wird genutzt, um Nutzer:Innen Zugriff auf ein Large Language Model zu geben, welches spezifisches Wissen aus den bereitgestellten Kontextdaten nutzen kann um die individuellen Anfragen der Nutzenden zu beantworten.
Der Entwickler:In lädt dazu die Daten via des RAGManagers hoch, wo diese in verschiedenen Datensätzen, Arcanas genannt, vorgehalten und indiziert werden. Ein Arcana kann mit beliebig vielen Personen geteilt werden. Dabei muss jede:r Nutzer:In den Namen des Arcanas, bzw. dessen ID kennen. Dabei ist wichtig klarzustellen, dass jede Person die Zugriff das Arcana hat, sich Zugriff auf das enthaltene Wissen verschaffen kann.
Die von den Entwickler:Innen bereitgestellten Kontextdaten werden serverseitig zu einem Arcana indiziert und mit einem Passwort gesichert. Das Arcana wird dann, falls eine ID von den Nutzenden bereitgestellt wurde, im Kontext der Open-Source Modelle in Chat AI oder via API exportiert.
Dauer der Speicherung
Die von den Entwickler:Innen bereitgestellte Kontextdaten werden dauerhaft bis zur expliziten Löschung durch die Entwickler:Innen gespeichert. Die Anfragen und Antworten für die Nutzenden werden weiterhin nur lokal auf den Clientsystemen der Nutzenden gespeichert, wie in der Sektion “Nutzung von selbstgehosteten Modellen” beschrieben. Die Anfrage ist ausschließlich während der Bearbeitung eben dieser auf den Servern der GWDG vorhanden.
Externe Werkzeuge
Bei externen Werkzeugen ist der Sinn und Zweck Teile der Benutzer-Anfrage weiterzureichen.
Die GWDG kann keine Haftung bei der Verwendung von externen Werkzeugen übernehmen!
Beschreibung und Umfang der Datenverarbeitung
Der externe Dienstleister (bspw. Google) bekommt die von dem Model angeforderte Suchanfrage übermittelt und die Ergebnisse der Websuche werden als Referenzen dargestellt.
Bei externen MCP-Servern werden die Funktionsargumente übergeben.
Es werden keine zusätzlichen Informationen über die Nutzenden übermittelt, ebenfalls werden keine Informationen über Benutzer-Browser etc. weitergegeben. Sollte das Modell sich entscheiden von den Nutzenden eingegebene personenbezogene Daten zu verwenden, bspw. indem es aufgefordert wird im Internet nach einer Person zu suchen, so ist dies exakt die beabsichtigte Funktionalität.
Dauer der Speicherung
Die Informationen werden bei der GWDG nicht gespeichert, eine Suchmaschine oder MCP-Server kann die vorgenommene Anfrage speichern.
3.2 Image AI Dienst
Übersicht über den Service
ImageAI ist ein KI-basierter Bild Generierungsdienst. Die HPC-Architektur (High Performance Computing) wird durch den ImageAI-Dienst genutzt, der das FLUX.1 [schnell] Modell, um Bilder aus Benutzerdaten zu generieren. Die Benutzerdaten bleiben sicher. Die benutzerfreundliche Weboberfläche ermöglicht es den Nutzern, den Dienst sehr intuitiv zu nutzen und das gewünschte Bild sehr schnell zu erstellen.
Die Hauptkomponente dieses Dienstes ist die Bilderzeugung, auf die über die Weboberfläche zugegriffen werden kann.
Nutzung der Image-AI Webseite
Bei jedem Aufruf von image-ai.academiccloud.de/ erfasst das System automatisiert Daten und Informationen vom Computersystem des aufrufenden Rechners.
Folgende Daten werden hierbei in jedem Fall erhoben:
Datum des Zugriffs
Name des auf dem zugreifenden Gerät installierten Betriebssystems
Name des verwendeten Browsers
Quellsystem, über welches der Zugriff erfolgt ist
Die IP-Adresse des zugreifenden Geräts
Die Daten werden ebenfalls in den Logfiles unseres Systems gespeichert. Eine Speicherung dieser Daten zusammen mit anderen personenbezogenen Daten des Nutzers findet nicht statt.
Sämtliche im Browser angezeigten Daten von Image-AI werden nur Clientseitig im Browser der Nutzenden vorgehalten und nur bei der Benutzer-gewünschten Anfrage für die notwendige Verarbeitung an die Server übermittelt, d.h. während die Daten von den Backend-Modellen verarbeitet werden. Nach dem Ende einer Session im Browser sind keine Eingaben des Nutzers mehr vorhanden.
3.3 Voice AI Dienst
Übersicht über den Service
Der Service bietet Nutzern die Möglichkeit:
Sprachströme zu übersetzen: Mit Hilfe von KI-Technologie Sprachströme in Text in verschiedenen Sprachen zu übersetzen.
Notizen aus Meetings zu erstellen: Automatisch geschriebene Notizen aus der Stimmeingabe des Nutzers in Online-Meetings mit Hilfe von KI-Technologie zu erstellen.
Service-Spezifikation: Der Service besteht aus zwei Hauptteilen:
Verarbeitung von hochgeladenen Audio-Dateien: Dieser Teil verarbeitet Audio-Dateien, die von den Nutzern hochgeladen werden.
Verarbeitung von Streaming-Audio aus BBB: Dieser Teil erfasst und verarbeitet Streaming-Audio aus BigBlueButton (BBB).
Nutzung von Voice AI
Beschreibung und Umfang der Datenverarbeitung
Jedes Mal, wenn unsere Website aufgerufen wird, erfasst unser System automatisch Daten und Informationen vom Computersystem des aufrufenden Rechners.
Um die Voice-AI-Dienste, die von der GWDG gehostet werden, zu nutzen, werden Benutzeranfragen/Eingaben von der Website erfasst und auf den HPC-Ressourcen verarbeitet. Der Schutz der Privatsphäre von Benutzeranfragen ist für uns von grundlegender Bedeutung. Aus diesem Grund speichert unser Dienst weder Ihre Audio-Datei noch die BBB-Konversation, noch werden Anfragen oder Antworten auf einem dauerhaften Speicher abgelegt. Die einzige Ausnahme ist die BBB-Transkription, die in Etherpad geschrieben und mit lokalem MySQL verwendet wird und >500 MB Audio-Transkriptionsergebnisse in unserem GWDG-Speicher enthält, die beide nach 30 Tagen gelöscht werden. Die Anzahl der Anfragen pro Benutzer und die entsprechenden Zeitstempel werden aufgezeichnet, damit wir die Nutzung des Systems überwachen und die Abrechnung durchführen können.
Die folgenden Daten werden gespeichert, um den Dienst zu erfüllen:
Datum des Zugriffs
Name des auf dem zugreifenden Gerät installierten Betriebssystems
Name des verwendeten Browsers
Quellsystem, über das der Zugriff erfolgt ist
Die IP-Adresse des zugreifenden Geräts
Die Daten werden auch in den Log-Dateien unseres Systems gespeichert. Diese Daten werden nicht zusammen mit anderen personenbezogenen Daten des Nutzers gespeichert.
3.4 Protein AI Dienst
Übersicht über den Dienst
Der Protein-AI-Dienst besteht aus mehreren Komponenten, insbesondere einem Web-Frontend sowie den Backend-Modellen alphafold2/boltz. Das Frontend bietet den Nutzern eine Weboberfläche, um direkt Abfragesequenzen über einen Browser einzugeben. Zudem können Nutzer das gewünschte Modell auswählen und bestimmte Einstellungen anpassen.
Das Frontend leitet alle Anfragen an das ausgewählte Backend-Modell weiter.
Das Backend wird über die GWDG-Plattform betrieben, die sämtliche Anfragen empfängt und an das entsprechende Modell weiterleitet.- alphafold2/boltz-Modelle
Nutzung von Protein AI
Bei jedem Zugriff auf protein-ai.academiccloud.de/ erhebt das System automatisch Daten und Informationen vom Computersystem des zugreifenden Geräts.
Folgende Daten werden jeweils erhoben:
Datum des Zugriffs
Name des auf dem zugreifenden Gerät installierten Betriebssystems
Name des verwendeten Browsers
Quellsystem, über das der Zugriff erfolgt ist
IP-Adresse des zugreifenden Geräts
Die Daten werden zudem in den Logdateien unseres Systems gespeichert. Eine Speicherung zusammen mit anderen personenbezogenen Daten des Nutzers erfolgt nicht.
Nach der Verarbeitung der vom Nutzer eingegebenen Sequenzen durch das Backend-Modell werden diese gelöscht; es wird lediglich das Ausgaberesultat auf dem gesicherten „Data Mover“-Knoten der GWDG für 30 Tage aufbewahrt.
KI-Dienste
Die von GWDG angebotenen KI-Dienste bieten eine vielseitige Plattform für praktische KI-Anwendungen. Unser Portfolio reicht von einem Chatbot mit fortgeschrittenen Funktionen (z. B. Retrieval-Augmented Generation, Werkzeugintegration, MCP) über Spracherkennung bis hin zur Bildverarbeitung. Alle Dienste können bequem über eine Web-Oberfläche genutzt werden oder nahtlos über eine OpenAI-kompatible API in bestehende Systeme integriert werden. Entwickelt im Rahmen des KISSKI-Projekts (KI-Service-Center für sensible und kritische Infrastrukturen) erfüllen die Dienste hohe Anforderungen an den Datenschutz und sind daher besonders gut für sensible Anwendungsszenarien geeignet.
Falls Sie weitere Fragen haben, kontaktieren Sie uns gerne über unseren Support. Oder treten Sie unserem Community-Chat auf Matrix bei.
Unterabschnitte von KI-Dienste
Arcana/RAG
Arcana ist ein Retrieval-Augmented Generation (RAG)-Dienst, der es Ihnen ermöglicht, mit Dokumenten – wie Forschungsarbeiten, Handbüchern oder Lernmaterialien – über natürliche Sprache zu interagieren.
Der Arcana-Dienst arbeitet zusammen mit unserem Chat AI-Dienst.
LLMs profitieren von RAG (Retrieval-Augmented Generation), indem sie relevante Informationen aus einer Dokumenten-Sammlung (Arcana) nutzen, um genauere, zuverlässigere und kontextbasierte Antworten zu generieren.
Um den Dienst nutzen zu können, müssen Sie Ihr Konto für die Arcana-Seite aktivieren und eine Arcana gemäß der Anleitung zum Starten einrichten. Sobald dies erledigt ist, können Sie sie mit Kollegen oder der Öffentlichkeit teilen. Details zu diesem Prozess finden Sie in den Nutzungsszenarien.
Dies ist besonders nützlich, um große Handbücher oder rechtliche Texte für eine Zielgruppe zugänglich zu machen, die nur an bestimmten Teilen des umfangreichen Dokuments interessiert ist. Ein Beispiel wäre eine Liste von Studien- oder Prüfungsordnungen. Diese Dokumente können hochgeladen und über den Chat AI-Dienst für Studierende zugänglich gemacht werden. Studierende können dann Fragen stellen und Antworten erhalten, die Informationen aus diesen Dokumenten enthalten.
Bei Fragen wenden Sie sich bitte an unsere Support-Seite, wo Sie auch eine kurze FAQ finden.
Wenn Sie lediglich einige öffentliche Arcana-Links benötigen, schauen Sie sich unsere veröffentlichte Liste an.
Info
Wir brauchen Ihre Hilfe! Wenn Sie eine Arcana erstellt haben, die Sie einer größeren Öffentlichkeit präsentieren möchten, kontaktieren Sie uns bitte. Wir können sie hier vorstellen und anderen Nutzern kommunizieren.
Warum RAG nutzen?
Der RAG-Dienst ist für Unternehmen und Anwendungen konzipiert, die von KI-generierten Antworten genau, erklärbar und anpassungsfähig an aktuelles Wissen profitieren. Unabhängig davon, ob er für Kundenservice, Wissensmanagement, Forschung, technische Anleitung oder Expertensysteme eingesetzt wird, stellt RAG sicher, dass die KI intelligent, vertrauenswürdig und nützlich in dynamischen Umgebungen bleibt.
Durch die Integration von Echtzeit-Datenabruf mit künstlicher Intelligenz-basiertem Sprachgenerierung verwandelt RAG die KI von einem statischen Wissenswerkzeug in ein dynamisches, kontinuierlich lernendes System – wodurch Antworten immer aktuell, relevant und zuverlässig sind.
Wichtige Begriffe
RAG: Wie RAG funktioniert, wird auf der RAG-Dienst-Seite beschrieben.
Docling: Das Programm, das die Dateien indiziert, wird auf der Docling-Prozess-Seite beschrieben.
Dienstübersicht
Dieser Dienst hat zwei Seiten. Die erste ist die, über die Sie eine bestimmte Arcana über den Chat AI-Dienst zugreifen. Ebenso können Sie diese ID oder den Zugangslink mit anderen teilen, damit sie die RAG-Funktion direkt für den Zugriff auf bestimmte Dokumente nutzen können.
Die zweite Seite ist der Arcana-Manager, in dem der RAG-Dienst eingerichtet werden kann. Hier können Sie Dokumente erstellen und für die Nutzung im Arcana-Dienst in Chat AI einrichten. Zusätzlich kann das indizierte Material feinabgestimmt werden, wenn die vorhandene Indizierung nicht ausreichend gut oder genau ist.
Es ist möglich, PDF-, Text- und Markdown-Dateien hochzuladen, die als Grundmaterial dienen.
Nutzungsszenarien
Wir haben eine Anleitung zum Starten sowie eine Nutzungsanleitung verfasst. Bitte ziehen Sie diese Abschnitte direkt heran, wenn Sie Informationen zur Oberfläche benötigen.
Die Anleitung zum Starten beschreibt die Arcana-Oberfläche. Dazu gehören die Erstellung eines Kontos, falls Sie bereits ein Academic Cloud-Konto besitzen, sowie die Einrichtung einer Arcana. Sie enthält auch Informationen dazu, wie Sie die ID und Tokens generieren sowie den Zugangslink verwenden.
Die Nutzungsanleitung konzentriert sich auf die Chat AI-Oberfläche und wie Sie dort auf Arcanas zugreifen können. Sie enthält außerdem allgemeine Anleitungen zur Prompt-Engineering mit Arcanas.
Unterabschnitte von Arcana/RAG
Erklärung zur KI-Transparenz
Ziel
Typische LLMs haben den Vorteil, aber auch das Problem, dass sie auf einer unglaublich großen Menge an Daten trainiert wurden. Das bedeutet, dass sie viel Wissen besitzen, aber oft nicht in der Lage sind, sehr spezifische Fragen zu beantworten. In solchen Fällen sind LLMs sehr anfällig für Halluzinationen, d. h., sie erfinden einfach Dinge. Eine Möglichkeit, die Leistung von LLMs bei sehr spezifischen Fragen zu verbessern, ist die Verwendung von Retrieval-Augmented-Generation (RAG). Hier geben Benutzer benutzerdefinierte Dokumente an, die die Wissensbasis enthalten, über die sie später Fragen stellen möchten. Bevor ein LLM auf eine Benutzeranfrage antwortet, werden die zuvor vom Benutzer bereitgestellten relevantesten Dokumente abgerufen und dem LLM als zusätzlicher Kontext zur Verfügung gestellt.
In unserem innovativen Ansatz fügen wir am Ende der Antwort einen Referenzabschnitt hinzu, in dem Sie den tatsächlichen Teil des Dokuments finden können, den unsere RAG mit Ihrer Frage verknüpft hat. Da diese Referenzen direkt aus den vom Benutzer bereitgestellten Dokumenten zitiert werden, besteht keine Möglichkeit für Halluzinationen.
Allgemeine Funktionalität
Dieser Abschnitt skizziert kurz die einzelnen Schritte, die zur Verarbeitung einer RAG-Anfrage erforderlich sind.
Eingabe von Dokumenten
Um RAG nutzen zu können, muss ein Benutzer zunächst eine Wissensbasis – also eine Sammlung von Dokumenten – bereitstellen. Diese Dokumente werden hochgeladen, in Markup konvertiert und dann in einer Datenbank indiziert. Dort werden sie in Teile (Chunks) aufgeteilt und anschließend durch ein spezielles Embedding-Modell in einen Vektor umgewandelt. Dieser Vektor wird in einer Vektor-Datenbank gespeichert. Auf diese Weise muss jedes vom Benutzer bereitgestellte Dokument verarbeitet werden, um die Wissensbasis aufzubauen. Diese Wissensbasis, auch „Arcana“ genannt, wird bei GWDG gespeichert, bis der Benutzer sie explizit löscht!
Einreichen von Anfragen
Sobald die allgemeine Wissensbasis erstellt ist, kann ein Benutzer Anfragen stellen. Bevor diese Anfragen an das LLM gesendet werden, werden sie ebenfalls in eine Vektorrepräsentation umgewandelt, wobei dasselbe Embedding-Modell verwendet wird, das zur Erstellung der Wissensbasis im vorherigen Schritt verwendet wurde. Dieser Vektor wird dann in einer Ähnlichkeitssuche in der zuvor erstellten Vektor-Datenbank verwendet, um Teile der zuvor erfassten Dokumente zu finden, die eine ähnliche Bedeutung haben. Eine konfigurierbare Anzahl ähnlicher Vektoren wird zurückgegeben und zusammen mit der ursprünglichen Anfrage des Benutzers an das LLM weitergeleitet.
Generierung einer Antwort
Das LLM nutzt die zusätzlichen Informationen, um eine präzisere Antwort auf die Anfrage des Benutzers zu liefern. Dies ist bereits viel weniger anfällig für Halluzinationen, aber diese sind immer noch möglich. In unserem Ansatz geben wir explizite Referenzen auf die Dokumente an, die die von LLM verwendeten Teile enthalten, um die Antwort zu formulieren. Diese Referenzen werden in einem speziellen Referenzkasten am Ende der Antwort angezeigt, der die tatsächlichen Zitate aus den ursprünglichen Dokumenten enthält, die vom Benutzer bereitgestellt wurden. Daher ist eine Halluzination bei diesen Referenzen unmöglich.
Weitere Überlegungen
Zugriff auf die gespeicherten Dokumente
Die eingelesene Wissensbasis kann frei mit anderen Nutzern geteilt werden. Dazu muss die Arcana-ID bereitgestellt werden. WICHTIG: Dies gibt Nutzern vollen Zugriff auf Ihre Dokumente und kann (derzeit) nicht einzeln widerrufen werden!
Speicherung Ihrer Dokumente
Ihre indizierten Daten verbleiben zu allen Zeiten auf GWDG-Systemen. Wir werden Ihre Dokumente nicht an Dritte weitergeben.
Verarbeitung Ihrer Anfragen
Die Verarbeitung Ihrer Anfragen – einschließlich der Generierung der Embeddings, des Abrufs relevanter Dokumente und der Durchführung der Inferenz – erfolgt vollständig auf GWDG-Hardware. weder Ihre Anfragen noch Ihre indizierten Dokumente werden an Dritte weitergegeben.
Migrationsleitfaden
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Mit der Einführung unseres neuen RAG-Managers haben wir die Benutzeroberfläche und den Indexierungsprozess verbessert. Aufgrund architektonischer Änderungen ist die neue Oberfläche nur teilweise rückwärtskompatibel, insbesondere hinsichtlich der Dateispeicherung und Indexierung.
Dieser Leitfaden erklärt:
Was weiterhin zwischen der alten und neuen Oberfläche funktioniert
Was nicht funktioniert
Wie Sie Ihre bestehenden Arcanas vom alten Manager auf das neue System migrieren können
Details
Die alte Version ist während der Übergangsphase weiterhin zugänglich und wird in den nächsten Monaten entfernt werden. Sie können sie weiterhin hier nutzen: https://chat-ai.academiccloud.de/arcanas-old
Was funktioniert
Alle bereits mit dem alten Manager erstellten Arcanas funktionieren weiterhin
Sie können mit einer Legacy-Arcana über die Chat-Oberfläche chatten
Sie können eine Legacy-Arcana weiterhin in der alten Oberfläche bearbeiten
Sie können eine Arcana, die im alten System erstellt wurde, über die neue Oberfläche löschen
Was nicht funktioniert
Die Bearbeitung einer Arcana über beide Oberflächen hinweg ist nicht vollständig unterstützt:
Sie können nur Arcanas oder Dateien, die im alten System erstellt wurden, über die neue Oberfläche löschen.
Sie können eine Arcana, die im neuen System erstellt wurde, nicht in der alten Oberfläche bearbeiten oder anzeigen.
Das Neuerstellen des Index für eine Legacy-Arcana über die neue Oberfläche funktioniert nicht, da die Dateispeicherarchitektur unterschiedlich ist.
Migrations-Schritte
So migrieren Sie eine Legacy-Arcana auf den neuen RAG-Manager:
1. Identifizieren Sie Legacy-Arcanas
In der neuen Oberfläche sind Legacy-Arcanas im Detailansichtsfenster mit einem „Legacy-Arcana“-Tag gekennzeichnet.
Bild 1: Arcana-Detailansicht mit „Legacy-Arcana“-Tag
Durch Klicken auf den Tag erhalten Sie weitere Informationen und einen Link zu diesem Migrationsleitfaden (siehe Bild 2).
Bild 2: Popup nach Klicken auf den Tag mit Migrationsanleitung
2. Wählen Sie Ihre Migrationsstrategie
Sie haben zwei Möglichkeiten, eine Legacy-Arcana zu migrieren:
Option A: Arcana neu erstellen
Löschen Sie die Arcana vollständig.
Erstellen Sie eine neue Arcana in der neuen Oberfläche mit demselben Namen.
Laden Sie Ihre Dateien erneut hoch.
Klicken Sie auf „Index generieren“ und folgen Sie den üblichen Schritten.
Option B: Dateien in bestehender Arcana ersetzen
Löschen Sie alle Dateien in der bestehenden Legacy-Arcana.
Laden Sie die Dateien über die neue Oberfläche in dieselbe Arcana hoch.
Klicken Sie auf „Indexgenerierung“, dann auf „Index löschen“ und schließlich auf „Index generieren“.
Details
Diese Option behält den ursprünglichen Arcana-Namen und die ID bei, entfernt jedoch den gesamten vorherigen Dateiinhalt.
RAG-Dienst
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
RAG (Retrieval-Augmented Generation) ist eine fortschrittliche KI-Technik, die darauf abzielt, die Genauigkeit, Zuverlässigkeit und kontextuelle Relevanz von KI-generierten Antworten zu verbessern. Traditionelle KI-Modelle wie große Sprachmodelle (LLMs) stützen sich ausschließlich auf vortrainierte Daten, um Antworten zu generieren. Obwohl diese Modelle informative Antworten liefern können, sind sie durch die Informationen begrenzt, auf die sie trainiert wurden, die veraltet sein können oder bestimmte Themen nicht ausreichend detailliert abdecken.
RAG überwindet diese Einschränkungen, indem es einen externen Abrufprozess vor der Antwortgenerierung integriert. Anstatt sich ausschließlich auf statisches Wissen zu verlassen, sucht RAG aktiv nach relevanten Daten aus externen Quellen wie Dokumenten-Datenbanken, APIs oder Wissensspeichern. Die abgerufenen Daten werden zusammen mit der ursprünglichen Benutzeranfrage an das KI-Modell weitergeleitet, wodurch sichergestellt wird, dass die Antwort auf Fakten basiert, aktuell ist und kontextuell relevant.
Dieser Ansatz ist besonders wertvoll für Anwendungen, die Zugriff auf Echtzeitinformationen erfordern, wie z. B. Kundenservice, Forschung, Gesundheitswesen, juristische Beratung und Finanzdienstleistungen. Durch die Nutzung externer Daten verbessert RAG die Fähigkeit der KI, präzisere Antworten zu liefern, reduziert Fehlinformationen und erhöht das Vertrauen in KI-gestützte Entscheidungsfindung.
Wie der RAG-Dienst funktioniert
Der RAG-Dienst folgt einem dreistufigen Prozess: Abruf, Erweiterung und Generierung.
1. Abrufphase
Das System verwaltet eine strukturierte externe Wissensbasis, die in Arcana-basiertem ChromaDB gespeichert ist. Diese Datenbank enthält Dokumente, Artikel, technische Handbücher und andere relevante Datenquellen. Wenn ein Benutzer eine Anfrage stellt, führt die ChromaDB-Engine eine Suche durch, um die relevantesten Dokumente zu finden. Der Abrufprozess wird durch vektorbasierte Ähnlichkeitsabgleich unterstützt, der Informationen identifiziert, die dem Sinn und Kontext der Benutzeranfrage nahekommen. Dieser Ansatz stellt sicher, dass selbst wenn die genaue Formulierung der Anfrage von den gespeicherten Daten abweicht, das System dennoch relevante Informationen finden kann.
2. Erweiterungsphase
Sobald das System relevante Dokumente abgerufen hat, werden diese zusammen mit der ursprünglichen Benutzeranfrage zu einem erweiterten Eingabedatenstrom kombiniert. Diese erweiterte Eingabe hilft dem KI-Modell, spezialisierte oder proprietäre Informationen zu verstehen, die möglicherweise nicht Teil seiner ursprünglichen Trainingsdaten waren. Die abgerufenen Dokumente fungieren als Wissensinjektion, wodurch sichergestellt wird, dass Antworten auf verifiziertem, realen Wissen basieren und nicht auf Annahmen des Modells allein.
3. Generierungsphase
Das KI-Modell verarbeitet die kombinierte Eingabe (ursprüngliche Anfrage + abgerufene Dokumente). Anschließend generiert es eine Antwort, die sowohl sein vortrainiertes Wissen als auch die neu abgerufenen Informationen integriert. Diese Antwort ist genauer, relevanter und faktengestützter als Antworten, die von traditionellen KI-Modellen ohne externen Abruf generiert werden. Das System kann außerdem Quellenangaben liefern, was die Transparenz erhöht und Benutzern ermöglicht, die bereitgestellten Informationen zu überprüfen.
Hauptvorteile des RAG-Dienstes
Verbesserte Genauigkeit
Da die KI reale Weltinformationen abruft, bevor sie Antworten generiert, wird die Anzahl von Fehlern und veralteten Informationen erheblich reduziert.
Dies stellt sicher, dass Antworten zuverlässig, präzise und faktisch korrekt sind.
Reduzierung von KI-Halluzinationen
Traditionelle KI-Modelle generieren manchmal Antworten, die plausibel klingen, aber tatsächlich falsch oder irreführend sind.
RAG minimiert dieses Risiko, indem sichergestellt wird, dass Antworten auf abgerufenen, verifizierbaren Daten basieren, anstatt rein spekulativ zu sein.
Branchenspezifische Anpassung
Organisationen können eigene Datenbanken integrieren, wodurch die KI hochspezialisiert für ihre Branche oder Anwendung wird.
Ob für Gesundheitswesen, Recht, Finanzen, Ingenieurwesen, Forschung oder Kundenservice – RAG kann so angepasst werden, dass sie hochrelevante Antworten liefert.
Verbesserte Erklärbarkeit und Transparenz
Im Gegensatz zu traditionellen KI-Modellen, die Antworten ohne Erklärung liefern, kann RAG Quellenangaben für seine Antworten liefern.
Benutzer können die Informationen zurückverfolgen und die Quelle der Antwort identifizieren, was das Vertrauen und die Verantwortlichkeit bei KI-generierten Inhalten erhöht.
Zugriff auf Echtzeit- und dynamisches Wissen
Im Gegensatz zu statischen KI-Modellen, die sich ausschließlich auf vortrainiertes Wissen stützen, kann RAG die aktuellsten verfügbaren Informationen abrufen und integrieren.
Dies ist besonders nützlich für Branchen, in denen sich die Informationen häufig ändern, wie z. B. Marktentwicklungen, regulatorische Compliance, technische Fehlerbehebung und wissenschaftliche Forschung.
Verbesserte Benutzererfahrung
Durch das Abrufen und Integrieren der relevantesten Informationen ermöglicht RAG, dass die KI vollständigere und sinnvollere Antworten auf Benutzeranfragen liefert.
Dies führt zu besseren Entscheidungen, erhöhter Effizienz und einer benutzerfreundlicheren Interaktion mit der KI.
Einrichten einer Arcana
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Die Prozess-Screenshots enthalten leere Felder. Diese werden an den Stellen durch Ihren Benutzernamen ersetzt.
Erster Login
Gehen Sie zur Haupt-Arcana-Seite und klicken Sie auf „Registrieren“. Sie müssen sich zunächst mit Ihrem Academic Cloud-Konto anmelden.
Die Registrierungsseite des RAG-Managers begrüßt den Nutzer, zeigt das Academic Cloud-Profil und enthält einen Button zum Registrieren für den Dienst durch Bestätigung der Details.
Sobald dies abgeschlossen ist, können Sie nun zur Dashboard-Oberfläche wechseln, die wie folgt aussieht:
Das Arcana-Manager-Dashboard hat einen Hauptbereich und eine Menüleiste. Die Menüleiste enthält die Registerkarten „Startseite“, „Arcanas“, „Profil“ und „Dokumentation“. Der Hauptbereich enthält einen Bereich „Schnellzugriff“ und die „Schnellstart-Anleitung“. Am unteren Rand der Seite befinden sich Links zu Datenschutz und Nutzungsbedingungen.
Sie finden eine Übersicht über Ihr Profil unter der Registerkarte „Profil“. Hier können Sie auch Ihre Profildaten löschen.
Die Benutzerprofil-Registerkarte zeigt die Kontoinformationen und ein rotes Feld mit der Aufschrift „Gefahrenzone“, das einen Button zum Löschen des Kontos enthält.
Erstellen einer Arcana
Sobald das Dashboard geöffnet ist, können Sie zur Registerkarte „Arcanas“ wechseln, indem Sie entweder oben im Menü auf sie klicken oder auf das „Meine Arcanas“-Feld klicken. In der Registerkarte „Arcanas“ öffnet „+ Neue Arcana hinzufügen“ das Erstellungs-Popup. Zuerst müssen Sie einen Namen für diese Arcana angeben.
Der Haupt-Arcana-Manager zeigt nach Klicken auf die Schaltfläche „Neue Arcana“ ein Fenster, in dem ein Name festgelegt und eine neue Arcana erstellt werden kann.
Wenn Sie den Schieberegler „Sichere Arcana-Name“ aktivieren, wird ein zufälliger String an den Arcana-Namen angehängt. Dies stellt sicher, dass nur Nutzer, die den exakten Arcana-Namen kennen, mit ihr chatten können.
Hinweis: Alle Ihre Arcanas sind standardmäßig öffentlich! Das bedeutet, dass jeder, der den exakten Arcana-Namen kennt, mit ihr chatten kann. Dies bedeutet jedoch nicht, dass sie direkt auf Ihre Dateien zugreifen können.
Sobald die Arcana erstellt ist, sollte sie in Ihrer Arcana-Liste erscheinen.
Der Arcana-Manager enthält nun eine neue Arcana, die noch nicht indiziert ist und keine Dateien enthält. Die Aktionen-Spalte enthält eine Schaltfläche zum Öffnen des Ordners, Löschen und Zugangslink.
Durch Klicken auf eine Arcana können Sie deren Inhalt anzeigen.
Das Menü für diese neue Arcana hat vier Schaltflächen oben: Datei hochladen, Zugangslink, Indexgenerierung und Arcana löschen. Die Tabelle unten enthält derzeit keine Dateien.
Hochladen von Dateien
Klicken Sie auf der Arcana-Seite auf „Dateien hochladen“, um Ihre Dateien hinzuzufügen.
Das Fenster zum Hochladen einer neuen Datei hat eine Schaltfläche zum Auswählen einer Datei sowie eine Abbrechen- und Fertig-Schaltfläche.
Wählen Sie eine oder mehrere Dateien zum Hochladen aus. Sie können Dateien verschiedener Typen hochladen. Folgende Dateiformate werden unterstützt:
Sobald die Dateien hochgeladen sind, sollten sie erscheinen.
Nach dem Hochladen zeigt das Menü dieser Arcana nun die Datei an, die noch nicht indiziert und nicht konvertiert ist.
Sie können die Dateidetails anzeigen, indem Sie auf das „Datei-Info“-Symbol neben jeder Datei klicken.
Das Fenster „Datei-Details“ zeigt die Dateiinformationen sowie den Status. Außerdem gibt es die Möglichkeit, die verarbeitete Markdown-Plus-Datei sowie eine JSON-Datei herunterzuladen. Außerdem kann eine neue Markdown-Plus-Datei hochgeladen werden.
Dies ist auch die Seite, auf der Sie nach der Indexgenerierung die Docling-JSON-Datei oder die annotierte Markdown-Datei herunterladen können. Zusätzlich haben Sie die Möglichkeit, eine neue Version der Datei hochzuladen. Besonders wichtig ist, dass Sie die Markdown-Datei herunterladen und die in der Docling-Prozess beschriebenen Marker anpassen können. Dies ist sehr nützlich, um die Segmentierung und Markierung der Datei für eine bessere Indizierung und Abfrage zu verfeinern. Sobald diese Änderungen vorgenommen wurden, startet das Hochladen einen Prüfprozess, um sicherzustellen, dass der Inhalt weiterhin mit dem hochgeladenen Material übereinstimmt.
Nachdem die Datei oder die Dateien hochgeladen sind, können Sie die Indexgenerierung und Dateikonvertierung starten, indem Sie auf „Indexgenerierung“ klicken.
Klicken auf „Index generieren“ öffnet ein kleines Fenster, in dem der Benutzer bestätigen muss, dass der Index generiert werden soll.
Dies ändert den Status zunächst in „Ausstehend“ (blau) und schließlich in „Indiziert“ (grün).
Der Indexstatus hat sich von „Nicht indiziert“ in „Ausstehend“ geändert.
Der Indexstatus hat sich in „Indiziert“ geändert.
Anzeigen Ihres Zugangslinks
Sobald Ihre Arcana indiziert ist, können Sie den Zugangslink generieren und die ID für diese Arcana abrufen. Klicken Sie auf „Zugangslink“ in der Aktionen-Spalte der jeweiligen Arcana, um ihn zu generieren.
Sobald der Zugangslink erstellt ist, wird er angezeigt, der kopiert werden kann, sowie die Arcana-ID.
Sie können auf den Link klicken oder ihn in ein neues Tab kopieren, was Chat AI mit der voreingestellten Arcana-ID im erweiterten Bereich öffnet.
Das Chat-AI-Fenster hat die Arcana-ID bereits ausgefüllt.
Sie können nun den Link sowie die IDs dieser Arcana teilen.
Aktualisieren von Dateien in einer Arcana
Es gibt die Möglichkeit, die Anmerkungen für hochgeladene Dateien herunterzuladen und anzupassen oder frühere manuelle oder automatisch generierte Anmerkungen zu ändern. Nachdem die Datei hochgeladen und verarbeitet wurde, können Sie ihre Anmerkungen bei Bedarf aktualisieren.
Die Detailansicht für eine PDF-Datei sieht wie folgt aus:
Das Fenster „Datei-Details“ für eine PDF-Datei zeigt Informationen zur Datei sowie den Index- und Konvertierungsstatus. Unten befindet sich die Möglichkeit, die JSON-Ausgabe des Docling-Prozesses herunterzuladen. Am unteren Rand gibt es die Option, die annotierte Markdown-Datei herunterzuladen, eine aktualisierte Datei hochzuladen und die annotierte Markdown-Datei zurückzusetzen.
Für alle Dateitypen steht die Möglichkeit zur Verfügung, die annotierte Text-/Markdown-Datei herunterzuladen. Bei PDF-Dateien wird diese annotierte Markdown-Datei – auch Markdown Plus genannt – automatisch durch den Docling-Prozess generiert. Zusätzlich besteht die Möglichkeit, eine manuell annotierte Datei (Text oder Markdown) hochzuladen. Dies ist sehr nützlich, um Anmerkungen manuell festzulegen oder zu aktualisieren. Außerdem können viele Dateien eine JSON-Datei aus dem Docling-Prozess heruntergeladen und angezeigt werden.
Die verfügbaren Anmerkungen werden im Docling-Prozess unter dem Abschnitt Markdown Plus-Anmerkungen erläutert.
Info
Teilweise annotierte Dateien funktionieren nicht. Sie müssen entweder vollständig annotiert oder gar nicht annotiert sein.
So verwenden Sie Arcana
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Warnung
Bisher funktionierte RAG/Arcana nur mit bestimmten Modellen. Dies ist nicht mehr der Fall – Arcana funktionieren nun mit jedem Modell. Die bisherige Methode, Arcana mit Modellen zu verwenden, die im Namen „RAG“ enthalten (oder das kleine Buch-Symbol haben), wird in Zukunft nicht mehr unterstützt. Bitte verwenden Sie die GWDG-Werkzeuge gemäß der untenstehenden Anleitung!
Diese Anleitung führt Sie durch zwei Hauptmethoden, um auf eine Arcana zuzugreifen:
Schnellstart: Verwenden eines Zugangslinks (empfohlen für Anfänger)
Erweitert: Manueller Zugriff über die Arcana-ID (für Fortgeschrittene und Integration)
Schnellstart: Verwenden eines Zugangslinks (Einfachste Methode)
Wenn Ihnen ein Zugangslink zu einer Arcana zur Verfügung gestellt wurde (z. B. für eine Forschungsarbeit, Lehrmaterial oder eine institutionelle Dokumentation) oder wenn Sie Ihren eigenen nach der Anleitung zum Starten erstellt haben, ist dies die schnellste und einfachste Möglichkeit, zu beginnen.
Schritte
Klicken Sie auf den Zugangslink, den der Arcana-Besitzer oder Sie selbst geteilt haben.
Dies öffnet eine vorkonfigurierte Chat-AI-Oberfläche, die automatisch für diese Arcana konfiguriert ist.
Beginnen Sie mit Fragen stellen – das System sucht relevante Inhalte aus dem indizierten Material heraus und generiert Antworten, die auf der Quelle basieren.
Manueller Zugriff: Verwenden der Arcana-ID
Für mehr Kontrolle können Sie eine Arcana auch manuell über ihre eindeutige Arcana-ID verbinden. Die Arcana-ID ist auch erforderlich, wenn Sie mit einer Arcana über die Chat-Vervollständigungs-API interagieren.
Aktivieren Sie im Einstellungsmenü (rechte Seite) die Option GWDG-Werkzeuge.
Geben Sie in das Feld Arcana die Arcana-ID ein (z. B. user1/arcana-123456).
Wählen Sie das empfohlene Modell: Qwen 3 30B A3B Instruct 2507
Info
Wenn Sie die Meldung „Tools konnten nicht verwendet werden: Werkzeuge möglicherweise nicht unterstützt“ erhalten, während Sie mit RAG interagieren, wechseln Sie zu diesem Modell – es ist für werkzeugbasierte Abfragen optimiert.
Passen Sie temperature und top_p auf den niedrigsten möglichen Wert an.
Beginnen Sie mit der Interaktion mit der Arcana über die Chat-Oberfläche.
Info
Obwohl Arcana und GWDG-Werkzeuge mit anderen Modellen funktionieren können, liefert Qwen 3 30B A3B Instruct 2507 die konsistenteste Leistung mit der RAG-Funktion.
Generieren eines Zugangslinks für eine Arcana
Um einen Zugangslink für Ihre Arcana zu generieren, folgen Sie dem Abschnitt Anzeigen Ihres Zugangslinks in der Anleitung zum Starten.
Best Practices für eine effektive Nutzung
Um qualitativ hochwertige, genaue Antworten zu erhalten, beachten Sie diese Empfehlungen:
1. Anpassen von „temperature“ und „top_p“
Für Arcana empfehlen wir, „temperature“ auf 0,0 und „top_p“ auf 0,05 zu setzen, um optimale Ergebnisse zu erzielen. Weitere Informationen zur Wirkung von „temperature“ und „top_p“ finden Sie im Abschnitt Vervollständigungsoptionen der Chat-AI-Dokumentation.
2. Verwenden Sie spezifische Stichwörter aus der Quelle
Unser RAG-System verarbeitet Dokumente, indem es PDFs in strukturierte Markdown konvertiert. Die LLM-Antwort wird dann verbessert, indem relevante Informationen aus diesen Dokumenten für Ihren Prompt extrahiert werden. Weitere Informationen finden Sie im Docling-Prozess.
Fügen Sie Begriffe, Phrasen oder Konzepte aus dem Originaldokument in Ihren Prompt ein:
Vage: „Erzählen Sie mir etwas über dieses Datenset.“
Spezifisch: „Welche Bewertungsmetriken wurden im ImageNet-Test verwendet?“
3. Anpassen des Systemprompts
Für wichtige Arcana (z. B. Lernhilfen, Laborprotokolle oder wissenschaftliche Arbeiten) passen Sie den Systemprompt an, um den gewünschten Ton, das Format und die Antwortart zu definieren.
Beispiel
Sie sind eine hilfreiche Assistentin namens Sandra, die bereits viele Jahre bei der GWDG arbeitet. Beantworten Sie präzise die gestellte Frage.
Sie erhalten am Anfang Referenzen, die hilfreich sein könnten.
Wenn Sie die Antwort nicht kennen, geben Sie ehrlich an, dass Sie die Details nicht kennen.
Verweisen Sie bei Ihrer Antwort auf die verwendeten Quellen mit der [REF-Nummer]-Syntax, so nah wie möglich an der Verwendung.
Wenn die bereitgestellten Referenzen verwirrend sind, können Sie den Benutzer bitten, die notwendigen Details bereitzustellen, um zu identifizieren, welche zu verwenden sind.
4. Überprüfen der Referenzen in der Antwort
Nach jeder Abfrage liefert das System:
Die Antwort, angereichert mit Kontext aus dem indizierten Material.
Referenzen unter der Antwort, darunter:
Name der Quelldatei (z. B. imagenet.pdf)
Seitenangabe
Referenzen werden in Markdown gerendert, sodass Sie jeden Anspruch auf seine ursprüngliche Quelle zurückverfolgen können. Ursprünglich könnte die Information in einer PDF-Datei enthalten gewesen sein, die in eine annotierte Markdown-Datei konvertiert wurde, wie Sie im Docling-Prozess nachlesen können.
Beispiel
Prompt: Was ist ImageNet?
Beispielantwort: ImageNet ist eine große Ontologie von Bildern, die auf der Struktur von WordNet basiert. Sie soll die Mehrheit der 80.000 Synsets von WordNet mit durchschnittlich 500 bis 1000 sauberen und hochauflösenden Bildern füllen, was zu Millionen von annotierten Bildern führt, die nach der semantischen Hierarchie von WordNet organisiert sind.
Arcana-Beispiel
Die Antwort enthält Quellenreferenzen aus der ursprünglichen ImageNet-PDF.
API-Nutzung
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Der Arcana-Manager stellt einen API-Endpunkt zur Verfügung, den Sie nutzen können. Mit diesem Endpunkt können Sie alle Aktionen durchführen, die die Frontend-Oberfläche des Arcana-Managers unterstützt.
Um die API zu nutzen, benötigen Sie zunächst einen API-Schlüssel, den Sie auf unserer Website beantragen können. Dieser Schlüssel funktioniert über alle unsere Dienste hinweg. Wenn Sie bereits die LLMs über die API nutzen, können Sie denselben Schlüssel verwenden. Andernfalls können Sie Ihren Schlüssel gemäß der Anleitung beantragen.
Info
Wenn Sie mit einer Arcana über die LLM-Chat-Vervollständigungs-API chatten möchten, verweisen wir auf diesen Abschnitt in der SAIA-Dokumentation.
Basis-Route
Alle Routen für die RAG/Arcana-API beginnen mit https://chat-ai.academiccloud.de/v1/arcanas/api/v1/
Beachten Sie, dass jeder API-Aufruf mit https://chat-ai.academiccloud.de/v1/ beginnen muss. Routen, die mit https://chat-ai.academiccloud.de/arcanas/ beginnen, sind nicht mit API-Schlüsseln kompatibel.
Die Antwort ist null mit einem Statuscode von 200, falls der Upload erfolgreich war.
Eine Arcana indizieren
Die Indexerstellung erfolgt synchron, d. h., die HTTP-Anfrage antwortet erst, wenn der Index erstellt wurde. Wenn die Anfrage abgebrochen wird, wird die Indexerstellung im Hintergrund weiterhin abgeschlossen.
Vollständige Liste der Routen
Die Liste aller verfügbaren Routen finden Sie unter:
Im Web-Browser: https://chat-ai.academiccloud.de/arcanas/api/v1/docs
Über die API: https://chat-ai.academiccloud.de/v1/arcanas/api/v1/openapi.json
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Der RAG-Dienst bietet Nutzern eine effiziente Möglichkeit, PDF-Dokumente über Docling hochzuladen und zu verarbeiten. Das System konvertiert hochgeladene PDFs in Markdown-Format und annotiert sie automatisch. Die erweiterte Markdown-Ausgabe, auch als Markdown Plus bezeichnet, enthält Metadaten und strukturelle Anmerkungen, die die Dokumentenverarbeitung und Anpassung verbessern.
Dieser Dienst verwendet eine abgeänderte Fork der Docling-API mit zahlreichen Anpassungen, die in Zukunft veröffentlicht werden.
Verarbeitungsablauf
Datei-Upload: Nutzer laden ihre PDF-Dokumente über die RAG-Oberfläche hoch.
Konvertierungsprozess: Sobald die PDF-Datei hochgeladen ist, kann der Nutzer sie in das Markdown-Plus-Format konvertieren, indem er auf „Indexgenerierung“ → „Index generieren“ klickt. Dieser Vorgang konvertiert auch die Dateien.
Anmerkungen und Metadaten: Die Markdown-Plus-Ausgabe wird automatisch mit strukturellen Markern versehen.
Durch Klicken auf das „Datei-Info“-Symbol rechts können Nutzer die annotierte Markdown-Datei herunterladen, Split-Marker anpassen und erneut hochladen, um die Verarbeitung fortzusetzen.
Das Fenster „Datei-Details“ zeigt alle Dateiinformationen sowie die Möglichkeit, entweder die JSON- oder die Markdown-Plus-Datei herunterzuladen. Außerdem gibt es die Option, eine aktualisierte Markdown-Plus-Datei hochzuladen.
Validierung: Beim erneuten Hochladen wird ein Validierungsprozess durchgeführt, um sicherzustellen, dass die Seiteneinteilung intakt bleibt.
Markdown Plus-Anmerkungen
Docling generiert eine strukturierte und annotierte Markdown-Datei unter Verwendung der folgenden Marker:
1. Seitenumbruch-Marker
Format: [Seite (Nummer)]: #
Zweck: Zeigt den Beginn einer neuen Seite im ursprünglichen PDF-Dokument an.
Beispiel:
[Seite 1]: #
2. Vertikaler Positionsmarker
Format: [Y: (Zahl)]: #
Zweck: Repräsentiert die ungefähre vertikale Position eines Elements auf der Seite (die Seitenhöhe wird auf 1000 Zeilen skaliert).
Details:
Jede Seite ist in fünf Abschnitte unterteilt.
Wenn in einem bestimmten Abschnitt kein kontinuierliches Element (wie eine Tabelle oder ein Bild) vorhanden ist, wird ein Y-Marker zugewiesen.
Beispiel:
[Y: 300]: #
3. Spaltungs-Marker
Format: [Spalten]: #
Zweck: Definiert Segmentierungspunkte im Dokument für die nachfolgende Verarbeitung.
Nutzung:
Die Spaltungs-Marker leiten die Dokumenten-Chunking für nachgeschaltete Anwendungen.
Nutzer können die Spaltungs-Marker in der Markdown-Plus-Datei vor dem erneuten Hochladen manuell anpassen.
Beispiel:
[Spalten]: #
Metadaten-Kopfzeile
Jede annotierte Markdown-Datei enthält einen Kopfzeilenabschnitt mit Metadaten zum Dokument, darunter:
Autor
Titel
Beschreibung
Dateiname
Erweiterung
Anzahl der Seiten
Version
Beispiel:
---
Autor: jkunkel1
Titel: Titel der Datei
Beschreibung: ''
Dateiname: Dateiname
Erweiterung: pdf
Anzahl der Seiten: 20
Version: 1.0
---
Nutzerinteraktion mit annotierter Markdown-Datei
Markdown Plus herunterladen: Nutzer können die annotierte Markdown-Datei für die Überprüfung exportieren.
Spaltungs-Marker bearbeiten: Falls gewünscht, können Nutzer die [Spalten]: #-Marker manuell bearbeiten, um die Segmentierung anzupassen.
Geänderte Datei erneut hochladen: Das System überprüft, ob die Seiteneinteilung unverändert bleibt, bevor es die Dokumentverarbeitung fortsetzt.
Öffentliche Arcana-Links
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Hier finden Sie eine Liste öffentlicher Links zu Arcanas. Die Links sind nach Kategorien sortiert und enthalten öffentliche Inhalte. Bitte ziehen Sie den Abschnitt „So verwenden Sie Arcana“ heran, falls Sie Hilfe bei der Nutzung benötigen.
Beispiel-Frage: Wie funktioniert der Studiengang angewandte Informatik?
Falls Sie einen defekten Link finden, teilen Sie uns dies bitte über unsere Support-Kontakte mit.
Support und FAQ
Warnung
Dieser Dienst befindet sich derzeit in der Beta-Phase und wird regelmäßig aktualisiert. Das gilt auch für die Dokumentation.
Wenn Sie Probleme bei der Nutzung dieses Dienstes haben, kontaktieren Sie bitte unseren KISSKI-Support.
Wir benötigen außerdem Ihre Unterstützung, um öffentlich verfügbare Arcana-Links bereitzustellen. Falls Sie einen Link haben, den Sie für eine größere Nutzergruppe relevant finden, kontaktieren Sie uns bitte, damit wir ihn veröffentlichen können.
FAQ
Welche Modelle unterstützen RAG (Retrieval-Augmented Generation)?
Alle internen Modelle funktionieren mit den GWDG-Werkzeugen und Arcanas. Allerdings sind einige Modelle besser darin, Werkzeuge zu nutzen als andere!
Wir empfehlen:Qwen 3 30B A3B Instruct 2507 für die besten Ergebnisse bei Werkzeugaufrufen und Dokumentenabruf.
Wir empfehlen NICHT:Meta Llama 3.1 8B Instruct, da es nicht für Werkzeugaufrufe optimiert ist!
Info
Externe Modelle unterstützen keine Arcanas/RAG!
Wie groß darf meine Datei maximal sein?
Sie können Dateien bis zu 300 MB pro Datei hochladen. Für optimale Leistung empfehlen wir, Dateien unter 50 MB zu halten – größere Dateien können länger zum Verarbeiten benötigen.
Welche Dateitypen werden unterstützt?
Die folgenden Formate werden vollständig unterstützt:
Alle Dateien werden während des Indexierungsprozesses in ein maschinenlesbares (Markdown-)Format konvertiert.
Werden meine Daten gespeichert? Wo werden sie gespeichert?
Ihre Dokumente und indizierten Daten bleiben ausschließlich auf GWDG-Systemen. Wir speichern, teilen oder übertragen Ihre Daten nicht an Dritte. Ihr Datenschutz und Ihre Datensicherheit sind unsere höchste Priorität.
Kann ich meine Arcana teilen?
Ja – Arcanas können frei mit anderen Nutzern geteilt werden. Um zu teilen, geben Sie einfach die Arcana-ID oder den vollständigen Arcana-Namen weiter.
Info
Standardmäßig ist jede Arcana öffentlich. Das bedeutet, dass jeder, der Ihren Benutzernamen und den exakten Arcana-Namen kennt, darauf zugreifen kann. Allerdings können sie Ihre hochgeladenen Dateien nicht anzeigen oder bearbeiten – sie können nur über die Chat-Oberfläche mit der Arcana interagieren.
Wie erstelle ich eine private Arcana?
Um Ihre Arcana privat zu halten, aktivieren Sie beim Erstellen die Option „Sichere Arcana-Name“. Dies fügt einen zufälligen, eindeutigen Sicherheitstoken zum Arcana-Namen hinzu, sodass sie nur für Sie oder alle, die den vollständigen, exakten Namen kennen, zugänglich ist.
Wie funktioniert RAG (Retrieval-Augmented Generation)?
RAG verbessert große Sprachmodelle (LLMs), indem es Dokumentenabruf mit generativer KI kombiniert.
So funktioniert es:
Ihre Anfrage wird mit einer Wissensbasis (Ihren hochgeladenen Dokumenten) abgeglichen.
Das System ruft die relevantesten Passagen (5 Passagen) ab.
Das LLM nutzt diesen Kontext, um genaue, fundierte und kontextuell relevante Antworten zu generieren.
Dies ermöglicht es dem Modell, über sein Trainingswissen hinaus auf externe Kenntnisse zuzugreifen, was zu folgenden Ergebnissen führt:
Höhere Faktengenauigkeit
Kohärentere und relevantere Antworten
Geringere Halluzinationen
Wie werden meine Anfragen verarbeitet?
Jeder Schritt Ihrer Anfrage wird vollständig auf GWDG-Infrastruktur durchgeführt:
Generierung von Dokumenten-Embeddings
Abruf relevanter Inhalte
Endgültige Inferenz und Antwortgenerierung
Ihre Daten und Anfragen verlassen niemals die GWDG-Systeme und werden nicht an Dritte weitergegeben.
Warum dauert das Indexieren so lange?
Das Indexieren erfordert fortschrittliche maschinelle Lernalgorithmen, um komplexe Dokumente (wie .docx, .pdf, .pptx) in ein strukturiertes, maschinenlesbares Format (Markdown) zu konvertieren.
Dieser Prozess kann Zeit in Anspruch nehmen, besonders bei:
Großen Dateien (>50 MB)
Dokumenten mit komplexen Layouts, Bildern oder Tabellen
Um das Indexieren zu beschleunigen, halten Sie die Dateigröße unter 50 MB und vermeiden Sie übermäßig komplexe Formatierungen.
Weitere Fragen?
Teilen Sie uns mit, wenn Sie weitere Fragen haben!
Chat AI
Chat AI ist ein Webdienst, der über eine funktionenreiche, benutzerfreundliche Oberfläche Zugriff auf eine große Auswahl an großen Sprachmodellen (LLMs) bietet. Er bietet eine sorgfältig ausgewählte Auswahl beliebter Open-Weight-Modelle, die in unserem eigenen Rechenzentrum laufen, sowie anonymen Zugriff auf externe Modelle von kommerziellen Anbietern.
Die Web-Oberfläche wird auf der Cloud-Infrastruktur von GWDG gehostet und leitet Ihre Anfragen sicher über unseren skalierbaren SAIA-Backend-Service an das ausgewählte Modell weiter, wobei entweder auf lokale HPC-Hardware oder, bei Modellen, die als extern gekennzeichnet sind, auf den Service-Endpunkt des kommerziellen Anbieters umgeleitet wird. Unser KI-Team aktualisiert die Liste der unterstützten Modelle regelmäßig und entwickelt kontinuierlich neue Funktionen.
Chat AI ist unsere datenschutzfreundliche, sichere Alternative zu kommerziellen LLM-Diensten: Wir garantieren, dass Ihre Chatverläufe und andere Nutzerdaten nicht auf unseren Systemen gespeichert werden.1
Der Dienst ist über seine Web-Oberfläche erreichbar. Um die Modelle über die API zu nutzen, verweisen wir auf API-Antrag, und um die Modelle über Visual Studio Code zu nutzen, verweisen wir auf CoCo AI.
Wenn Sie lediglich eine schnelle Änderung Ihrer Persönlichkeit (Persona) benötigen, ist dieser der richtige Ort für Sie.
Tipp
Sie benötigen ein Academic Cloud-Konto, um auf die KI-Dienste zugreifen zu können. Verwenden Sie die federierte Anmeldung oder erstellen Sie ein neues Konto. Details finden Sie auf dieser Seite.
Aktuelle Modelle
Chat AI hostet derzeit eine große Auswahl hochwertiger, quelloffener Modelle. Alle Modelle außer ChatGPT werden selbst gehostet und garantieren die höchsten Standards im Bereich Datenschutz. Diese Modelle laufen vollständig auf unserer Hardware und speichern keine Nutzerdaten.
Für detaillierte Informationen zu allen unseren Modellen verweisen wir auf verfügbare Modelle.
Web-Oberfläche und Nutzung
Wenn Sie ein Academic Cloud-Konto besitzen, können Sie die Web-Oberfläche auch einfach über chat-ai.academiccloud.de erreichen. Alle Modelle von Chat AI sind für alle Nutzer kostenlos nutzbar, mit Ausnahme der Modelle von OpenAI und Anthropic. Diese sind in der Modellauswahl der Web-Oberfläche als „(Extern)“ gekennzeichnet.
Wählen Sie aus den verfügbaren Modellen ein Modell aus, das Ihren Bedürfnissen entspricht. Nachdem Sie die Grundlagen der Nutzung erlernt haben, erfahren Sie mehr über die erweiterten Funktionen von ChatAI hier.
Aus der Web-Oberfläche heraus gibt es integrierte Aktionen, die Ihre Prompts erleichtern oder verbessern können. Dazu gehören:
Anhängen (+-Button): Fügen Sie Dateien hinzu, die das Modell als Kontext für Ihre Prompts verwenden kann.
Hören (Mikrofon-Button): Sprechen Sie dem Modell stattdessen zu, anstatt zu tippen.
Importieren/Exportieren (Upload/Download-Button): Wenn Sie Gespräche aus einer vorherigen ChatAI-Sitzung oder einem anderen Dienst heruntergeladen haben, können Sie diese Sitzung importieren und fortsetzen.
Fußzeile (Pfeil unten): Wechseln Sie zur Ansicht mit Fußzeile, die „Nutzungsbedingungen“, „FAQ“ usw. enthält und die Möglichkeit bietet, zwischen Deutsch und Englisch zu wechseln.
Hell/Dunkelmodus (Sonne/Mond-Button): Wechseln Sie zwischen hellen und dunklen Modus.
Optionen: Weitere Konfigurationsoptionen zur Feinabstimmung Ihrer Prompts und Modelle. Dazu gehören:
Systemprompt, der die Rolle definiert, die das Modell für Ihre Prompts übernehmen soll. Das Beispiel mit dem Vorstellungsgespräch oben ist ein solches Beispiel.
Teilen-Button, der eine freigabefähige URL für Chat AI generiert, die Ihr aktuelles Modell, Ihren Systemprompt und andere Einstellungen lädt. Beachten Sie, dass dies Ihren Gesprächsverlauf nicht enthält.
Löschen-Button, der alle Daten löscht, die im Browser gespeichert sind, wodurch Ihre Gespräche und Einstellungen entfernt werden.
Speicher-Einstellungen: Das System unterstützt drei Speichermodi zur Steuerung des Gesprächs-Kontexts:
Kein Speicher: Deaktiviert den Speicher – jedes Gespräch wird unabhängig behandelt.
Erinnern: Fügt vorherige Nachrichten zum Systemprompt hinzu, um einen kontinuierlichen Kontext zu gewährleisten.
Lernen: Erweitert „Erinnern“ durch Aktualisierung des Speichers mit relevanten Teilen des aktuellen Gesprächs, was einen natürlicheren Dialogfluss ermöglicht.
Hinweis: Der Speicher wird lokal im Browser gespeichert und beeinflusst externe (OpenAI) Modelle nicht.
Wir empfehlen, vor Beginn Ihrer Sitzung einen Systemprompt festzulegen, um die Rolle zu definieren, die das Modell übernehmen soll. Ein detaillierterer Systemprompt ist in der Regel besser. Beispiele:
„Ich werde Fragen zum Data Science stellen, zu denen ich detaillierte Antworten mit Beispielcode, falls relevant, und Zitaten zu mindestens drei Forschungsarbeiten zum jeweiligen Thema in jeder Frage möchte.“
„Ich möchte den folgenden Text mit 40 % Kompression zusammenfassen. Geben Sie eine englische und eine deutsche Übersetzung an.“
„Sie sind ein schwieriger Vorstellungsgesprächs-Interviewer bei der Deutschen Bahn und ich bewerbe mich um eine Stelle als Schaffner.“
Vervollständigungsoptionen
Zwei wichtige Konzepte unter den Vervollständigungsoptionen sind Temperature und top_p Sampling.
temperature ist ein Schieberegler von 0 bis 2, der die Kreativität anpasst, wobei Werte nahe 0 vorhersehbarer und Werte nahe 2 kreativer sind. Dies geschieht, indem die Wahrscheinlichkeiten für das nächste Token (Baustein der Antwort) erweitert oder abgeflacht werden.
top_p ist ein Schieberegler von 0 bis 1, der die Gesamtmenge der Wahrscheinlichkeiten anpasst, die für das nächste Token berücksichtigt werden. Ein top_p von 0,1 bedeutet, dass nur die oberen 10 % der kumulativen Wahrscheinlichkeiten berücksichtigt werden. Die Variation von top_p hat einen ähnlichen Effekt auf Vorhersehbarkeit und Kreativität wie temperature, wobei größere Werte als kreativer gelten.
Für vorhersehbare Ergebnisse, z. B. bei Programmieraufgaben, sind niedrige Werte für beide Parameter erforderlich, während kreative Ergebnisse, z. B. bei Brainstorming, hohe Werte erfordern. Weitere Empfehlungen finden Sie in der Tabelle im Abschnitt verfügbare Modelle.
Funktionen
Ausführlichere Dokumentation zu allen Funktionen finden Sie hier.
Im Einstellungsfenster finden Sie die Möglichkeit, Tools zu aktivieren. Sobald aktiviert, sind diese Tools verfügbar:
Web-Suche
Bildgenerierung
Bildbearbeitung
Text-zu-Sprache (TTS)
Außerdem müssen Sie die Tools in den Einstellungen aktivieren, wenn Sie Toolbox nutzen möchten, also die Bild-, Video- und Audio-Funktionen der Modelle nutzen möchten.
Info
Diese Tools funktionieren nur mit Modellen, die von GWDG und KISSKI gehostet werden. Externe Modelle von OpenAI funktionieren nicht mit den Tools.
Web-Suche
Dieses Tool erstellt eine Suchanfrage, die mit Suchmaschinen verwendet werden kann. Der gesamte Chatverlauf wird verwendet und verarbeitet, um eine kurze Suchanfrage zu erstellen, die eine verarbeitbare Antwort generiert. Sobald die Antwort von der Suchmaschine abgerufen ist, wird sie zusammen mit dem Modell verwendet, um eine Antwort auf die Eingabe zu verfassen.
Wichtigster Vorteil: Die Antwort kann aktuelle Informationen enthalten, anstatt die veralteten Informationen zu verwenden, die im ausgewählten Modell enthalten sind.
Wir danken Priyeshkumar Chikhaliya für die Gestaltung und Implementierung der Web-Oberfläche.
Wir danken allen Kollegen und Partnern, die an diesem Projekt beteiligt sind.
Zitierweise
Wenn Sie Chat AI in Ihrer Forschung, Dienstleistungen oder Publikationen verwenden, zitieren Sie uns bitte wie folgt:
@article{doosthosseini_saia_2026,
    title = {{SAIA}: a seamless {Slurm}-native solution for {HPC}-based services},
    volume = {82},
    issn = {1573-0484},
    url = {https://doi.org/10.1007/s11227-026-08508-3},
    doi = {10.1007/s11227-026-08508-3},
    number = {7},
    journal = {The Journal of Supercomputing},
    author = {Doosthosseini, Ali and Decker, Jonathan and Nolte, Hendrik and Kunkel, Julian},
    month = may,
    year = {2026},
    pages = {403},
}
Weitere Dienste
Falls Sie Fragen haben, lesen Sie zunächst die FAQ. Für detailliertere Informationen zur Funktionsweise des Dienstes können Sie unseren Forschungsartikel hier lesen. Falls Sie spezifischere Fragen haben, kontaktieren Sie uns gerne unter kisski-support@gwdg.de.
Ausnahmen gelten, siehe unsere Nutzungsbedingungen. Zum Beispiel werden Daten, die Sie bewusst mithilfe von Arcana speichern, aus Gründen der Funktionalität beabsichtigt behalten. ↩︎
Unterabschnitte von Chat AI
Chat AI FAQ
Datenschutz
Werden meine Gespräche oder Nutzungsdaten für die KI-Weiterbildung oder ähnliche Zwecke verwendet?
Nein, unabhängig davon, ob Sie interne oder externe Modelle nutzen: Ihre Gespräche und Daten werden nicht zur Weiterbildung von KI-Modellen verwendet.
Wenn ich interne Modelle verwende, werden meine Nachrichten und Gespräche zu irgendeinem Zeitpunkt auf Ihren Servern gespeichert?
Nein, Nutzernachrichten und KI-Antworten werden zu keinem Zeitpunkt auf unseren Servern gespeichert. Sobald Ihre Nachricht gesendet und die Antwort erhalten wurde, ist das Gespräch nur noch in Ihrem Browser verfügbar.
Welche Daten speichert Chat AI, wenn ich den Dienst nutze?
Wir speichern keine Gespräche oder Nachrichten auf unseren Servern. Wir erfassen lediglich einige Nutzungsstatistiken, um die Auslastung unseres Dienstes zu überwachen und die Benutzererfahrung zu verbessern. Dazu gehören Benutzernamen, Zeitstempel und die angeforderten Modelle/Dienste. Alles andere, was der Chatbot sich merkt (z. B. der Verlauf Ihres letzten Gesprächs), wird ausschließlich lokal in Ihrem Browser gespeichert.
Wenn ich externe Modelle nutze, werden meine Nachrichten und Gespräche zu irgendeinem Zeitpunkt auf Microsofts Servern gespeichert?
Obwohl wir keine Gespräche oder Nachrichten auf unseren Servern speichern, behält Microsoft das Recht, Nachrichten/Gespräche bis zu 30 Tage lang zu speichern, um Missbrauch zu verhindern. Da die Anfrage direkt von GWDGs Servern an Microsoft gesendet wird, enthält sie keine Nutzerinformationen. Weitere Informationen finden Sie hier: learn.microsoft.com/en-us/legal/cognitive-services/openai/data-privacy
Verfügbarkeit
Meine Institution ist an der Nutzung von Chat AI interessiert. Können wir es für unsere Nutzer bewerben? Könnten Sie eine zusätzliche Last für XXX Nutzer bewältigen?
Für große Institutionen kontaktieren Sie uns bitte direkt unter info@kisski.de.
Sind alle Modelle in Chat AI kostenlos verfügbar?
Alle Modelle, die mit einem Academic Cloud-Konto zugänglich sind, sind kostenlos nutzbar, mit Ausnahme der OpenAI GPT… (externen) Modelle. Diese Modelle sind nur für die Max-Planck-Gesellschaft, Mitglieder der Universität Göttingen sowie über kostenpflichtige Verträge verfügbar.
Nutzung
Warum antwortet das Modell xxx länger als gewöhnlich?
Es gibt mehrere mögliche Gründe dafür.
Wahrscheinlich ist Ihr Gesprächsverlauf im Laufe der Zeit größer geworden, ohne dass Sie ihn gelöscht haben. Beachten Sie, dass jedes Mal, wenn Sie eine Nachricht senden, der gesamte Gesprächsverlauf vom Modell verarbeitet werden muss. Ein langer Gesprächsverlauf benötigt daher länger zur Verarbeitung und verbraucht mehr Eingabetoken.
Wenn das Modell auch bei leerem Gespräch langsam antwortet, könnte dies auf hohe Auslastung, insbesondere während Spitzenzeiten, oder auf ein Problem mit der Hardware zurückzuführen sein, die das Modell in unserer Infrastruktur ausführt. Sie können kurz warten oder ein anderes Modell ausprobieren, um zu sehen, ob sich die Antwortzeit verbessert. Bei anhaltenden Problemen wenden Sie sich bitte an den Support.
Prüfen Sie Ihre Internetverbindung. Es ist möglich, dass dies auf eine langsame oder hohe Latenz Ihrer Verbindung zurückzuführen ist, besonders wenn sich die Antwortzeit nicht ändert, wenn Sie das Modell wechseln.
Kann Chat AI meine Bilder verarbeiten?
Ja, solange das Modell dies unterstützt. Wählen Sie einfach ein Modell aus, das Bildeingabe unterstützt (erkennbar an dem Kamera-Symbol), und fügen Sie ein Bild über die Bildschaltfläche im Eingabefeld hinzu. Beachten Sie, dass einige Modelle möglicherweise nicht mehr als ein Bild gleichzeitig verarbeiten können.
Kann Chat AI meine PDF-Dateien verarbeiten?
Ja! Verwenden Sie einfach die Schaltfläche „Text anhängen“ im Eingabefeld und wählen Sie Ihre PDF-Datei aus. Sie sehen die Datei in Ihrer Liste der Anhänge sowie eine Schaltfläche „Verarbeiten“. Beachten Sie, dass PDF-Dateien vor dem Senden einer Nachricht an das Modell verarbeitet werden müssen. Je nach Größe und Inhalt Ihrer PDF-Datei kann dies einige Zeit dauern oder sogar fehlschlagen, wenn die Datei zu groß ist. Sobald die Datei verarbeitet ist, können Sie einfach eine Nachricht an das Modell senden, und ihr Inhalt wird automatisch an Ihre Nachricht angehängt.
OpenAI-Modelle
Kann ich eigene Systemprompts mit den OpenAI (externen) Modellen verwenden?
Nein, leider nicht. Der Systemprompt, den die OpenAI-Modelle verwenden, kann von Endnutzern nicht verändert werden. Verwenden Sie unsere internen Modelle, wenn Sie benutzerdefinierte Systemprompts benötigen.
Warum sind o1 und o1-mini langsamer / warum erhalte ich keine Antworten von o1 und o1-mini?
Die Modelle o1 und o1-mini verfügen über interne Schlussfolgerungsfähigkeiten, was bedeutet, dass sie viel mehr Zeit benötigen, um eine Anfrage zu verarbeiten. Außerdem unterstützt Microsofts API bisher kein Streaming für diese Modelle. Daher muss Chat AI warten, bis das gesamte Antworttextfragment vom Modell generiert wurde, bevor überhaupt Daten empfangen werden können. In einigen Fällen, besonders bei langen Gesprächsverläufen, kann dies so lange dauern, dass die Verbindung abläuft und die Anfrage mit einem „Service Unavailable“-Fehler fehlschlägt.
Sind die OpenAI GPT… (externen) Modelle die echten ChatGPT/GPT-4/… von OpenAI?
Ja, das sind sie. Wir haben einen Vertrag mit Microsoft abgeschlossen, um Zugriff auf die Modelle in deren Azure-Cloud zu erhalten. Da der Dienst Kosten verursacht, ist er nur für Nutzer der Max-Planck-Gesellschaft, Mitglieder der Universität Göttingen (beide GWDG-Anteilseigner) sowie Organisationen und Gruppen mit kostenpflichtigem Vertrag verfügbar. Vielen Dank für Ihr Verständnis.
Warum bezeichnet sich GPT-4 als GPT-3, wenn ich frage, welches Modell es ist?
Chat AI bietet eine große Auswahl an modernen, Open Weight großen Sprachmodellen (LLMs), die auf unserer Plattform mit höchsten Standards zum Datenschutz gehostet werden. Die Daten, die an diese Modelle gesendet werden – einschließlich der Prompts und Nachrichteninhalte – werden an keiner Stelle in unseren Systemen gespeichert. Zusätzlich bietet Chat AI Modelle, die extern gehostet werden, wie Anthropic Claude und OpenAI GPT-5.
Verfügbare Modelle werden regelmäßig aktualisiert, sobald neuere, leistungsfähigere Versionen veröffentlicht werden. Wir wählen Modelle für unsere Dienste basierend auf Nutzerbedarf, Kosten und Leistung in verschiedenen Benchmarks, wie HumanEval, MATH, HellaSwag, MMLU usw. Bestimmte Modelle sind für spezifische Aufgaben und Einstellungen besonders gut geeignet, was unten nach bestem Wissen beschrieben wird.
Die in diesem Abschnitt aufgeführten Modelle werden auf unserer Plattform mit höchsten Standards zum Datenschutz gehostet. Die Daten, die an diese Modelle gesendet werden – einschließlich der Prompts und Nachrichteninhalte – werden an keiner Stelle in unseren Systemen gespeichert.
Apertus 70B Instruct
Apertus ist ein vollständig quelloffenes Sprachmodell, das die Grenzen transparenter und rechtskonformer KI vorantreibt. Es unterstützt über 1.800 Sprachen und ein Kontextfenster von bis zu 65.536 Tokens und verwendet ausschließlich vollständig konforme und offene Trainingsdaten. Das Modell erreicht vergleichbare Leistungen wie geschlossene Modelle, respektiert jedoch die Widerrufs- und Zustimmungserklärungen der Dateneigentümer. Es wurde auf 15 T Token vortrainiert, wobei ein gestaffelter Lehrplan aus Web-, Code- und Mathedaten verwendet wurde.
DeepSeek V4 Flash 0731
DeepSeek V4 Flash 0731 ist ein leistungsstarkes Mixture-of-Experts (MoE)-Modell mit 304B Parametern und einem Kontextfenster von einer Million Tokens. Es übertrifft DeepSeek V4 Pro (Preview) in mehreren Benchmarks, obwohl es weniger aktivierte Parameter hat, und eignet sich für komplexe agente Workflows.
Warnung
DeepSeek-Modelle wurden berichtet, dass sie politisch voreingenommene Antworten liefern und bestimmte Themen, die für die chinesische Regierung sensibel sind, zensieren.
Devstral 2 123B Instruct 2512
Entwickelt von mistralai, ist Devstral 2 ein agentes LLM, das für Software-Engineering- und Codieraufgaben konzipiert ist. Es kann Codebasen erkunden, mit mehreren Dateien arbeiten und Software-Engineering-Agenten unterstützen.
Google Gemma 4 31B Instruct
Gemma 4-Modelle bieten Frontline-Leistung und sind besonders gut geeignet für Schlussfolgerung, agente Workflows, Codierung und multimodales Verständnis.
GLM-4.7
GLM-4.7 ist ein codierungsorientiertes Modell, das gegenüber seinem Vorgänger erhebliche Verbesserungen bei mehrsprachigen agenten Codierungsaufgaben und Terminal-basierten Aufgaben erzielt. Es erreicht starke Leistung auf SWE-bench, SWE-bench Multilingual und Terminal Bench 2.0. GLM-4.7 überzeugt auch bei Werkzeugnutzung, Web-Browsing und mathematischer Schlussfolgerung, mit bemerkenswerten Fortschritten in Benchmarks wie HLE und τ²-Bench.
GLM 5.3 Flash
GLM-5.3-Flash ist das erste natively multimodale Modell der GLM-5-Serie. Es ist ein Hybrid-Architektur-MoE-Modell mit insgesamt 320B Parametern und nur 18B aktiven Parametern. Es kombiniert seltene und lineare Aufmerksamkeit mit Manifold-Constrained Hyper-Connections (mHC), um präzise Langkontextfähigkeiten bei signifikant reduzierten Bereitstellungskosten zu liefern. Es übertrifft GLM-5.2 in Benchmarks und realen Workloads und nähert sich Claude Opus 4.8 bei Codierungs- und agenten Benchmarks an.
Meta Llama 3.1 8B Instruct
Das Standardmodell, das wir empfehlen. Es ist das leichteste mit der schnellsten Leistung und guten Ergebnissen in allen Benchmarks. Es ist ausreichend für allgemeine Gespräche und Unterstützung.
Mistral Medium 3.5 128B
Mistral Medium 3.5 128B ist ein dichtes Modell mit 128B Parametern und einem 256k-Kontextfenster, das Anweisungsfolge, Schlussfolgerung und Codierung in einem einzigen Modell vereint. Daher ersetzt dieses Modell seine Vorgänger in Le Chat und dem Coding-Agent Vibe und liefert bessere Ergebnisse für eine Vielzahl von Aufgaben, einschließlich Anweisungen, Schlussfolgerung und Codierung, im Vergleich zu früheren Modellen.
OpenAI GPT OSS 120B
Im August 2025 veröffentlichte OpenAI die GPT-OSS-Modellreihe, bestehend aus zwei Open Weight LLMs, die für schnellere Inferenz mit state-of-the-art-Leistung in vielen Bereichen optimiert sind, einschließlich Schlussfolgerung und Werkzeugnutzung. Laut OpenAI erreicht das GPT-OSS-120B-Modell nahezu Parität mit OpenAI o4-mini auf Kern-Schlussfolgerungsbenchmarks.
Qwen 3 30B A3B Instruct 2507
Dieses MoE-Modell verfügt über 30,5B insgesamt und 3,3B aktivierte Parameter für effiziente Inferenz. Es liefert erhebliche Verbesserungen bei Anweisungsfolge, logischer Schlussfolgerung, Textverständnis, Mathematik, Wissenschaft, Codierung und Werkzeugnutzung, mit besserer Ausrichtung bei subjektiven und offenen Aufgaben. Das Modell unterstützt eine native Kontextlänge von 256K und arbeitet im Nicht-Überlegungsmodus, wodurch starke Leistung in Wissens-, Schlussfolgerungs-, Codierungs- und mehrsprachigen Benchmarks erzielt wird.
Qwen 3 Coder Next
Qwen 3 Coder Next verfügt über 80 Milliarden insgesamt und 3 Milliarden aktivierte Parameter, was es kosteneffizient macht, besonders für Agenten-Deployment. Mit einer Kontextlänge von 256K und Anpassungsfähigkeit an verschiedene Vorlagen kann es auch in CLI- und IDE-Plattformen integriert werden.
Qwen 3 Omni 30B A3B Instruct
Qwen3 Omni ist ein natively mehrsprachiges Omni-Modell, das Text, Bilder, Audio und Video verarbeitet. Es erreicht Spitzenleistung in vielen Audio-/Video-Benchmarks mit ASR, Audio-Verständnis und Sprachkonversationen, die mit Gemini 2.5 Pro vergleichbar sind. Das Modell verfügt über eine neuartige MoE-basierte Thinker–Talker-Architektur mit AuT-Prätraining, unterstützt 119 Textsprachen, 19 Sprach-Eingabesprachen und ermöglicht latenzarme Interaktion mit flexibler Steuerung über Systemprompts.
Qwen 3.5 122B A10B
Qwen 3.5 122B A10B ist ein leistungsstarkes Sprachmodell, das von Alibaba Cloud entwickelt wurde. Mit 122 Milliarden Parametern liefert es starke Leistung in Schlussfolgerung, Codierung und allgemeinen Aufgaben. Das Modell unterstützt Vision-Fähigkeiten für multimodale Anwendungen.
Qwen 3.5 397B A17B
Qwen 3.5 397B A17B ist ein MoE-Modell mit 397 Milliarden insgesamt und 17 Milliarden aktiven Parametern. Es stellt eines der leistungsstärksten Open Weight Modelle dar, das außergewöhnliche Leistung in Schlussfolgerung, Codierung, Mathematik und allgemeinen Aufgaben erzielt. Das Modell unterstützt Vision-Fähigkeiten und bietet Spitzenleistung unter den Open Weight Modellen.
Qwen 3.6 35B A3B
Qwen 3.6 35B A3B ist ein MoE-Modell mit 35 Milliarden insgesamt und 3 Milliarden aktiven Parametern für effiziente Inferenz. Es eignet sich für reale Aufgaben, einschließlich Codierung und agente Workflows.
Qwen 3.8 27B
Qwen 3.8 liefert im Vergleich zu seinen Vorgängern erhebliche Fortschritte in Forschung, Codierung und großen agenten Aufgaben. Qwen 3.8 ist ein natives Vision-Sprach-Modell, das Bilder und Videos versteht, mit flexibler Denksteuerung und dafür konzipiert, komplexe Aufgaben zuverlässiger zu erledigen.
Externe Modelle, gehostet von externen Anbietern
Warnung
Diese OpenAI- und Anthropic-Modelle werden von externen Anbietern gehostet, und Chat AI leitet lediglich den Inhalt Ihrer Nachrichten an deren Server weiter. Wir empfehlen daher die Open Weight Modelle, die von uns gehostet werden, um die höchste Sicherheit und Datenschutz zu gewährleisten.
Anthropic Claude Sonnet 5
Claude Sonnet 5 ist als agentes Modell entwickelt. Es bietet erheblich verbesserte Kosten-Effizienz bei mittlerem Aufwand; seine Leistung bei höherem Aufwand kann Opus 4.8 auf einigen Aufgaben erreichen.
Anthropic Claude Sonnet 4.6
Claude Sonnet 4.6 bietet ein hervorragendes Gleichgewicht zwischen Leistung und Geschwindigkeit. Es ist für Produktionsworkloads optimiert und liefert schnelle, zuverlässige Antworten für Codierung, Analyse und Gespräche.
OpenAI GPT-5, 5.1, 5.2, 5.3, 5.4, 5.5 und 5.6-Serie
Die GPT-5-Serie-Modelle von OpenAI erreichen Spitzenleistung in verschiedenen Benchmarks. Die Serie besteht aus folgenden Modellen mit ihren vorgesehenen Einsatzgebieten:
OpenAI GPT-5.6 Sol: Das Frontline-Modell der GPT-5.6-Familie, entwickelt für komplexe professionelle Arbeit.
OpenAI GPT-5.6 Terra: Das GPT-5.6-Modell, das Intelligenz und Kosten ausbalanciert.
OpenAI GPT-5.6 Luna: Das GPT-5.6-Modell optimiert für kostenempfindliche Workloads.
OpenAI GPT-5.5: Für die komplexeste professionelle Arbeit konzipiert, einschließlich Codierung, werkzeugintensiver Agenten, fundierter Assistenten und Kunden-Workflows, bei denen Ausführungsgüte und Antwortqualität wichtig sind.
OpenAI GPT-5.4: Für professionelle Wissensarbeit, einschließlich Dokument- und Tabellenarbeiten, Codierung, Datenanalyse, agente Workflows und Software-Automatisierung.
OpenAI GPT-5.4 Mini: Eine leichtgewichtige Variante von GPT-5.4 für kostenempfindliche Anwendungen.
OpenAI GPT-5.4 Nano: Eine stark optimierte Variante von GPT-5.4. Ideal für Anwendungen mit niedriger Latenz.
OpenAI GPT-5/5.1/5.2: Für logikintensive und mehrstufige Aufgaben konzipiert.
OpenAI GPT-5 Mini: Eine leichtgewichtige Variante von GPT-5 für kostenempfindliche Anwendungen.
OpenAI GPT-5 Nano: Eine stark optimierte Variante von GPT-5.
OpenAI GPT-4.1
Die GPT-4.1-Klasse-Modelle von OpenAI verbessern die älteren GPT-4-Serien. Diese Modelle übertrifft auch GPT-4o und GPT-4o Mini, besonders in Codierung und Anweisungsfolge. Sie verfügen über ein großes Kontextfenster von 1M Tokens, verbesserte Langkontext-Komprehension und ein aktualisiertes Wissens-Cutoff von Juni 2024.
OpenAI GPT-4.1 Mini
Dies wurde als kosteneffizientere und schnellere Alternative zu GPT-4.1 entwickelt.
OpenAI o1 und o1 Mini
Die o1-Klasse-Modelle von OpenAI wurden entwickelt, um komplexe Schlussfolgerungsaufgaben zu erfüllen. Diese Modelle wurden mittlerweile durch die o3-Serie ersetzt und werden daher nicht mehr empfohlen.
OpenAI o3
Im April 2025 veröffentlicht, wurden die o3-Klasse-Modelle von OpenAI entwickelt, um komplexe Schlussfolgerungsaufgaben in den Bereichen Codierung, Mathematik, Wissenschaft, visuelle Wahrnehmung und mehr zu erfüllen. Diese Modelle verfügen über einen iterativen Gedankengang und benötigen daher Zeit, um intern zu verarbeiten, bevor sie auf den Benutzer reagieren. Der Gedankengang für o3-Modelle wird dem Benutzer nicht angezeigt.
OpenAI o3 Mini
Dies wurde als kosteneffizientere und schnellere Alternative zu o3 entwickelt.
Features
Dieser Abschnitt sammelt alle Funktionen, die Chat AI über die grundlegende Textgenerierung hinaus erweitern und anpassen. Mit diesen Funktionen können Sie die Persönlichkeit des Assistenten gestalten, externe Wissensquellen integrieren und das Modellverhalten für unterschiedliche Anwendungsfälle konfigurieren. Die Versionsgeschichte wird hier ebenfalls verfolgt, um nachzuvollziehen, welche Funktionen in welcher Version hinzugefügt oder aktualisiert wurden.
Verfügbare Funktionen
Speicher
Speicher sind Informationen, die der Chatbot aus dem Gespräch lernt, um sich personalisierter zu verhalten.
Personas Definieren Sie Rollen und Tonarten für den Assistenten (z. B. Vorstellungsgesprächsinterviewer, Tutor, informeller Stil). Mit Personas können Sie das Verhalten des Modells schnell wechseln.
Tools Chat AI-Modelle erhalten Zugriff auf verschiedene Tools, um nicht-textbasierte Aufgaben zu erfüllen oder die Antworten zu verbessern:
Web-Suche
Bildgenerierung
Bildbearbeitung
Text-zu-Sprache (TTS)
MCP-Unterstützung Sie können benutzerdefinierte öffentliche Model Context Protocol (MCP)-Server zu Chat AI hinzufügen.
Unterabschnitte von Features
Personas
Chat AI unterstützt das Laden vorgefertigter Personas aus Konfigurationsdateien im JSON-Format. Jede JSON-Datei enthält den Systemprompt, Einstellungen und Gespräche, sodass Sie eine Persona einfach in Chat AI laden können. Obwohl diese Dateien über die Import-Funktion geladen werden können, unterstützt Chat AI auch das direkte Importieren öffentlicher JSON-Dateien aus dem Web, indem Sie die URL angeben.
Beispiel-Personas
Wenn Sie lediglich einen schnellen Link zum Laden einer bestimmten Persona benötigen, ist dies Ihr Kapitel. Hier sind einige der interessanten und nützlichen Personas, die die KI-Community entwickelt hat:
Schauen Sie sich unser GitHub-Repository für Chat AI Personas an und helfen Sie uns, vielseitige und nützliche Personas zu erstellen. Die besten werden auf dieser Seite vorgestellt.
Sie können einen Link zu Chat AI mit der gewünschten Persona aus den öffentlich verfügbaren vorgefertigten Personas in Chat AI erstellen. Dazu fügen Sie einfach die URL der JSON-Datei als import-Parameter in die URL ein:
Ersetzen Sie <json_url> durch die URL der JSON-Datei.
Benutzerdefinierte Personas
Sie können auch Ihre eigenen benutzerdefinierten Personas erstellen, die direkt in der Chat AI-Oberfläche geladen werden können. Diese müssen als JSON-Datei gespeichert werden.
{
"title": "Beispiel-Persona",
"model-name": "Qwen 3 30B A3B Instruct 2507", #DerModellname,derinderBenutzeroberflächeangezeigtwird"model": "qwen3-30b-a3b-instruct-2507", #Modell-IDfürdieAPI"temperature": 0.2, #BenutzerdefinierteTemperatureinstellung"top_p": 0.2, #Benutzerdefiniertetop_p-Einstellung#HierkönnenSieIhrenSystempromptanpassen."role": gibtdieRollean, hier"system".AndereOptionensind"user", "assistant"und"info"."system"sollteimmerzuerstkommenundoptionalvoneiner"info"-Nachrichtgefolgtwerden."content"istderBereich, indemSieIhrenbenutzerdefiniertenPrompteingeben."messages": [
{
"role": "system",
"content": "<Geben Sie hier Ihren benutzerdefinierten Prompt ein>" },
{
"role": "info",
"content": "<(Optional) Geben Sie eine Info-Nachricht ein, die oben im Gespräch angezeigt wird>" }
]
}
Die neuesten Modelle sind hier aufgelistet. Die API-Modellnamen sind hier aufgelistet.
Info
Beachten Sie, dass durch Klicken auf diese Links die Konfiguration der Persona – also Systemprompt, Modell und andere Einstellungen – geladen wird.
Model Context Protocol (MCP)
Chat AI unterstützt die Hinzufügung öffentlicher Model Context Protocol (MCP)-Server als Werkzeuganbieter zu Ihrer Chat AI-Erfahrung.
Dieses Tool erfordert eine Modell-Kontext-Protokoll-Server-URL, die eine einfache HTTPS-Adresse sein sollte. Grundsätzlich ermöglicht dies, dass Chat AI mit zusätzlichen Werkzeugen, Datenquellen oder weiteren Verarbeitungsfunktionen interagiert, die über die in Chat AI integrierten Funktionen hinausgehen. Alle Daten aus Ihrem Chat AI-Kontext können an den von Ihnen eingegebenen Server gesendet werden.
Die Interaktion mit aktuellen Informationen ist besonders nützlich für die Verarbeitung, da sie präzisere Ergebnisse liefert als Web-Suchen und weniger statisch ist als RAG-Systeme wie Arcana. Darüber hinaus können zusätzliche Werkzeuge auf diese Weise genutzt werden, beispielsweise:
MCP-Server: https://mcp.deepwiki.com/mcp
Prompt: Erklären Sie, worum es in diesem GitHub-Repository: https://github.com/gwdg/chat-ai geht
Die Verwendung von MCP-Servern, die auf Ihrem eigenen Computer laufen, z. B. http://localhost, wird nicht unterstützt.
Versionen
Diese Seite listet alle Chat AI-Veröffentlichungen auf, beginnend mit der neuesten. Jeder Eintrag beschreibt neue Funktionen, Verbesserungen und Fehlerbehebungen mit kurzen Erklärungen, wie sie genutzt werden können.
v0.9.0 — September 2025
Neue Funktionen
Neu gestaltete Benutzeroberfläche Eine frische Oberfläche mit ein- und ausklappbaren Seitenleisten links und rechts für maximale Gesprächsfläche. Optimiert für die reibungslose Handhabung beliebig langer Gespräche und Anhänge.
Neuer Modellauswahlmenü Jetzt zentral oben platziert. Zeigt deutlich mehr Modelle als zuvor an. Standardmodell wurde auf Qwen 3 30B A3B Instruct 2507 umgestellt – ausgewählt wegen Geschwindigkeit, Werkzeugkompatibilität und starker Leistung.
Integration von GWDG-Werkzeugen Aktivieren Sie GWDG-Werkzeuge im Einstellungsfeld, um neue Funktionen freizuschalten:
Web-Suche mit Google
Bildgenerierung und -bearbeitung
Sprachgenerierung (z. B. Text-zu-Sprache)
Arcana/RAG mit beliebigen Modellen
Benutzerdefinierte MCP-Server: Geben Sie die URL eines beliebigen MCP-Servers an, um dessen Werkzeuge zusätzlich zu den GWDG-Werkzeugen nutzen zu können. Chat AI zeigt Echtzeit-Updates an, sobald Werkzeuge verwendet werden. ⚠️ Werkzeuge sind eine neue Funktion und funktionieren noch nicht mit allen Modellen. Empfohlen mit Qwen 3 30B A3B Instruct 2507.
Datenexport Aus Ihrem Profil → Einstellungen können Sie nun alle Ihre Daten sichern und als eine einzige JSON-Datei speichern.
Verbesserungen
Bessere Code-Sanitisierung, um Cross-Site-Styling zu verhindern.
Flüssigere Auto-Scrolling-Funktion bei langen Gesprächen.
Neues Navigationsmenü zu anderen KI-Diensten.
Einheitliche Anhänge-Schaltfläche für Konsistenz.
Zahlreiche kleinere UI/UX-Verbesserungen und Optimierungen.
v0.8.1 — 3. Juli 2025
Neue Funktionen
Speicher Chat AI kann nun relevante Details über alle Gespräche hinweg speichern. ⚠️ Der Speicher wird ausschließlich lokal im Browser gespeichert (nicht auf Servern). Dies ermöglicht natürlichere, kontinuierliche Gespräche, aber das Löschen des Browser-Speichers setzt ihn zurück.
Modell-Suche im Auswahlmenü Finden Sie Modelle schnell, indem Sie deren Namen eingeben.
Konfigurierbarer globaler Timeout Verhindert endlose Antwort-Schleifen, indem Sie eine maximale Antwortzeit festlegen.
LaTeX-Rendering-Option Neben Markdown und Klartext können Antworten nun auch korrekt in LaTeX gerendert werden.
Standard-Einstellungen in Konfigurationsdatei Definieren Sie Start-Einstellungen (z. B. Temperatur, Thema) in der Konfigurationsdatei.
Fehlerbehebungen
Behebung eines Rendern-Fehlers in der letzten Textzeile vor Referenzen.
Generierte Arcana-Links öffnen nun in einem neuen Gespräch.
v0.8.0 — 4. Juni 2025
Neue Funktionen
Wählbare Personas in der Oberfläche Laden Sie Personas direkt in der Oberfläche aus chat-ai-personas herunter. Mit Personas können Sie die Rolle des Assistenten schnell ändern.
Info-Nachrichten in importierten Gesprächen/Personas werden nun unterstützt.
Einfacher UI-Modus Vereinfachte Einrichtung, kompatibel mit SAIA-API-Schlüssel.
Verbesserungen
Bessere Import-/Export-Funktion für Gespräche.
v0.7.4 — 19. Mai 2025
Fehlerbehebungen
Behebung von Synchronisationsproblemen bei mehreren geöffneten Tabs.
Aktualisierte URL-Verarbeitung für Arcana.
Verbesserungen
Referenzen können nun als Links gerendert werden.
v0.7.3 — 24. April 2025
Neue Funktionen
Seitenleisten-Einstellungsfeld ersetzt das alte Einstellungsfenster.
Anhänge als Kästchen mit Vorschaubildern in den Eingabefeldern.
Erweiterte Anhang-Unterstützung für mehr Dateitypen.
Versionsnummer wird nun im Footer angezeigt.
Änderungen
Das Feld key wurde aus den Arcana-Einstellungen entfernt.
v0.7.2 — 15. April 2025
Neue Funktionen
Verbesserte Anhang-Anzeige mit Unterstützung für erneutes Senden, Bearbeiten und Rückgängig.
Unterstützung für weitere Dateitypen hinzugefügt.
Aktualisiertes Referenzformat, angepasst an RAG-Anforderungen.
Wahl der Antwort-Rendering-Mode (Markdown, LaTeX, Klartext).
Herunterladen von Antworten als PDF.
Fehlerbehebungen
Behebung von Bugs bei der LaTeX-, Code- und Markdown-Rendern.
Behebung des UI-Scrollbar-Problems.
Verbesserte Stabilität bei mehreren Fenstern/Tabs.
v0.7.1 — 26. Februar 2025
Neue Funktionen
Videoeingabe-Unterstützung.
PDF-Verarbeitung über Docling.
Vorschaubilder für Bilder und Text-Anhänge.
Bearbeitungsschaltfläche für Antworten.
Verbesserungen
Aktualisierte Logo-Datei.
Verbesserte Markdown/LaTeX-Rendern.
Flüssigere Antwort-Anzeige.
Bessere Unterstützung für mehrere Gespräche.
v0.7.0 — 26. Februar 2025
Neue Funktionen
Arcana unterstützt.
Unterstützung für mehrere Gespräche.
Profil-Fenster hinzugefügt.
Skalierung auf Null-Modelle (scale-to-zero) unterstützt.
Modellstatus-Popups.
Kopier-Schaltfläche für Code in Antworten.
Fehlerbehebungen
Pfad des Wiederholen-Buttons korrigiert.
LaTeX- und Markdown-Handhabung verbessert.
Kleinere UI-Verbesserungen.
v0.6.3 — 26. Februar 2025
Neue Funktionen
Kein Token-Limit – unbegrenzte Tokens.
Bildhochladen – über Zwischenablage oder Drag-and-Drop.
CSV-Hochladen – direkt unterstützt.
Temporäre Modellausführung – führt inaktive Modelle kurzzeitig aus.
Modellstatus-Anzeigen (aktiv, lädt, etc.).
v0.6.2 — 26. Februar 2025
Aktualisierung des Modell-API-Endpunkts auf /models.
v0.6.1 — 26. Februar 2025
Neue Funktionen
Teilen von Modell und Einstellungen über base64-kodierte URL.
Import externer Einstellungen (z. B. Personas).
UI-Updates
Sichtbarere Scrollbar im Modellauswahlmenü.
Korrektur des Headers auf Tablets.
Sauberere Gestaltung im Einstellungsbereich.
Werkzeuge
Übersicht
Dieses Dokument beschreibt einen benutzerdefinierten, multimodalen Werkzeug-Server, der auf der GWDG-Infrastruktur gehostet wird. Er bietet zentrale KI-Funktionen: Bildgenerierung, Bildbearbeitung, Text-zu-Sprache (TTS) und Web-Suche, die direkt über die Chat AI-Oberfläche zugänglich sind. Diese Werkzeuge sind darauf ausgelegt, die Benutzerinteraktion zu bereichern, indem sie die dynamische Erstellung und Transformation von Medien innerhalb von Gesprächsworkflows ermöglichen.
Voraussetzungen
Um den Werkzeug-Server nutzen zu können, müssen folgende Bedingungen erfüllt sein:
Standard-LLM: Das System sollte idealerweise Qwen3-30B-A3B-Instruct-2507 als aktives Sprachmodell verwenden, um optimale Leistung zu erzielen.
Werkzeugaktivierung: Die Werkzeuge müssen in der Chat AI-Oberfläche aktiviert werden, indem das Feld „Werkzeuge aktivieren“ im Einstellungsfeld angekreuzt wird.
Die Web-Suche ist separat aktivierbar, da sie dazu führen kann, dass Daten an externe Diensteanbieter gesendet werden. Um sie zu aktivieren, aktivieren Sie die Checkboxen „GWDG-Werkzeuge“ und „Web-Suche“ im Seitenleistenbereich, wie im folgenden Screenshot gezeigt.
Sobald aktiviert, kann der Agent Werkzeuge basierend auf dem Benutzerintention entdecken und aufrufen.
Verfügbare Werkzeuge
Werkzeugname
Beschreibung
generate_image
Generiert Bilder aus Textprompts mit dem FLUX.1-schnell-Modell
edit_image
Führt Bearbeitungen an bestehenden Bildern durch (z. B. Inpainting, Maskierung, Stilübertragung) mit Qwen-Image-Edit-2511
Nutzt einen Web-Suchdienst, z. B. Google, um zusätzliche Informationen zu einer von der KI bereitgestellten Anfrage bereitzustellen
Web-Suche
Das Web-Suchwerkzeug ermöglicht es der KI, aktuelle Informationen aus dem Internet abzurufen, um ihre Antworten zu verbessern. Wenn aktiviert, kann die KI Suchanfragen basierend auf Ihrer Frage und dem gesamten Gesprächsverlauf generieren, diese an eine Suchmaschine (z. B. Google) senden und die abgerufenen Ergebnisse nutzen, um genauere und aktuellere Antworten zu liefern. Dies ist besonders nützlich für Themen, bei denen aktuelle oder sich schnell ändernde Informationen wichtig sind. Die Web-Suche ist für extern gehostete Modelle nicht verfügbar. Sie müssen das Modell gegebenenfalls explizit auffordern, die Suche im Internet durchzuführen, damit ein solcher Werkzeugaufruf erfolgt.
Nutzungsszenario
Sobald die Werkzeuge aktiviert sind, folgt der Agent einem strukturierten Ablauf, um die Benutzereingabe zu interpretieren und das passende Werkzeug aufzurufen:
Werkzeug-Erkennung Der Agent listet verfügbare Werkzeuge und deren Fähigkeiten auf. Beispiel: „Welche Werkzeuge kann ich nutzen?“ → Agent antwortet mit generate_image, edit_image, speak_text.
Werkzeug-Auswahl Basierend auf dem Benutzerintention wählt der Agent das passende Werkzeug aus. Beispiel: „Erstelle ein Bild eines leuchtenden Qualle im Weltraum“ → Agent wählt generate_image.
Aufruf Der Agent sendet eine strukturierte Eingabedatenmenge an den Werkzeug-Server. Beispiel:
{
"prompt": "eine leuchtende Qualle, die im tiefen Weltraum schwebt",
"size": "1024x1024"}
Antwortverarbeitung Der Agent erhält die Ausgabe und zeigt sie in der Benutzeroberfläche an oder speichert sie für weitere Verwendung.
Weitere Beispiele
„Ändere dieses Bild in Van-Gogh-Stil“ → edit_image → führt Stilübertragung durch
„Erstelle Audio aus diesem Text: ‚Willkommen bei GWDG. Ihre Forschung zählt.‘“ → speak_text → spielt Audio ab
CoCo AI (Code-Assistent)
CoCo AI ist unser KI-gestützter Code-Service, der Chat AI nutzt und über Ihren SAIA-API-Schlüssel zugänglich ist. Er bringt große Sprachmodelle direkt in Ihre Entwicklungsumgebung, um Codevorschläge, chatbasierte Unterstützung und autonome mehrstufige Codieraufgaben zu ermöglichen.
Erste Schritte
Bevor Sie ein Werkzeug konfigurieren, benötigen Sie:
Einen unterstützten Editor oder Terminal. Siehe die Abschnitte unten.
Ein Modell zum Einsatz. Blättern Sie durch die verfügbaren Modelle. Wir empfehlen, mit qwen3-coder-30b-a3b-instruct oder devstral-2-123b-instruct-2512 für Codieraufgaben zu beginnen.
Info
Nur Modelle, die auf der HPC-Infrastruktur von GWDG gehostet werden (interne Modelle), sind über die API verfügbar. Externe Modelle (z. B. GPT-4, Claude) sind nur über die Chat AI-Web-Oberfläche zugänglich und können nicht mit CoCo AI verwendet werden.
Code-Vervollständigung vs. Agenter Coding
CoCo AI unterstützt zwei Kategorien von KI-gestützter Entwicklung:
Inline-Vorschläge beim Tippen sowie Chat zur Erklärung oder Bearbeitung von Code
Autonome mehrstufige Aufgaben: Lesen Ihres Codebasen, Bearbeiten von Dateien, Ausführen von Befehlen
Grad der Autonomie
Sie steuern; das Modell schlägt vor
Das Modell steuert; Sie überprüfen und genehmigen
Ideal für
Schnelleres Schreiben von Code, Verständnis unbekannter Code, schnelle Änderungen
Refactoring über mehrere Dateien, Generieren von Tests, Aufbau von Projekten
Zweifeln Sie, welchen Ansatz Sie beginnen sollen? Die Code-Vervollständigung ist der einfachere Einstiegspunkt. Wenn Sie sich dabei finden, mehrstufige Pläne im Chat zu beschreiben, überlegen Sie, auf ein agentes Werkzeug umzusteigen.
Viele Code-Editoren bieten heute LLM-Integration an. Code-Vervollständigungswerkzeuge liefern Inline-Vorschläge, während Sie tippen, und helfen Ihnen, Code schneller zu schreiben, indem sie die nächste Zeile vorhersagen. Sie unterstützen durch die Vervollständigung von Funktions-Signaturen und die Vorschläge ganzer Codeblöcke basierend auf dem Kontext. Sie bieten außerdem eine Chat-Oberfläche zum Erklären, Generieren und Bearbeiten von Code direkt in Ihrem Editor.
Info
Um die internen Modelle, die auf unserer Plattform gehostet werden, mit den unten genannten Werkzeugen zu nutzen, benötigen Sie einen SAIA-API-Schlüssel. Falls Sie noch keinen besitzen, verweisen Sie auf SAIA-API-Schlüssel, um einen zu beantragen. Externe Modelle sind nicht über die API verfügbar.
Visual Studio Code (oder Jetbrains) ist als IDE (Integrated Development Environment) erforderlich, um CoCo AI zu nutzen.
Installieren Sie die Continue-Erweiterung aus dem VS Code-Erweiterungsmarkt. Continue ist eine Open-Source-KI-Code-Assistent-Plugin, das Code-Snippets oder sogar gesamte Repositories mit einem ausgewählten Modell abfragen kann. Nach der Installation bietet Continue eine kurze und leicht verständliche Einführung in seine Funktionen.
Um diesen Dienst nutzen zu können, müssen Sie einige Einrichtungsschritte befolgen. Nach der Installation der Continue-Erweiterung klicken Sie auf das Symbol in der linken Seitenleiste von VS Code. Dadurch öffnet sich ein neues Fenster. In der rechten oberen Ecke des Chat-Fensters sehen Sie eine Dropdown-Liste mit „Lokale Konfiguration“. Klicken Sie darauf, und Sie sollten eine Liste von Konfigurationsdateien im YAML-Format sehen (standardmäßig gibt es nur eine Datei namens „Lokale Konfiguration“). Öffnen Sie die Datei config.yaml und fügen Sie die folgende Konfiguration ein:
Dann laden Sie das Fenster neu. Danach sollten Sie eine Liste der verfügbaren Modelle in der unteren Leiste des Chat-Fensters sehen. Durch Auswahl eines Modells können Sie den Code-Vervollständigungsdienst nutzen.
Bitte beachten Sie bei der Bearbeitung der config.yaml-Datei folgende Punkte:
Der „provider“ muss, unabhängig vom tatsächlichen Anbieter, ein von Continue unterstützter Anbieter sein (z. B. OpenAI oder Ollama).
Der „model“-Name muss vollständig in Kleinbuchstaben geschrieben werden.
Der „apiKey“ muss ohne Klammern oder Anführungszeichen geschrieben werden.
Die „roles“ geben Continue an, wofür jedes Modell verwendet werden kann (Chat, Vervollständigung, Bearbeitung usw.). Mindestens ein Modell muss die Vervollständigungsfunktion (autocomplete) unterstützen, wenn Sie später die Tab-Vervollständigung nutzen möchten.
Weitere detaillierte Informationen zur Konfiguration im Continue AI-Code-Agent finden Sie in der offiziellen Dokumentation: docs.continue.dev
Anmerkung
Beachten Sie, dass nur eine Teilmenge aller verfügbaren Modelle oben aufgeführt ist. Darüber hinaus sind die OpenAI GPT 3.5 und 4-Modelle nicht für die API-Nutzung verfügbar und daher nicht für CoCo AI nutzbar. Andere verfügbare Modelle können wie oben beschrieben hinzugefügt werden.
Ersetzen Sie <api_key> durch Ihren eigenen API-Schlüssel (siehe hier für die Anfrage des API-Schlüssels). Wir empfehlen feinabgestimmte Code-Modell für Code-Vervollständigungsaufgaben: devstral-2-123b-instruct-2512, glm-4.7, qwen3-coder-30b-a3b-instruct. Eine vollständige Liste der verfügbaren Modelle finden Sie hier: Verfügbare Modelle / API-Namen.
Um auf Ihre Daten zuzugreifen, die auf dem Cluster gespeichert sind, von VSCode aus, siehe unsere Konfiguration von SSH. Dies ist nicht erforderlich für lokale Code-Arbeit.
Grundlegende Konfiguration
Zwei wichtige Konzepte, die bei den Vervollständigungsoptionen zu verstehen sind, sind temperature und top_P Sampling.
temperature ist ein Schieberegler von 0 bis 2, der die Kreativität anpasst, wobei Werte nahe 0 vorhersehbarer und Werte nahe 2 kreativer sind. Dies geschieht, indem die Wahrscheinlichkeiten für das nächste Token (Baustein der Antwort) erweitert oder abgeflacht werden.
top_p ist ein Schieberegler von 0 bis 1, der die Gesamtmenge der Wahrscheinlichkeiten anpasst, die für das nächste Token berücksichtigt werden. Ein top_p von 0,1 bedeutet, dass nur die oberen 10 % der kumulativen Wahrscheinlichkeiten berücksichtigt werden. Die Variation von top_p hat einen ähnlichen Effekt auf Vorhersehbarkeit und Kreativität wie temperature, wobei größere Werte als kreativer gelten.
Für vorhersehbare Ergebnisse, z. B. bei Programmieraufgaben, sind niedrige Werte für beide Parameter erforderlich, während kreative Ergebnisse, z. B. bei Brainstorming, hohe Werte erfordern. Weitere Empfehlungen finden Sie in der Tabelle im Abschnitt aktuelle Modelle.
Unser Vorschlag ist, die oben genannten Vervollständigungsoptionen für jedes Modell gemäß der Tabelle in Chat AI festzulegen und zwischen den Modellen basierend auf Ihren Bedürfnissen zu wechseln. Sie können das Modell auch mehrfach mit unterschiedlichen Vervollständigungsoptionen und unterschiedlichen Namen speichern, wie im folgenden Beispiel:
Eine weitere Vervollständigungsoption, die besonders für lange Antworten berücksichtigt werden sollte, ist max_tokens. Es ist ein Wert, der kleiner als das Kontextfenster ist und angibt, wie viele Tokens pro Prompt berücksichtigt werden können, plus generiert für die Antwort auf diesen Prompt. Jedes Modell hat eine unterschiedliche Kontextfenstergröße (siehe Tabelle in aktuelle Modelle für Größen). Ebenso hat jedes Modell eine Standardlänge für max_tokens. Diese Länge ist optimal für die meisten Aufgaben, kann aber für längere Aufgaben geändert werden, z. B. „Nennen Sie die Hauptstädte jedes Landes der Welt und einen interessanten Aspekt darüber.“
Das Kontextfenster möchte Systeminformationen, Chatverlauf, das Trainingsgedächtnis, den letzten Prompt und die vorherigen Tokens aus der aktuellen Antwort betrachten. Daher begrenzt max_tokens die Antwortgenerierung, um zu verhindern, dass die Qualität der Antwort durch die Zuweisung von Kontext an andere Quellen beeinträchtigt wird. Daher wird empfohlen, eine große Aufgabe in kleinere Aufgaben aufzuteilen, um die Anforderung einer kleineren Antwortgenerierung zu erfüllen. Es könnte jedoch schwierig oder unmöglich sein, dies zu tun, in welchem Fall max_tokens erhöht werden sollte (mit dem Risiko einer Verschlechterung). Siehe API-Nutzungsfälle für ein Beispiel, wie max_tokens geändert werden kann.
Die drei Hauptfähigkeiten des Continue-Plugins sind die Analyse von Code, die Generierung von Code und die Fehlerbehebung. Eine neue nützliche Fähigkeit ist ein Tab-Vervollständigungs-Tastaturkürzel, das sich noch in der Beta-Phase befindet.
Code analysieren
Für alle unten genannten Befehle kann
Strg
durch
Cmd
für Mac-Benutzer ersetzt werden.
Markieren Sie einen Code-Ausschnitt und drücken Sie die Tastenkombination
Strg
+
L
. Dies öffnet die Continue-Seitenleiste mit dem Ausschnitt als Kontext für Ihre gewünschte Frage. Aus dieser Seitenleiste können Sie auch auf jede Datei in Ihrem Repository zugreifen sowie verschiedene Arten von Kontext bereitstellen, wie z. B. das gesamte Paket oder die Sprachdokumentation, Probleme, Git, Terminal oder sogar Ihre gesamte Codebasis in Ihrem gewählten Repository. Dies kann entweder durch Drücken von @ oder durch Klicken auf die Schaltfläche + Kontext hinzufügen erfolgen. Typische Funktionen sind verfügbar, wie z. B. das Öffnen mehrerer Sitzungen, das Abrufen früherer Sitzungen und das Wechseln in den Vollbildmodus. Modelle können leicht gewechselt werden, z. B. auf ein Modell mit kreativer Konfiguration, an das Prompts ohne Kontext gesendet werden können, genau wie die Web-Oberfläche von Chat AI funktioniert.
Code generieren
Markieren Sie einen Code-Ausschnitt und drücken Sie die Tastenkombination
Strg
+
I
. Dies öffnet eine Dropdown-Leiste, in der Ihr gewünschter Prompt zu diesem Code eingegeben werden kann. Nach der Eingabe wird weiterer Code basierend auf dem Code-Ausschnitt generiert oder der Code-Ausschnitt selbst bearbeitet. Diese Änderungen können von der Korrektur fehlerhaften Codes über die Generierung von Inline-Dokumentation bis hin zum Umbenennen von Funktionen reichen. Der generierte Code und möglicherweise gelöschter Code werden in einem Format angezeigt, das an einen Git-Merge-Konflikt erinnert, mit den Optionen Akzeptieren und Ablehnen. Beachten Sie, dass es innerhalb von VSCode keine klare Anzeige gibt, ob Cluster-Ressourcen für die Code-Generierung verfügbar sind oder ob die Code-Generierung aus anderen Gründen nicht durchgeführt wird. Wir empfehlen, kurz zu warten, bevor Sie es erneut versuchen.
Vor der Code-Generierung mit Prompt
Nach der Code-Generierung
Beachten Sie aus dem Beispiel, dass das Code-Vervollständigungsmodell mehr kann, als nur funktionale Code zu generieren. Es verfügt auch über alle Vorteile und Kenntnisse, die von einem LLM erwartet werden: Semantik, Gruppierung und sprachliche Schlussfolgerung. Es gibt jedoch weiterhin Einschränkungen dieser Kenntnisse basierend auf dem Datum, bis zu dem das Modell trainiert wurde.
Fehler beheben
Wenn Fehler in Ihrem VS Code in den Bereichen Probleme, Ausgabe oder Terminal aufgetreten sind, drücken Sie
Strg
+
Umschalt
+
R
, um die Fehler in die Continue-Seitenleiste zu bringen und eine Lösung dafür anzufordern. Die Ergebnisse erklären die Fehler ausführlich und bieten möglicherweise Lösungscode für den identifizierten fehlerhaften Code. Dieselbe Aktion kann auch manuell über die Continue-Seitenleiste durchgeführt werden, indem Sie den Fehler als Kontext bereitstellen und ihn beheben lassen.
Tab-Vervollständigung
Continue analysiert wiederholt den anderen Code in Ihrer aktuellen Datei, unabhängig von der Programmiersprache, und liefert Vorschläge für Code, der ausgefüllt werden soll. Um diese Funktion zu aktivieren, stellen Sie sicher, dass mindestens ein Modell in der config.yaml die Rolle autocomplete enthält. Ein gängiges Muster ist, den GLM4.7-Eintrag zu duplizieren:
Wenn das ausgewählte Modell kein besonders gut trainiertes Modell für die Code-Vervollständigung ist, wird Continue Sie entsprechend darauf hinweisen. Sie sollten nun Codevorschläge vom ausgewählten Modell erhalten und den vorgeschlagenen Code einfach durch Drücken von
Tab
einfügen, ähnlich wie die Funktion der Standard-Code-Vervollständigung, die VS Code bietet, wenn Sie die geladenen Pakete überprüfen. Beide Vorschläge könnten gleichzeitig erscheinen, wobei das Drücken von Tab die VS Code-Funktion gegenüber Continue priorisiert. Es kann auch vorkommen, dass es einen Konflikt von Tastaturkürzeln zwischen Tab-Autocomplete und Tab-Spacing gibt, in welchem Fall das Tastaturkürzel für Tab-Spacing deaktiviert oder umgelegt werden muss in Ihren VS Code-Einstellungen. Gehen Sie in Einstellungen zu Tastaturkürzeln und suchen Sie nach „Tab“, dann deaktivieren oder ersetzen Sie die Tastaturbelegung des Tab-Befehls. Sie können die Tab-Autocomplete-Funktion mit den Befehlen
Strg
+
KStrg
+
A
deaktivieren. Leider gibt es keine Möglichkeit, die Tastaturbelegung von Tab-Autocomplete zu ändern.
Es ist auch möglich, eine Autocomplete-Vorschlag Wort für Wort durchzugehen, indem Sie
Strg
+
Rechts
eingeben. Beachten Sie, dass
Strg
+
Links
NICHT Schritte rückgängig macht. Das folgende Code-Beispiel wurde fast vollständig mit Tab-Autocomplete allein generiert, nachdem zunächst def plus eingegeben wurde, abgesehen von der Notwendigkeit, einige Einrückungen zu korrigieren.
Teilweise Tab-Autocomplete
Vollständige Tab-Autocomplete
Weitere Informationen zur Tab-Autocomplete, einschließlich weiterer Konfigurationsoptionen, finden Sie in der Continue-Dokumentation.
Zed
Zed ist ein beliebter VSCode-Konkurrent mit integrierter KI-Integration. Da die Chat AI-API OpenAI-kompatibel ist, folgen wir Zeds Dokumentation dazu. Ihre settings.json sollte ähnlich wie folgt aussehen:
Die Modellnamen stammen aus hier, die Kontextgrößen aus hier. Ihr API-Schlüssel wird über die Benutzeroberfläche konfiguriert. Öffnen Sie im Befehlspalette agent: open settings. Geben Sie Ihren API-Schlüssel im Dialog für „OpenAI“ ein. Für die AI-Editierfunktion von Zed siehe ihre Dokumentation.
MCP
Das Model Context Protocol (MCP) ist eine gemeinsame Schnittstelle für LLM-Schnittstellen, um Werkzeuge aufzurufen und zusätzlichen Kontext zu erhalten. Zed hat integrierte Unterstützung für das Ausführen von MCP-Servern und das automatische Aufrufen der exponierten Werkzeuge durch LLMs über OpenAI-API-Werkzeugaufrufe. Hier ist eine Beispielkonfiguration, um einen lokalen MCP-Server zu starten:
Emacs ist ein erweiterbares, anpassbares, freies/Offen-Quell-Text-Editor und mehr.
Mit Hilfe von gptel, einem einfachen Large Language Model Client, nutzen wir LLMs innerhalb von Emacs. gptel ist auf MELPA und NonGNU-devel ELPA verfügbar.
Da SAIA den OpenAI-API-Standard implementiert, ist die Konfiguration einfach.
Sie können nun von innerhalb von Emacs aus mit LLMs interagieren.
Agenter Coding
Agenter Coding geht über Chat und Inline-Vorschläge hinaus. Diese Werkzeuge nutzen die Fähigkeit des Modells, mehrstufige Aufgaben autonom abzuschließen. Das Modell kann Ihre Codebasis lesen, Dateien bearbeiten und Terminalbefehle ausführen.
Info
Vergleich mit kommerziellen Modellen: Die Seite Kommerzielle Modelle – Agenter Coding beschreibt agente Coding-Workflows mit externen Anbietern wie Codex und Claude Code. OpenCode und Claude Code unterstützen sowohl kommerzielle API-Schlüssel als auch einen SAIA-API-Schlüssel; die nachfolgenden Abschnitte beschreiben die SAIA-Einrichtung für beide. Die unten beschriebenen Werkzeuge bieten vergleichbare agente Coding-Funktionen mit Ihrem SAIA-API-Schlüssel und Modellen, die auf der HPC-Infrastruktur von GWDG gehostet werden. Dies ermöglicht es Nutzern, von modernen Code-Assistenten zu profitieren, während die Datenverarbeitung innerhalb der Infrastruktur des Instituts bleibt und so Datenschutz, Compliance und Vertraulichkeit gewährleistet werden. Für viele Forschungs- und Verwaltungsaufgaben stellt dies eine praktische Alternative zu externen KI-Diensten dar, ohne die Kernfunktionen des agenten Coding zu opfern.
Um die internen Modelle, die auf unserer Plattform gehostet werden, mit den unten genannten Werkzeugen zu nutzen, benötigen Sie einen SAIA-API-Schlüssel. Falls Sie noch keinen besitzen, verweisen Sie auf SAIA-API-Schlüssel, um einen zu beantragen. Externe Modelle sind nicht über die API verfügbar.
Für agente Coding-Aufgaben empfehlen wir, mit Modellen zu beginnen, die agente Fähigkeiten besitzen. Sie können aus der vollständigen Liste der verfügbaren Modelle auswählen.
Suchen Sie nach Modellen, die für folgendes optimiert sind:
Schlussfolgerung: Komplexes Problemlösen und Planung
Beim Auswahl eines Modells prüfen Sie, ob es in den Vorteilen oder der Beschreibung auf agente Aufgaben oder allgemeine Leistung verweist. Für komplexe agente Workflows empfehlen wir Modelle mit größeren Kontextfenstern (200K+ Tokens), um umfangreiche Codebasen und längere Prompts effektiv verarbeiten zu können.
Tipp
Für agente Coding-Aufgaben empfehlen wir, mit devstral-2-123b-instruct-2512 oder qwen3-coder-30b-a3b-instruct zu beginnen. Beide sind spezialisierte Code-Agent-Modelle. glm-4.7 ist ein allgemeines agentes Modell mit starker Codierungs-, Werkzeugnutzungs-, Terminal- und Web-Browsing-Fähigkeit.
Continue (Agentenmodus)
Continue ist primär ein Werkzeug zur Code-Vervollständigung und zum Chat – siehe den Abschnitt Code-Vervollständigung für die vollständige Einrichtung und Installation. Zusätzlich zu der Code-Vervollständigung unterstützt Continue auch agente Workflows über seinen integrierten Agentenmodus, in dem das Modell autonom Dateien lesen, Änderungen vornehmen und mehrstufige Aufgaben abschließen kann.
Um Continue für agente Aufgaben zu nutzen:
Öffnen Sie das Continue-Fenster in VS Code
Wechseln Sie im Continue-Fenster den Modus-Dropdown von Chat auf Agent
Senden Sie eine Aufgabe, z. B. bitten Sie es, eine Funktion zu refaktorisieren oder Fehlerbehandlung hinzuzufügen. Continue schlägt die Änderungen vor und bittet Sie, sie zu akzeptieren oder abzulehnen.
Anmerkung
Für vollständig autonome agente Workflows mit erweitertem Werkzeuggebrauch funktioniert OpenCode besonders gut mit SAIA-API-Schlüsseln.
OpenCode
OpenCode ist ein Open-Source, terminal-first AI-Code-Agent, der Entwicklern ermöglicht, Code zu generieren, Dateien zu bearbeiten, Befehle auszuführen und Entwicklungsprozesse direkt aus dem Terminal zu automatisieren. OpenCode unterstützt sowohl selbstgehostete als auch kommerzielle KI-Modelle über Provider-API-Schlüssel und ist daher für Teams und Entwickler geeignet, die state-of-the-art-Modelle nutzen möchten, während sie einen terminalzentrierten Workflow beibehalten. Sein Design ist besonders gut für SSH-Sitzungen, entfernte HPC-Umgebungen, CI/CD-Pipelines und tastaturbasierte Entwicklungsumgebungen geeignet. Dieser Abschnitt erklärt, wie Sie OpenCode mit Ihrem SAIA-API-Schlüssel konfigurieren. Für kommerzielle Modelle siehe die Anleitung für kommerzielle Modelle.
Tipp
Für die lokale Entwicklung empfehlen wir, OpenCode in einem gesicherten Container auszuführen, damit der Agent nur auf Ihr aktuelles Projekt zugreifen und nichts anderes auf Ihrem System beeinflussen kann. Die unten beschriebenen Schritte installieren OpenCode direkt auf Ihrem Gerät; für die gesicherte Container-Einrichtung siehe OpenCode in einem gesicherten Container am Ende dieses Abschnitts.
Installation
# npmnpm install -g opencode-ai
# oder mit curlcurl -fsSL https://opencode.ai/install | bash
Nach der Installation fügen Sie OpenCode zu Ihrem PATH hinzu:
Sie können opencode.json anpassen, um ein beliebiges Modell Ihrer Wahl auszuwählen, und sicherstellen, dass die Modell-ID genau mit den verfügbaren SAIA-Modellen übereinstimmt.
Starten
# Interaktives TUIopencode
# Einmalige Aufgabeopencode run "Schreibe Einheitstests für alle Funktionen in src/utils.py"
Modelle
Befehl
Aktion
/models
Öffnet den Modellauswähler, um zwischen SAIA-Modellen zu wechseln
Tipp
Wenn Modelle nicht angezeigt werden, öffnen Sie ein neues Terminal, damit SAIA_API_KEY geladen wird, und überprüfen Sie, ob es gesetzt ist (echo $SAIA_API_KEY). Wenn Sie OpenCode im VS Code-Terminal ausführen, laden Sie die Fenster neu (oder starten Sie VS Code neu), damit es die Variable erkennt.
Modi
Plan-Modus: Erstellen strukturierter Pläne für komplexe mehrstufige Aufgaben, Überprüfen und Anpassen der Schritte vor der Ausführung
Build-Modus: Ausführen genehmigter Pläne, Ausführen von Automatisierungen und Erstellen von Workflows
Grundbefehle
Befehl
Aktion
/help
Zeigt verfügbare Befehle an
Shift
+
Tab
Wechselt zwischen Plan- und Build-Modus
Hinzufügen von Kontext
Eingabe
Aktion
@
Dateiauswahl, um eine bestimmte Datei als Kontext hinzuzufügen
@dateiname
Direkte Referenz auf eine Datei durch Namen
Während einer Aufgabe
Taste
Aktion
Y
oder
Enter
Akzeptieren einer vorgeschlagenen Dateiänderung
N
Ablehnen einer vorgeschlagenen Dateiänderung
A
Alle vorgeschlagenen Änderungen auf einmal akzeptieren
Wenn Sie lieber in Ihrem Editor bleiben möchten, läuft die OpenCode-Extension den gleichen OpenCode-Agenten. Sie verwendet dieselbe opencode.json und SAIA-Konfiguration wie oben beschrieben, sodass keine zusätzliche Einrichtung erforderlich ist.
Öffnen Sie die Extensions-Ansicht (
Strg
+
Shift
+
X
unter Linux,
Cmd
+
Shift
+
X
unter macOS).
Suchen Sie nach OpenCode und installieren Sie es.
Starten Sie VS Code neu. OpenCode öffnet sich in einem Panel neben Ihrem Editor, wo Sie Aufgaben genauso wie im Terminal ausführen können.
Optional: SAIA-Modell-Plugin
Anstatt Modelle manuell in opencode.json aufzulisten, können Sie ein Plugin installieren, das Ihre SAIA-Modellliste automatisch aktuell hält. Beim Start von OpenCode holt es im Hintergrund die aktuelle Modellliste von der SAIA-API und fügt sie Ihrer globalen Konfiguration hinzu, sodass neue Modelle ohne manuelle Bearbeitung erscheinen.
Stellen Sie sicher, dass SAIA_API_KEY gesetzt ist (siehe Setzen Sie Ihren API-Schlüssel), und folgen Sie den Einrichtungsschritten im Repository. Es holt die aktuelle Modellliste von der SAIA-API und generiert eine opencode.json mit allen verfügbaren Modellen, kategorisiert (Schlussfolgerung, Code, Vision, agente usw.).
Anmerkung
Dieses Plugin wurde von einem GWDG-Mitarbeiter als Nebenprojekt entwickelt, nicht als offiziell unterstützter Dienst. Wir können sein Verhalten in Zukunft nicht garantieren und keine Unterstützung dafür bieten.
OpenCode in einem gesicherten Container (empfohlen)
Für die lokale Entwicklung empfehlen wir, OpenCode in einem Container auszuführen. Der Container mountet nur Ihr aktuelles Projektverzeichnis, sodass der Agent Ihre Projektdateien lesen und bearbeiten kann, aber keine Befehle ausführen kann, die Dateien außerhalb Ihres Systems beeinflussen. Dies ist die empfohlene, sichere Methode, um OpenCode lokal zu nutzen.
Sie erstellen das Image einmal und verwenden es dann in jedem Projekt. Das Image ist generisch und nicht an ein bestimmtes Projekt gebunden und stört kein vorhandenes Dockerfile Ihres Projekts.
Voraussetzungen: Docker oder Podman auf Ihrem System installiert.
Einmalige Einrichtung
Sie führen diese vier Schritte nur einmal aus.
1. Erstellen Sie eine Datei namens Dockerfile (Großbuchstabe D, keine Erweiterung) in einem beliebigen Ordner Ihrer Wahl (erstellen Sie einen mit mkdir opencode-sandbox). Dies ist der Standardname, den Docker standardmäßig verwendet. Ein anderer Name wie dockerfile (klein) oder Dockerfile.txt kann dazu führen, dass das Build-Prozess es nicht findet, also bleiben Sie bei Dockerfile. Fügen Sie den folgenden Code in Ihre Dockerfile ein:
FROMnode:20-slim# Installieren von OpenCodeRUN npm install -g opencode-aiWORKDIR/workspaceCMD ["opencode"]
Wenn Ihre Projekte eine bestimmte Sprachlaufzeit benötigen (z. B. Python oder Python mit uv), fügen Sie diese hier hinzu, bevor Sie das Image bauen. Der Container hat nur das, was Sie hier installieren.
2. Erstellen Sie das Image. Gehen Sie in den Ordner, der die Dockerfile enthält, und führen Sie aus:
cd opencode-sandbox # der Ordner, in dem Sie die Dockerfile gespeichert habendocker build -t opencode-sandbox .
Das . bedeutet „baue mit der Dockerfile im aktuellen Ordner“, sodass Sie den Pfad nicht eingeben müssen. (Ersetzen Sie docker durch podman, falls Sie Podman verwenden.) Sie wiederholen diesen Schritt nur, wenn Sie die Dockerfile ändern.
Bestätigen Sie, dass das Image erstellt wurde:
docker images | grep opencode-sandbox
3. Fügen Sie das run-opencode-Alias hinzu. Das Alias muss in Ihrer Shell-Konfigurationsdatei geschrieben werden (das Tippen einmal am Prompt dauert nur für dieses Terminal). Hier ist die einzeilige Version, die alte Aliase entfernt und das saubere Alias in ~/.bashrc hinzufügt:
sed -i '/alias run-opencode=/d' ~/.bashrc && cat >> ~/.bashrc << 'EOF'
alias run-opencode='docker run -it --rm --user "$(id -u):$(id -g)" -e HOME=/tmp -e SAIA_API_KEY="$SAIA_API_KEY" -v "$PWD":/workspace -w /workspace opencode-sandbox'
EOF
Anmerkung
Wenn Sie zsh statt bash verwenden (überprüfen Sie mit echo $SHELL, ob es mit /zsh endet), fügen Sie das Alias in ~/.zshrc anstelle von ~/.bashrc hinzu und laden ~/.zshrc im nächsten Schritt. Das Hinzufügen zu ~/.bashrc hat unter zsh keine Wirkung.
4. Laden Sie Ihre Shell neu, damit das Alias verfügbar ist:
source ~/.bashrc # oder: source ~/.zshrc
Überprüfen Sie, ob das Alias registriert ist:
alias run-opencode
Dies sollte die Alias-Definition zurückgeben. Wenn ja, ist die Einrichtung abgeschlossen.
Verwendung in einem Projekt
Dies ist das, was Sie jedes Mal tun, wenn Sie an einem Projekt arbeiten möchten. Beachten Sie, dass Sie run-opencode aus dem Projekt heraus ausführen, das Sie bearbeiten möchten, nicht aus dem Sandbox-Ordner, in dem Sie das Image gebaut haben.
1. Stellen Sie sicher, dass Ihr API-Schlüssel in der aktuellen Shell gesetzt ist (siehe Setzen Sie Ihren API-Schlüssel):
echo $SAIA_API_KEY # sollte Ihren Schlüssel ausgeben, nicht leer sein
2. Gehen Sie in das Projekt, das Sie bearbeiten möchten, und stellen Sie sicher, dass es eine opencode.json enthält (die SAIA-Konfiguration aus Erstellen der Projekt-Konfiguration):
cd ~/pfad/zu/ihrem/projekt
Platzieren Sie opencode.json im Stammverzeichnis des Projekts (dem Ordner, aus dem Sie run-opencode ausführen). Der Container mountet diesen Ordner als Arbeitsverzeichnis, sodass OpenCode die Konfiguration automatisch erkennt. Eine globale/Heim-Konfiguration auf Ihrem Host ist im Sandbox nicht sichtbar, daher benötigt jedes Projekt seine eigene.
3. Starten Sie den Sandbox:
run-opencode
Dies startet den Container mit dem aktuellen Ordner als mount und startet OpenCode. Der Agent kann die Dateien in diesem Ordner lesen und bearbeiten, aber nichts außerhalb davon.
Anmerkung
Da der Container nur das aktuelle Projektverzeichnis mountet, kann OpenCode keine Dateien außerhalb davon ändern. Dies macht die Einrichtung zu einem sicheren Sandbox für agente Nutzung. Das Projektverzeichnis selbst bleibt vom Agenten editierbar, was beabsichtigt ist.
Fehlerbehebung
run-opencode: Befehl nicht gefunden: Das Alias ist nicht in Ihrer Shell geladen. Überprüfen Sie, ob es in Ihrer Konfigurationsdatei steht:
grep -n run-opencode ~/.bashrc # oder ~/.zshrc
Wenn nichts ausgegeben wird, wurde das Alias nie in die Datei geschrieben (es wurde nur am Prompt eingegeben). Wiederholen Sie Schritt 3 der einmaligen Einrichtung, dann source die Datei erneut.
Wenn es das Alias ausgibt, aber der Befehl immer noch nicht gefunden wird, bestätigen Sie, dass Sie die Datei bearbeiten, die Ihre Shell tatsächlich liest: Führen Sie echo $SHELL aus und verwenden Sie ~/.zshrc für zsh oder ~/.bashrc für bash. Wenn OpenCode startet, aber kein Modell erreichen kann: dann erreicht der Schlüssel den Container nicht oder das Projekt hat keine gültige Konfiguration. Bestätigen Sie, dass echo $SAIA_API_KEY Ihren Schlüssel ausgibt, und dass das Projektverzeichnis eine gültige opencode.json enthält.
Tipp
Beibehalten neben einem vorhandenen Dockerfile: Wenn Sie die Sandbox-Dockerfile innerhalb eines Projekts behalten möchten, das bereits sein eigenes hat, geben Sie ihr einen anderen Namen (z. B. Dockerfile.opencode) und bauen mit docker build -f Dockerfile.opencode -t opencode-sandbox ..
Abhängigkeiten: Der Container hat nur das, was Sie in der Dockerfile installieren. Wenn ein Projekt zusätzliche Tools oder Systempakete benötigt, fügen Sie diese in die Dockerfile ein und bauen das Image erneut.
Claude Code (Sichere Einrichtung)
Claude Code ist Anthropics terminal-first Code-Agent, ebenfalls als VS Code-Erweiterung verfügbar. Diese Einrichtung läuft auf den Modellen in unserem Cluster mit nur einem SAIA-API-Schlüssel, sodass Ihr Code und Ihre Prompts auf der GWDG-Infrastruktur bleiben.
Claude Code installiert. Die Installation ist dieselbe wie bei der kommerziellen Einrichtung, daher folgen Sie den bestehenden Anweisungen: CLI installieren oder VS Code-Erweiterung installieren.
Nur die Konfiguration unterscheidet sich, und das ist, was der nächste Abschnitt behandelt.
Konfiguration
Erstellen oder aktualisieren Sie ~/.claude/settings.json (Windows: %USERPROFILE%\.claude\settings.json), fügen Sie den folgenden Block ein und ersetzen Sie <ihr SAIA-API-Schlüssel> durch Ihren eigenen Schlüssel:
Starten Sie eine Sitzung mit dem claude-Befehl oder öffnen Sie die Claude-Leiste in VS Code. Da die Einstellungsdatei in Ihrem Benutzerprofil liegt, gelten diese Werte für jede Claude Code-Sitzung unabhängig vom Shell, aus der sie gestartet wird. Verifizieren Sie die Konfiguration.
Wenn Sie die VS Code-Erweiterung verwenden, aktivieren Sie zusätzlich die Benutzereinstellung Claude Code: Login-Prompt deaktivieren, damit die Erweiterung nicht nach einem Anthropic-Login fragt. Sie können sie auch direkt in Ihrer VS Code-Benutzer-settings.json setzen:
{
"claudeCode.disableLoginPrompt": true}
Tipp
Die Konfiguration oben ist alles, was die meisten Menschen benötigen. Alles darunter ist Referenzmaterial: Was jede Einstellung bewirkt, wie man Modelle wechselt und wie die Berechtigungsregeln funktionieren. Kommen Sie dazu zurück, wenn Sie es brauchen.
Anmerkung
ANTHROPIC_MODEL und ANTHROPIC_DEFAULT_HAIKU_MODEL sind beide erforderlich. Ohne sie fordert Claude Code Anthropic-Modellnamen an, die über SAIA nicht verfügbar sind, und jede Anfrage schlägt fehl.
Was die Variablen tun
Variable
Bedeutung
ANTHROPIC_BASE_URL
Leitet alle Anfragen an SAIA statt an Anthropic weiter (ohne /v1)
ANTHROPIC_AUTH_TOKEN
Ihr SAIA-API-Schlüssel (als Authorization: Bearer gesendet)
ANTHROPIC_MODEL
Hauptmodell für die Arbeit
ANTHROPIC_DEFAULT_HAIKU_MODEL
Modell für Hintergrundaufgaben wie Titel und Zusammenfassungen
ANTHROPIC_DEFAULT_OPUS_MODEL
Füllt den „opus“-Slot in der /model-Liste
ANTHROPIC_DEFAULT_SONNET_MODEL
Füllt den „sonnet“-Slot in der /model-Liste
CLAUDE_CODE_MAX_CONTEXT_TOKENS
Kontextfenster des Modells. Der Beispielwert ist ein Platzhalter, passen Sie ihn an das Modell in ANTHROPIC_MODEL an. Der Wert pro Modell steht in der Spalte „Kontextfenster in Tokens“ der Modellliste. Ohne ihn nimmt Claude Code 200.000 Tokens an
CLAUDE_CODE_DISABLE_ADAPTIVE_THINKING
Nicht alle internen Modelle sind Schlussfolgerungsmodelle; für diese hat der Parameter keine Wirkung und kann Fehler verursachen
CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS
Verhindert das Senden von Feldern, die der Backend-Server nicht auswertet
CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC
Schaltet die verbleibenden Verbindungen zu Anthropic-Diensten ab. Das Ändern der Basis-URL leitet nur Modellanfragen um; Telemetrie, Fehlerberichte und der Auto-Updater sprechen sonst weiterhin mit Anthropic. Dieser eine Variable deckt den Großteil ab; die DISABLE_*-Variablen darunter werden zusätzlich gesetzt und dokumentieren den Zweck explizit. Es ist auch die Voraussetzung dafür, dass eine benutzerdefinierte Modellliste überlebt (siehe Methode 3)
DISABLE_TELEMETRY
Keine Telemetriedaten an Anthropic
DISABLE_ERROR_REPORTING
Keine Fehlerberichte an Anthropic
DISABLE_BUG_COMMAND
Deaktiviert den /bug-Befehl
DISABLE_AUTOUPDATER
Keine automatischen Updates. Aktualisierungen erfolgen über Ihr Paket- oder Image-Prozess
Setzen Sie absichtlich ein kleines Modell für Hintergrundaufgaben. Dies reduziert den Token-Verbrauch spürbar, ohne die Ergebnisqualität zu beeinträchtigen. Optional kann CLAUDE_CODE_SUBAGENT_MODEL im gleichen env-Block das Modell für Subagenten festlegen. Die Einstellung der Schlussfolgerungsebene (“Aufwand”) hat bei den internen Modellen keine Wirkung.
Eine projektbezogene .claude/settings.json im Repository wird zusätzlich angewendet und ist eine bequeme Möglichkeit, eine vorkonfigurierte Einrichtung an ein Team zu übertragen. Der API-Schlüssel gehört nicht in diese Datei, da er committet wird. Setzen Sie nur die verbleibenden Variablen dort.
Modellwechsel
Es gibt drei Möglichkeiten, ein Modell auszuwählen. Methode 1 reicht in den meisten Fällen aus.
Methode 1: Modellname direkt eingeben (keine Konfiguration)
Eingegeben in der laufenden Sitzung, nichts wird in eine Datei geschrieben:
/model qwen3.5-397b-a17b
Beim Start entsprechend:
claude --model qwen3.5-397b-a17b
Jedes Modell im Cluster ist auf diese Weise erreichbar, auch wenn es nicht in der Auswahlliste erscheint. Sie müssen nur den Modellnamen kennen.
Methode 2: Drei Modelle in die Auswahlliste einfügen
Der /model-Befehl öffnet eine Liste mit drei festen Feldern mit den Bezeichnungen „opus“, „sonnet“ und „haiku“. Diese drei Felder können mit SAIA-Modellen gefüllt werden, indem Sie den folgenden Block in das env-Block in ~/.claude/settings.json hinzufügen:
Die Liste bietet dann drei SAIA-Modelle. Die Bezeichnungen „opus“, „sonnet“ und „haiku“ bleiben unverändert; die hinter ihnen stehenden Modelle sind die, die Sie eingegeben haben. Diese Methode bietet maximal diese drei Felder.
Methode 3: Alle Modelle in die Auswahlliste einfügen.
Dies ist optional und nicht offiziell unterstützt. Zwei verschiedene Dateien sind beteiligt:
Voraussetzung:"CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1" im env-Block in ~/.claude/settings.json. Ohne sie überschreibt Claude Code die Modellliste bei jedem Start.
Modellliste: Auf der obersten Ebene von ~/.claude.json, eine andere Datei. Erweitern Sie sie mit dem Schlüssel unten, während keine Sitzung läuft, ersetzen Sie die Datei nicht:
value ist die Modell-ID; label und description sind freie Anzeigetexte. Die eingebauten Einträge (Standard, Opus, Sonnet) bleiben sichtbar, sind aber über SAIA nicht verwendbar. Die Embedding-Modelle sind absichtlich ausgelassen, ebenso wie devstral-2-123b-instruct-2512, das Anfragen von Claude Code ablehnt. Das Ausführen von /logout löscht den Eintrag.
Berechtigungen und Sandbox
Claude Code hat Dateizugriff und führt Befehle aus, daher gilt die gleiche Empfehlung wie für OpenCode: Führen Sie es in einem gesicherten Container aus, der nur Ihr aktuelles Projektverzeichnis mountet. Der Container ist die äußere Sicherheitsgrenze; das Berechtigungssystem ist die zweite Schicht und sollte verwendet werden, anstatt umgangen zu werden.
Behalten Sie den Berechtigungs-Dialog aktiviert. Vermeiden Sie --dangerously-skip-permissions außerhalb eines Container-Sandboxes, und selbst innerhalb eines solchen macht es nur Sinn für Aufgaben ohne Netzwerk und ohne Zugriff auf Geheimnisse.
Ausschließen Sie den Zugriff auf Geheimnisse und unzusammenhängende Verzeichnisse mit Verweigerungsregeln.
Verweigerungsregeln können auch sicherstellen, dass Merge- und Bereitstellungsaufgaben manuell bleiben.
Die Verweigerungsregeln gehen in ~/.claude/settings.json als zweiter Block neben env ein, wie im Konfigurationsabschnitt oben gezeigt. Dieser Block kann erweitert werden, z. B. um ausgehenden Webzugriff zu blockieren:
WebFetch und WebSearch können weggelassen werden, wo Ihre Netzwerkregeln bereits ausgehenden Traffic blockieren; die Verweigerungsregeln machen die Einschränkung unabhängig von der Container-Konfiguration wirksam. Siehe Berechtigungsmodi für das vollständige Berechtigungsmodell.
Verifizieren der Konfiguration
Bevor Sie starten, überprüfen Sie URL und Schlüssel unabhängig vom Tool:
Eine Antwort mit "type":"message" bestätigt den Zugriff.
Innerhalb der Sitzung führen Sie /status aus und überprüfen zwei Zeilen:
Anthropic base URL muss https://chat-ai.academiccloud.de anzeigen. Wenn die Zeile fehlt, hat die Variable die Sitzung nicht erreicht und wird weiterhin der Anthropic-API verwendet.
Auth token muss ANTHROPIC_AUTH_TOKEN nennen. Wenn stattdessen eine Login method-Zeile mit einem persönlichen Konto erscheint, ist der SAIA-Schlüssel nicht aktiv.
Einschränkungen
Claude Code ist für Anthropic-Modelle konzipiert, und der Anbieter unterstützt explizit keine Ausführung mit anderen Modellen. Bei größeren Aufgaben erwarten Sie schwächere Ergebnisse als mit den nativen Modellen, insbesondere bei Werkzeugnutzung wie Lesen und Bearbeiten von Dateien oder Ausführen von Befehlen. OpenCode ist von Design her anbieterunabhängig und ist der bessere Ausgangspunkt, wenn Sie solche Probleme haben.
Cline
Cline ist ein Open-Source-Coding-Agent, der große Sprachmodell-Schlussfolgerung mit praktischen Entwickler-Workflows kombiniert. Dieser Abschnitt beschreibt die Hauptvorteile von Cline, erläutert sein Plan → Handeln-Interface und führt eine Installation durch, die Cline mit SAIA-Modellen verbindet.
Der Plan → Handeln-Loop
Plan-Modus: Sie können ein Ziel beschreiben, z. B. „OAuth2-Login hinzufügen“. Cline antwortet mit einem nummerierten Plan, der Dateiänderungen und Befehle aufzählt.
Überprüfung: Bearbeiten Sie die Checkliste oder bitten Sie Cline, sie zu verfeinern. Nichts ändert sich im Arbeitsbereich, bis Sie genehmigen.
Handeln-Modus: Cline führt jeden Schritt aus: Bearbeitet Dateien, führt Befehle aus und zeigt Unterschiede an. Sie bestätigen oder lehnen Aktionen in Echtzeit ab.
Diese Trennung gibt dem Agenten Autonomie, ohne die menschliche Kontrolle zu entfernen.
Installationsanleitung (VS Code)
Bitte finden Sie die Installationsanweisungen unten:
Voraussetzungen
Visual Studio Code (v1.93 oder neuer)
SAIA-API-Schlüssel
Node 18+ für optionalen CLI-Gebrauch
Erweiterung installieren
Suchen Sie in VS Code-Markt nach Cline und installieren Sie es.
Verbindung zu CoCo AI herstellen
Öffnen Sie Cline (Befehlspalette → „Cline: In neuem Tab öffnen“).
Klicken Sie auf „Mit eigenem API-Schlüssel einrichten“ und wählen Sie „OpenAI-kompatibel“.
Füllen Sie die Felder aus:
Feld
Wert
Basis-URL
https://chat-ai.academiccloud.de/v1
API-Schlüssel
Ihr SAIA-API-Schlüssel
Modell-ID
glm-4.7 (weitere nach Bedarf hinzufügen)
Fügen Sie zusätzliche Modelle (z. B. qwen3-30b-a3b-instruct-2507) mit derselben URL und demselben Schlüssel hinzu, falls erforderlich.
Weisen Sie Rollen zu (falls Sie ein anderes Modell für Plan und Handeln verwenden möchten): Setzen Sie z. B. glm-4.7 für Handeln; setzen Sie qwen3-30b-a3b-instruct-2507 für Plan.
Täglicher Workflow
Hier ist der tägliche Workflow:
Plan → Plan genehmigen → Handeln → Unterschiede überprüfen → Iterieren
Cline schließt die Lücke zwischen chatbasierten Assistenten und vollständiger IDE-Automatisierung. Mit einer kurzen Einrichtung, die auf CoCo AI zeigt, wird es ein flexibler Co-Entwickler für komplexe Codebasen, während die Kontrolle des Entwicklers erhalten bleibt.
Community-Beiträge
Vielen Dank an alle, die dazu beitragen, diese Community durch Code-Beiträge, Tipps oder Unterstützung im KI-Community-Chat zu verbessern. Die folgende Sammlung enthält Lernmaterialien und Werkzeuge, die von Mitgliedern der Community freundlicherweise zur Verfügung gestellt wurden, damit alle sie nutzen können.
Anmerkung
Bitte beachten Sie, dass wir aufgrund der Vielzahl der Beiträge nicht alle detailliert überprüfen können. Daher können wir weder die Funktionalität garantieren noch sicherstellen, dass sie aktuell gehalten werden.
Verfügbare Beiträge
Unten finden Sie eine umfassende Tabelle mit den Community-Beiträgen, die jeweils wichtige Informationen zu jedem Projekt enthalten. Eine detaillierte Beschreibung finden Sie weiter unten:
Objektorientierter SAIAClient sowie funktionale Einzelmethoden; umfasst Chat-Vervollständigungen (mit Streaming und Werkzeugaufruf), Spracherkennung/Übersetzung (Whisper), Dokumentenkonvertierung (Docling/PDF), RAG über ARCANA, Modellauflistung, Token-Tools (Token-Zählen, Subwort-Fruchtbarkeit) und Rate-Limit-Überprüfung;
Python-Entwickler, die SAIA-Dienste in Skripte, Notebooks oder Anwendungen integrieren möchten. Installieren mit pip install saia-python
Einzelnes Skript (saia.sh); umfasst Modelle, Rate-Limits, Docling-Dokumentenkonvertierung, Embeddings, Audioverarbeitung, Einzelschritt-Chat-Vervollständigungen, Text-/Bildgenerierung und ARCANA RAG-Abfragen; liest Prompts von stdin für Pipeline-Nutzung; erfordert nur curl, jq und base64; keine Installation nötig, herunterladen und ausführen
Schnelle Terminal-Tests, Shell-Pipelines und lightweight-Automatisierung ohne Python-Umgebung
Leichtgewichtiger FastAPI-Dienst (Docker Compose bereit); übersetzt das docling-serve-Multipart-API-Format von Open WebUI in die GWDG-Docling-API; gibt Markdown, JSON, HTML, Klartext und Doctags-Ausgabe zurück; konfigurierbar über Umgebungsvariablen (GWDG_API_KEY, GWDG_API_URL); enthält Health-Check-Endpunkt;
Open WebUI-Nutzer, die die GWDG-Dokumentenkonvertierungs-Backend-Infrastruktur anstelle einer lokalen docling-serve-Instanz nutzen möchten
Schritt-für-Schritt-Blog-Beitrag (auf Deutsch), der den kompletten Workflow zur Erstellung eines Chatbots mit benutzerdefinierten Dokumentenquellen mithilfe des GWDG-ARCANA-Dienstes in Chat AI abdeckt; behandelt Arcana-Konfiguration, Dokumenten-Indexierung und Abfragen, gerichtet an Nutzer ohne vorherige RAG-Erfahrung
Lernen, kostenfreie, datenschutzfreundliche Chatbots mit eigenen Quellen über Chat AI zu erstellen
Bash-Skript, das die aktuellste SAIA-Modellliste von der API abruft und eine opencode.json mit allen Modellen korrekt kategorisiert (Schlussfolgerung, Code, Vision, Medizin, Forschung, agente, großes Kontextfenster, allgemein) generiert; unterstützt LiteLLM-Proxy-Integration; erfordert nur curl und jq
Entwickler, die SAIA-Modelle direkt in ihren Code-Assistenten verwenden möchten
SAIA bietet selbst gehostete, OpenAI-kompatible KI-Dienste bei GWDG, einschließlich Chat-Vervollständigungen, Spracherkennung/Übersetzung, Dokumentenkonvertierung und RAG (ARCANA). Diese Python-Wrapperalib für die GWDG-SAIA REST-API wurde von Friedrich Schwarz von der Uni Göttingen entwickelt, um eine saubere, wartbare Verbindung zwischen Python-Workflows und diesen Diensten herzustellen. Friedrich hat das Projekt GWDG zur Verfügung gestellt, um eine mögliche Zusammenarbeit zu ermöglichen, und hat seine Bereitschaft zur Pflege des Pakets für andere Nutzer angekündigt, abhängig von seiner zukünftigen Position.
Die Bibliothek bietet sowohl einen objektorientierten SAIAClient als auch gleichwertige funktionale Einzelmethoden für Nutzer, die einen funktionalen Stil bevorzugen. Streaming-Antworten und OpenAI SDK-Kompatibilität sind unterstützt. API-Zugangsdaten werden automatisch aus der SAIA-Umgebungsvariable, einer .saia_api-Datei oder einer .env-Datei erkannt.
Vollständige Sphinx-Dokumentation ist online verfügbar; ein interaktives Demo-Notebook ist im Repository enthalten.
Ein einfacher, minimaler Abhängigkeits-Bash-CLI-Client für die SAIA-API. Dieser Client bietet eine minimalistische Möglichkeit, direkt über Ihre Terminal-Sitzung mit allen SAIA-Diensten und Inferenz-Endpunkten zu interagieren, was ihn ideal für schnelle Tests, Shell-Pipelines und lightweight-Automatisierung macht.
Beigetragen von Egor Kotov vom Max-Planck-Institut für demografische Forschung, als leichtgewichtige Alternative für Nutzer, die keine vollständige Python-Umgebung benötigen. Das Projekt wurde GWDG zur Verfügung gestellt.
Der Client ist ein einzelnes Bash-Skript, das keine Installation außer curl, jq und base64 erfordert. Laden Sie das Skript direkt in das Verzeichnis ~/.local/bin herunter und es ist sofort verwendbar.
Unterstützt alle wichtigen SAIA-Endpunkte: Modellauflistung, Rate-Limit-Überprüfungen, Docling-PDF-zu-Markdown-Konvertierung, Embeddings, Audio-Transkription/Übersetzung, Chat-Vervollständigungen mit benutzerdefinierten Systemprompts, Textgenerierung, Bildgenerierung und ARCANA RAG-Abfragen. Akzeptiert Prompts über stdin, was die Integration in Shell-Pipelines erleichtert.
Ein FastAPI-basierter Proxy-Dienst, der mit Docker Compose bereitgestellt werden kann. Open WebUI erwartet ein docling-serve-kompatibles API, während GWDG seine eigene Docling-API mit einem anderen Anfrage-/Antwort-Format bereitstellt.
Dieser Proxy schließt die Lücke, indem er die Multipart-Datei-Uploads von Open WebUI empfängt, sie an die GWDG-Docling-API mit Bearer-Authentifizierung weiterleitet und die Antwort in das docling-serve-Format transformiert, das Open WebUI erwartet (Rückgabe von Markdown, JSON, HTML, Klartext und Doctags).
Konfigurieren Sie über eine .env-Datei mit Ihrem GWDG_API_KEY (SAIA-API-Schlüssel).
Ein Blogbeitrag auf Deutsch von der Universität Hamburg, der den gesamten Prozess der Einrichtung eines retrieval-augmentierten Chatbots mithilfe des GWDG-ARCANA-Dienstes innerhalb von Chat AI beschreibt.
Bedeckt alles von der ersten Arcana-Konfiguration und dem Hochladen eigener Dokumente bis hin zur Abfrage des resultierenden Chatbots, mit Fokus auf Kostenminimierung und datenschutzfreundliche Datenverarbeitung.
Ein OpenCode-Plugin, entwickelt von Tobias Weiß (graphwiz-ai), basierend auf einem ursprünglichen Nebenprojekt von Jaison Lewis bei GWDG. Es integriert alle SAIA-(GWDG-Chat AI)-Modelle direkt in OpenCode-Konfigurationen.
Das Plugin ruft die aktuellste SAIA-Modellliste von der API ab und generiert automatisch eine korrekt kategorisierte opencode.json-Konfigurationsdatei mit Modellen, die nach Anwendungsfall organisiert sind: Schlussfolgerung, Code, Vision, Medizin, Forschung, agente, großes Kontextfenster und allgemein.
Die Modelle werden mit reichhaltigen Metadaten angereichert, einschließlich Kontextfenstergrößen, Ausgabegrenzen, Schlussfolgerungsflags und Vision-Fähigkeiten. Das Plugin generiert bequeme Aliase (z. B. saia/best-for-coding, saia/best-for-reasoning) und unterstützt die LiteLLM-Proxy-Integration für Caching und Rate-Limiting.
Die Installation ist plattformübergreifend (Linux/macOS/Windows) und erfordert nur curl und jq.
Das Plugin wird auf Codeberg gepflegt, mit einem Mirror auf GitLab, und enthält JSON-Schema-Validierung, umfassende Dokumentation und Fehlerbehebungsanleitungen.
Image AI
Image AI ist ein generativer KI-Tool zur Erstellung visueller Inhalte. Er unterstützt die Text-zu-Bild-Generierung, bei der eine natürlichsprachliche Beschreibung in ein neues Bild umgewandelt wird, sowie die Bild-zu-Bild-Transformation, bei der ein bestehendes Bild anhand eines Prompts oder eines Stilbeispiels verändert oder neu gestaltet wird. Wie bei anderen GWDG-Diensten werden die Nutzerdaten sicher gehalten und nicht gespeichert oder zur Weiterbildung von KI-Modellen verwendet. Die einfache, benutzerfreundliche Web-Oberfläche erleichtert das Erstellen und Speichern von Bildern.
Aktuelle Modelle
Image AI bietet moderne Open-Weight Modelle, die auf unserer Plattform mit hohen Standards zum Datenschutz gehostet werden. Die Daten, die an diese Modelle gesendet werden - einschließlich der Prompts und Bilder - werden an keiner Stelle in unseren Systemen gespeichert.
Verfügbare Modelle werden regelmäßig aktualisiert, sobald neuere, leistungsfähigere Versionen veröffentlicht werden. Wir wählen Modelle für unsere Dienste basierend auf Nutzerbedarf, Kosten und Leistung in verschiedenen Benchmarks. Bestimmte Modelle sind für spezifische Aufgaben besonders gut geeignet, was unten nach bestem Wissen beschrieben wird.
Hier ist eine kurze Beschreibung der Komponenten der Web-Oberfläche:
Modellauswahl: Wählen Sie das Modell aus, das Sie verwenden möchten.
Prompt: Geben Sie Ihre Textbeschreibung ein, um ein Bild zu generieren.
Hochladen: Laden Sie ein Bild hoch, um es mit dem Bild-zu-Bild-Modell zu bearbeiten.
Erweiterte Optionen: Legen Sie Breite, Höhe und Anzahl der Ausgabebilder fest.
Open-Weight Modelle, gehostet von GWDG
FLUX.1-schnell
FLUX.1-schnell ist ein schnelles, leistungsstarkes Text-zu-Bild-Generationsmodell, das auf Geschwindigkeit optimiert ist, während gleichzeitig eine hohe visuelle Qualität erhalten bleibt. Dieses Modell wurde von Black Forest Labs entwickelt.
Wichtige Fähigkeiten:
Schnelle Generierung von Bildern aus Textprompts.
Erhält trotz Fokus auf Geschwindigkeit eine kohärente Komposition und Stil.
Unterstützt vielfältige künstlerische und fotorealistische Ausgaben.
Gut in der Darstellung komplexer Szenen mit angemessener Treue.
Das Qwen-Image-Edit-2511-Modell nimmt Bilder und einen Textprompt als Eingabe. Sie können ein Bild hochladen und es bearbeiten, indem Sie eine Textbeschreibung als Prompt angeben. Seine Fähigkeiten für sowohl semantische als auch optische Bearbeitung machen dieses Modell zu einem leistungsfähigen Werkzeug zur Bildbearbeitung. Ein weiteres wichtiges Merkmal ist die Möglichkeit, Text innerhalb Ihres hochgeladenen Bildes hinzuzufügen, zu löschen oder zu ändern. Weitere Informationen zu diesem Modell finden Sie auf dieser Seite.
Datenschutz
Durch die Benutzerauthentifizierung über SSO und die Ausführung des Dienstes auf der HPC-Infrastruktur von GWDG stellen wir die Privatsphäre und Sicherheit der Nutzerdaten sicher.
Unterabschnitte von Image AI
Bild-KI FAQ
Datenschutz
Werden meine Prompts oder Nutzungsdaten für die KI-Weiterbildung oder ähnliche Zwecke verwendet?
Nein, Ihre Prompts und Daten werden nicht zur Weiterbildung von KI-Modellen verwendet.
Werden meine Prompts und generierten Bilder zu irgendeinem Zeitpunkt auf Ihren Servern gespeichert?
Der Benutzerprompt wird nur während des Inferenzprozesses auf dem GWDG-Server gespeichert. Nach Beendigung einer Sitzung im Browser sind die Eingaben des Benutzers nicht mehr verfügbar. Generierte Bilder werden nicht gespeichert.
Welche Daten speichert Image AI, wenn ich den Dienst nutze?
Es wird ein Protokoll geführt, das die Anzahl der Anfragen pro Benutzer und die jeweiligen Zeitstempel enthält. Die Protokolle werden gemäß den GWDG-Richtlinien ein Jahr lang gespeichert. Die Erfassung von Daten für die Bereitstellung der Website und die Speicherung der Daten in Protokolldateien ist für den Betrieb der Website unbedingt erforderlich. Daher besteht für den Nutzer keine Möglichkeit, dagegen zu widersprechen.
Verfügbarkeit
Meine Institution ist an der Nutzung von Image AI interessiert. Können wir es für unsere Nutzer bewerben? Könnten Sie eine zusätzliche Last für XXX Nutzer bewältigen?
Für große Institutionen kontaktieren Sie uns bitte direkt unter info@kisski.de.
Sind die Bild-KI-Dienste kostenlos?
Bild-KI-Dienste, die mit einem Academic Cloud-Konto zugänglich sind, sind kostenlos.
Kommerzielle Modelle
GWDG bietet Zugang zu ausgewählten kommerziellen Grundmodellen (z. B. OpenAI GPT, Anthropic Claude) über Microsoft Azure oder direkt über Anthropic Enterprise-Lizenzen. Für den Zugriff auf KI-Modelle über SAIA, einschließlich lokal gehosteter und externer Modelle, siehe SAIA. Dieser Abschnitt dokumentiert den Zugriff auf das kommerzielle Angebot und die dazugehörigen Agenten-Coding-Werkzeuge.
Warnung
Kommerzielle Modelle sind externe Cloud-Dienste. Gehen Sie nicht davon aus, dass dieselben Garantien für Datenlokalisierung gelten wie bei lokal gehosteten Diensten wie SAIA. KI-Systeme können Halluzinationen erzeugen, und sensible oder vertrauliche Daten sollten nur verarbeitet werden, wenn dies für Ihren Anwendungsfall erlaubt ist.
Info
Der kommerzielle Zugang wird nach Nutzung abgerechnet. Für A1 und A2 beträgt das ursprüngliche monatliche Budget, das während der Onboarding-Phase kommuniziert wurde, keine feste Ausgabenobergrenze – es gibt derzeit keine technischen Sicherungen, die verhindern, dass die Kosten diesen Betrag überschreiten. Benutzer sind daher für die Überwachung ihrer eigenen Nutzung verantwortlich. Für A3 (Anthropic Claude Enterprise) ist eine personenbezogene, feste monatliche Budgetobergrenze durch GWDG festgelegt. Für institutionelle Verträge, optionalen Zugang zu externen Modellen und Einschränkung des Zugriffs siehe Institutioneller Zugang zu KI-Diensten.
Zugriffsoptionen
Das kommerzielle Modellangebot besteht aus drei ergänzenden Zugriffsoptionen. A1 hat zwei Varianten: lokal gehostete quelloffene Modelle und extern gehostete Modelle über die Chat AI- und SAIA-Schicht.
A1.OS für lokal gehostete quelloffene Modelle; A1.EM für externe kommerzielle Modelle über die von GWDG kontrollierte Dienstschicht
A2 – direkter Microsoft Foundry-Endpunkt
Direkter kommerzieller Endpunkt für den Benutzer, das Projekt oder die Institution bereitgestellt
Responses-API
API-basierte Werkzeuge, die Responses-API-Unterstützung erfordern, insbesondere Agenten-Coding; nicht für sensible Daten empfohlen
A3 – Lizenzverwaltung (Anthropic Claude Enterprise)
Unternehmenslizenzen über GWDG beschafft
Native Anbieter-Zugriff
Native Anbieter-Anwendungen, einschließlich Desktop- oder Mobil-Apps
SAIA bietet OpenAI-kompatible v1-Endpunkte wie /v1/chat/completions. Es bietet die Responses-API nicht an. Werkzeuge, die die Responses-API benötigen, benötigen stattdessen A2-Zugang.
Aktuelle Modelle
Das aktuelle kommerzielle Portfolio umfasst folgende Modellfamilien:
OpenAI GPT-5.5
Anthropic Claude Sonnet 5
Anthropic Claude Opus 4.8
Anthropic Claude Fable 5
Für Modelle, die über Chat AI und SAIA verfügbar sind, einschließlich lokal gehosteter quelloffener Modelle und externer Modelle, siehe Verfügbare Modelle.
Anforderung des Zugriffs
A2 (Kommerzielle Modelle über Microsoft Foundry)
Um Zugang zu kommerziell gehosteten Modellen (A2: direkter Microsoft Foundry-Endpunkt) zu erhalten, buchen Sie den Kommerziellen Modelle-Dienst.
A3 (Anthropic Claude Enterprise-Lizenz)
Um eine Unternehmenslizenz für Anthropic Claude Enterprise (A3: direkter Anbieter-Zugriff) zu beantragen, buchen Sie den Claude Enterprise-Dienst.
Diese Option bietet direkten Zugriff auf Anthropic Claude Enterprise mit direkter Anbieter-Integration, einschließlich der Claude-Desktop- und -Mobil-Apps sowie Claude Code. Wir (das GWDG) übernehmen die Lizenzverwaltung, die zentrale Benutzerkontenverwaltung und die Abrechnung. Wir setzen auch eine personenbezogene Ausgabenobergrenze, die als technisch durchgesetzte, feste monatliche Budgetobergrenze wirkt. Die Abrechnung erfolgt nach Nutzung und kombiniert feste und variable Komponenten.
Um Zugang zu beantragen, senden Sie Ihre Anfrage über das Buchungsformular, wobei Sie Ihre Institution, die Benutzer-E-Mail-Adressen und die Nutzungsgrenze pro Person angeben. GWDG erstellt ein Angebot, Ihre Beschaffungsstelle stellt die Bestellung und zahlt für den ersten Zeitraum, während GWDG die Benutzerkonten erstellt und die Ausgabenobergrenzen festlegt.
Datenschutzprofil
Für A1.OS werden Anfragen mit lokal gehosteten quelloffenen Modellen in der GWDG-Infrastruktur verarbeitet. Für A1.EM werden Anfragen über die von GWDG kontrollierte Chat AI- und SAIA-Dienstschicht an externe Anbieter weitergeleitet. SAIA selbst bietet keine dauerhafte Speicherung von Anfrageinhalten über die Responses-API.
Für A2 werden Anfragen direkt an den Microsoft Foundry-Endpunkt gesendet. Die Responses-API kann Gesprächszustand serverseitig für eine begrenzte Zeit speichern. Die Responses-API-Antwortdaten werden standardmäßig 30 Tage lang aufbewahrt. Erweiterte Prompt-Cache-Aufbewahrung kann die aktiven Cache-Präfixe bis zu 24 Stunden aktiv halten. Siehe die Microsoft-Referenzen zu Conversation Storage in der Responses-API und Prompt-Caching. Aufgrund des Cloud Act kann nicht ausgeschlossen werden, dass die Hersteller die Daten nutzen oder verpflichtet sind, sie der US-Regierung zur Verfügung zu stellen. Dieser Zugriffsweg ist daher für Anwendungsfälle vorgesehen, bei denen dieser Kompromiss akzeptiert wird, z. B. agentenbasiertes Coding auf nicht-sensiblen Codebasen. GWDG hat ein Datenverarbeitungsabkommen (DPA) mit Microsoft, das besagt, dass Ihre Daten nicht für die Modellweiterbildung verwendet werden dürfen.
Für A3 hängt das Datenschutzprofil vollständig von der gewählten Anbieter-Lizenz und den Produktbedingungen des Anbieters (Anthropic Claude Enterprise) ab.
Warnung
GWDG hat kein Datenverarbeitungsabkommen (DPA) ähnlich dem A2-Angebot für das A3-Angebot.
Das bedeutet, im Gegensatz zu A2 enthält der Vertrag, den Anthropic anbietet, keine Bestimmung, die sie verpflichtet, Ihre Eingaben nicht für die Weiterbildung zukünftiger Modelle zu verwenden, noch verhindert er, dass Anthropic Ihre Daten für andere Zwecke speichert und verarbeitet.
Administration und Aktivierung für A1
Die Administration von A1 basiert auf dem GWDG Identity Management (IdM). Zugriffsrechte und Token-Grenzen werden über das IdM kontrolliert. Da das IdM mehrinstanzenfähig ist, können Institute ihre eigenen Benutzer, Gruppen und Quoten unabhängig verwalten.
Rollen
Benutzer verbrauchen ihre zugewiesenen Quoten und beantragen bei Bedarf Nachschüsse.
Benutzer können ihren eigenen Verbrauch überprüfen.
Benutzer können API-Schlüssel mit eigenen Untergrenzen über Selbstbedienung erstellen.
Institut-Administratoren setzen und passen Grenzen über das IdM an, überprüfen und genehmigen Nachschussanträge, weisen Verbrauch auf Kostenstellen zu und sehen den Verbrauch ihrer eigenen Tenant-Gruppe.
GWDG betreibt die Plattform.
Quoten und Budgetierung für A1
Benutzer erhalten eine Basisquote, die an eine Gruppe (z. B. eine Institution oder Arbeitsgruppe) in unserem zentralen Benutzer- und Identitätsmanagement-System gebunden werden kann. Die Quote ist nicht kostenlos – sie wird auf Instituts-Ebene beschafft und den Benutzern zur Verfügung gestellt. Die Granularität ist standardmäßig monatliche Budgets, aber andere Intervalle oder Einmal-Quoten können auf Antrag des Instituts konfiguriert werden.
Wenn ein Benutzer seine feste oder weiche Grenze erreicht, kann ein Institut-Administrator zusätzliche Quote ohne sofortige Auslösung eines formellen Nachschusses zuweisen. Begründungen für Über-Grenzen-Anträge können von Administratoren überprüft werden, um zu verfolgen, welche Anwendungsfälle die Nachfrage treiben.
Benutzer können mehrere API-Schlüssel erstellen. Jeder Schlüssel kann seine eigene Untergrenze bis zur zugewiesenen Quote tragen. Dies trennt Werkzeuge sauber – z. B. einen Schlüssel für ein Produktions-Skript und einen für ein Experiment – und schützt vor unkontrolliertem Verbrauch durch eine einzelne Anwendung. Es ermöglicht auch die Kostenabrechnung pro Projekt.
Delegation und Multi-Tenancy für A2
Das Multi-Tenancy-Design ermöglicht es Instituten, Ressourcen an Einzelpersonen oder Projekte weiterzugeben und bei Bedarf zusätzliche Ressourcen anzufordern – z. B. für ein bestimmtes Projekt. Nachschüsse können von autorisierten Administratoren durchgeführt werden.
Administration und Aktivierung für A2
Die Administration von A2 folgt demselben Modell wie A1, mit folgenden Unterschieden:
A2 verwendet weiche Grenzen, die z. B. eine E-Mail an den Benutzer bei 50 % oder 100 % Verbrauch auslösen. Der Grund ist, dass feste Kosten-Grenzen pro Anfrage nicht immer von den Anbietern verfügbar sind (siehe Quoten und Budgetierung).
Selbstbedienung zum Erstellen von API-Schlüsseln mit Untergrenzen ist für A2 noch nicht verfügbar; diese Funktion ist derzeit auf A1 beschränkt. Ein Web-Portal für Selbstbedienung ist geplant.
A2 ist standardmäßig nicht aktiviert, sondern wird für bestimmte Anwendungsfälle freigegeben, bei denen der Datenschutz-Kompromiss der Responses-API (siehe Datenschutzprofil) bewusst akzeptiert wird.
Administration und Aktivierung für A3 (Anthropic Claude Enterprise)
A3 folgt einem anderen Administrationsmodell, das sich auf die Unternehmenslizenzenverwaltung konzentriert:
Rollen
Der Antragsteller gibt die erforderlichen Informationen – die Institution, die Benutzer-E-Mail-Adressen und die Nutzungsgrenze pro Person – über das Buchungsformular ein. Die Beschaffungsstelle erhält das Angebot, stellt die Bestellung und übernimmt die Abrechnung. GWDG erstellt die Benutzerkonten, setzt die personenbezogenen Ausgabenobergrenzen, verwaltet die Aktivierung und sammelt und übermittelt Abrechnungsinformationen an die Beschaffungsstelle.
Ablauf
Die Anfrage wird über das Dienstbuchungsformular eingereicht. Danach erstellt GWDG ein Angebot, das die Dienstbeschreibung und die Bedingungen enthält. Die Beschaffungsstelle stellt die Bestellung und überweist die Gebühren für den ersten Abrechnungszeitraum. Sobald die Zahlung eingegangen ist, aktiviert GWDG den Dienst, indem es die Benutzerkonten erstellt und die Budgetgrenzen festlegt.
Zahlungsmodelle
Das Zahlungsmodell ist bewusst flexibel, um sowohl projektfinanzierte Nutzung als auch kleine Bedarfe abzudecken.
Für A1 und A2
Standardmäßig werden A1 und A2 nach Nutzung abgerechnet, wobei die Abrechnung auf verbrauchten API-Token basiert und die tatsächlichen Anbieterkosten direkt an die Nutzung anpasst. Institute oder Benutzer laden ein Konto auf, von dem der Verbrauch abgezogen wird, und sobald das Guthaben aufgebraucht ist, kann es erneut aufgeladen werden, was analog zum bekannten Druckguthaben-Modell an Universitäten funktioniert. Alternativ kann ein Budgetlimit als festes monatliches oder jährliches Budget festgelegt werden, was für Arbeitsgruppen mit regelmäßiger und stabiler Nutzung geeignet ist. Durch die Multi-Tenancy des IdM kann der Verbrauch auch auf Kostenstellen gebucht werden, einschließlich Arrangements, bei denen eine Institution den Verbrauch zuerst begleicht und intern abrechnet. Für Benutzer mit kleinen Budgets, insbesondere Studierende, ermöglichen Mikrozahlungen kleine Aufladungen nach Bedarf ohne administrativen Aufwand.
Für A3 (Anthropic Claude Enterprise)
A3 erfordert Vorauszahlung, da GWDG keine Finanzierung bereitstellen kann. Die Beschaffungsstelle muss die erwarteten Kosten vor der Aktivierung des Dienstes decken. Eine technisch durchgesetzte, personenbezogene monatliche Budgetobergrenze schützt vor überraschend hohen Rechnungen. Die Kosten ergeben sich aus der Kombination fester Sitzkosten mit nutzungsabhängigen Gebühren. Wenn Ihr Guthaben aufgebraucht ist, wenden Sie sich bitte an support@gwdg.de, um aufzuladen oder Ihre monatliche Zuteilung zu erhöhen.
Während des Onboardings erhalten Sie möglicherweise bereits verwendbare config.toml- und .env-Dateien von GWDG. Falls nicht, erstellen Sie die Dateien manuell mit der gleichen Struktur wie unten gezeigt.
Speichern Sie beide Dateien im Codex-Konfigurationsverzeichnis:
Windows: %USERPROFILE%\.codex\
macOS: ~/.codex/
Linux: ~/.codex/
Zielverzeichnisse:
Windows: %USERPROFILE%\.codex\config.toml und %USERPROFILE%\.codex\.env
macOS: ~/.codex/config.toml und ~/.codex/.env
Linux: ~/.codex/config.toml und ~/.codex/.env
Verwenden Sie die exakten Basis-URL, API-Schlüssel und Bereitstellungsname, die Sie von GWDG erhalten haben. Die Standardkonfiguration sollte auf Ihre bereitgestellte Azure-Bereitstellung verweisen.
model = "<ihr-gwdg-bereitstellungsname>"model_provider = "azure"approval_policy = "on-request"sandbox_mode = "workspace-write"[model_providers.azure]
name = "Azure"base_url = "https://<ihr-resource>.openai.azure.com/openai"wire_api = "responses"query_params = { api-version = "2025-04-01-preview" }
env_key = "AZURE_OPENAI_API_KEY"env_key_instructions = "Setzen Sie AZURE_OPENAI_API_KEY in ~/.codex/.env"
4. Beispiel .env
AZURE_OPENAI_API_KEY=<ihr-API-Schlüssel>
Ersetzen Sie die Platzhalter durch die Werte aus Ihrem GWDG-Onboarding.
5. Sandbox
Für lokale Arbeit wird die Einstellung workspace-write mit aktivierten Genehmigungen empfohlen. Codex verwendet lokale Sandbox-Steuerungen, um den Dateisystem- und Netzwerkzugriff zu beschränken.
KI-Modelle können Halluzinationen erzeugen und falsche Informationen generieren. Überprüfen Sie generierte Ergebnisse immer kritisch, bevor Sie sie verwenden oder verarbeiten.
Die Codex-CLI verwendet das .codex-Konfigurationsverzeichnis in Ihrem Heimatordner. Erstellen Sie config.toml und .env im folgenden Pfad:
Windows: %USERPROFILE%\.codex\
macOS: ~/.codex/
Linux: ~/.codex/
Zielverzeichnisse:
Windows: %USERPROFILE%\.codex\config.toml und %USERPROFILE%\.codex\.env
macOS: ~/.codex/config.toml und ~/.codex/.env
Linux: ~/.codex/config.toml und ~/.codex/.env
Verwenden Sie die exakten Basis-URL, API-Schlüssel und Bereitstellungsname, die Sie von GWDG erhalten haben.
3. Beispiel config.toml
model = "<ihr-gwdg-bereitstellungsname>"model_provider = "azure"approval_policy = "on-request"sandbox_mode = "workspace-write"[model_providers.azure]
name = "Azure"base_url = "https://<ihr-resource>.openai.azure.com/openai"wire_api = "responses"query_params = { api-version = "2025-04-01-preview" }
env_key = "AZURE_OPENAI_API_KEY"env_key_instructions = "Setzen Sie AZURE_OPENAI_API_KEY in ~/.codex/.env"
4. Beispiel .env
AZURE_OPENAI_API_KEY=<ihr-API-Schlüssel>
Ersetzen Sie die Platzhalter durch die Werte aus Ihrem GWDG-Onboarding.
5. CLI starten
Öffnen Sie ein Terminal in Ihrem Projektverzeichnis und führen Sie aus:
codex
Codex kann Ihr Repository untersuchen, Dateien bearbeiten und Befehle im aktuellen Verzeichnis ausführen. Wenn noch kein Anbieter konfiguriert ist, fordert Codex bei erster Ausführung zur Anmeldung auf. Für die GWDG-kommerzielle Einrichtung konfigurieren Sie zunächst den Azure-Anbieter und starten dann die CLI.
6. CLI aktualisieren
Um die Codex-CLI zu aktualisieren:
npm i -g @openai/codex@latest
7. Sandbox
Verwenden Sie workspace-write mit aktivierten Genehmigungen, es sei denn, Sie haben einen speziellen Grund, mehr zu erlauben.
KI-Modelle können Halluzinationen erzeugen und falsche Informationen generieren. Überprüfen Sie generierte Ergebnisse immer kritisch, bevor Sie sie verwenden oder verarbeiten.
Claude Code kann mit dem kommerziellen Modellangebot von GWDG über Microsoft Foundry genutzt werden.
Info
Claude Code kann auch auf die Modelle auf der HPC-Infrastruktur von GWDG mit nur einem SAIA-API-Schlüssel verweisen, ohne ein Anthropic-Konto oder einen kommerziellen Endpunkt zu benötigen. Für diese Einrichtung siehe CoCo AI – Claude Code.
Wählen Sie eine Einrichtung:
Was Sie für VS Code benötigen
einen kommerziellen Endpunkt oder Ressourcennamen und API-Schlüssel von support@gwdg.de
den Namen der Claude-Deployment, die standardmäßig verwendet werden soll
Visual Studio Code 1.98 oder neuer
die Claude Code-Erweiterung aus dem VS Code-Markt
Claude für Visual Studio Code
1. Installieren der VS Code-Erweiterung
Im VS Code-Markt installieren Sie Claude Code von Anthropic.
Während des Onboardings erhalten Sie möglicherweise eine vorbereitete settings.json von GWDG. Falls nicht, erstellen Sie die Datei manuell mit der gleichen Struktur wie unten gezeigt.
Speichern Sie sie unter:
Windows: %USERPROFILE%\.claude\settings.json
macOS: ~/.claude/settings.json
Linux: ~/.claude/settings.json
Die Datei wird in Ihrem Benutzerprofil gespeichert, sodass CLI und VS Code-Erweiterung die gleiche Claude-Konfiguration verwenden.
Die Datei konfiguriert die erforderlichen Foundry-Variablen:
CLAUDE_CODE_USE_FOUNDRY
ANTHROPIC_FOUNDRY_RESOURCE
ANTHROPIC_FOUNDRY_API_KEY
ANTHROPIC_MODEL
Wenn Bereitstellungen verfügbar sind, kann die Datei auch die Opus-, Sonnet- und Haiku-Bezeichnungen über folgende Variablen festlegen:
ANTHROPIC_DEFAULT_SONNET_MODEL
ANTHROPIC_DEFAULT_HAIKU_MODEL
ANTHROPIC_DEFAULT_OPUS_MODEL
Verwenden Sie die exakten Werte, die Sie von GWDG erhalten haben. Wenn Sie einen Ressourcennamen erhalten haben, verwenden Sie ANTHROPIC_FOUNDRY_RESOURCE. Wenn Sie stattdessen eine vollständige Basis-URL erhalten haben, verwenden Sie ANTHROPIC_FOUNDRY_BASE_URL.
Verwenden Sie Git Bash oder WSL2; PowerShell und cmd.exe sind nicht die empfohlenen Standardlaufzeiten für Claude Code
In VS Code setzen Sie Terminal > Integriert > Standardprofil: Windows auf Git Bash, wenn möglich
Oder führen Sie VS Code direkt innerhalb einer WSL-Sitzung aus
4. Claude Code in VS Code starten
Schließen Sie alle VS Code-Fenster vollständig und öffnen Sie VS Code erneut.
Öffnen Sie ein Projektverzeichnis.
Öffnen Sie die Claude-Leiste und starten Sie eine Sitzung.
Wenn Claude weiterhin nach einem Anthropic-Anmeldeaccount fragt, überprüfen Sie zunächst claudeCode.disableLoginPrompt und den Speicherort von ~/.claude/settings.json.
Falls erforderlich, aktivieren Sie Claude Code: Terminal verwenden und starten Sie Claude aus dem integrierten Terminal.
KI-Modelle können Halluzinationen erzeugen und falsche Informationen generieren. Überprüfen Sie generierte Ergebnisse immer kritisch, bevor Sie sie verwenden oder verarbeiten.
Fehlerbehebung
Wenn Claude Code mit Microsoft Foundry nicht korrekt startet, überprüfen Sie zunächst Folgendes:
claudeCode.disableLoginPrompt ist in VS Code aktiviert
~/.claude/settings.json befindet sich im richtigen Benutzerordner
der Foundry-Ressourcenname, API-Schlüssel und Bereitstellungsnamen sind korrekt
auf Windows verwendet VS Code Git Bash oder WSL anstelle von PowerShell oder cmd.exe
Öffnen Sie ein Terminal in Ihrem Projektverzeichnis und führen Sie aus:
claude
Claude Code startet dann eine interaktive Terminal-Sitzung mit Zugriff auf Ihre konfigurierte Foundry-Bereitstellung.
Nützliche Befehle:
claude
claude "erklären Sie dieses Repository"claude -c
5. Windows-Hinweise
Auf Windows ist Git Bash oder WSL2 die empfohlene Laufzeitumgebung für Claude Code. PowerShell und cmd.exe sind nicht die bevorzugten Standardumgebungen für den täglichen Gebrauch von Claude Code.
6. Berechtigungen und Sicherheit
Die Claude Code CLI fordert je nach gewähltem Berechtigungsmodus Genehmigungen an. Geben Sie nur die Berechtigungen für die aktuelle Aufgabe frei.
KI-Modelle können Halluzinationen erzeugen und falsche Informationen generieren. Überprüfen Sie generierte Ergebnisse immer kritisch, bevor Sie sie verwenden oder verarbeiten.
Fehlerbehebung
Wenn die CLI Microsoft Foundry nicht wie erwartet verwendet, überprüfen Sie zunächst Folgendes:
CLAUDE_CODE_USE_FOUNDRY ist auf 1 gesetzt
der Ressourcenname oder die Basis-URL ist korrekt
der API-Schlüssel ist gültig
der Bereitstellungsname in ANTHROPIC_MODEL existiert in Ihrer Foundry-Ressource
auf Windows führen Sie die CLI aus Git Bash oder WSL aus
OpenCode kann in der GWDG-Umgebung auf mehrere Weisen genutzt werden.
Derzeit sind folgende Einrichtungen möglich:
mit einem SAIA-API-Schlüssel für lokal gehostete Modelle
mit externen kommerziellen Schlüsseln für den Zugriff auf kommerzielle Modelle
Wenn Sie lokal gehostete Modelle benötigen, verwenden Sie SAIA. Wenn Sie Zugriff auf externe kommerzielle Modelle benötigen, verwenden Sie Ihre kommerziellen Zugangsdaten.
Erleben Sie die neueste Generation der Proteinfaltungsprognose mit unserem KI-gestützten Dienst. Mit Hochleistungsrechnen (HPC) und den Modellen AlphaFold2/Boltz bietet unsere Plattform schnelle, genaue und zuverlässige automatische Strukturvoraussagen für verschiedene Proteine. Durch die Integration von MMseqs2 erreicht der Dienst eine Leistung, die traditionellen Methoden ebenbürtig ist. Kostenlos über die KISSKI-Plattform zugänglich, eignet sich der Dienst für verschiedene Vorhersageaufgaben und macht die fortschrittliche Proteinfaltungsprognose für alle Forscher und Wissenschaftler verfügbar.
Hauptmerkmale von Protein AI
Geschwindigkeit: Verwendung von MMseqs2 für schnelle Erzeugung von Mehrfachsequenzalignment (MSA)
Genauigkeit: Genauige Strukturvoraussage für einzelne Proteinsequenzen
Die vorhergesagte Struktur wird im Ergebnisfeld angezeigt und zum Herunterladen bereitgestellt.
Dieser Dienst wird die Forschung in der Strukturbiologie revolutionieren und die Proteinfaltungsprognose für Forscher aus verschiedenen Fachgebieten zugänglicher und effizienter machen.
Datenschutz und Flexibilität gewährleisten
Sicherheit ist entscheidend, wenn mit potenziell sensiblen biologischen Daten gearbeitet wird, da sie Zuverlässigkeit bietet, bei Audits oder regulatorischen Inspektionen nachweist und die Integrität der Forschung sichert. Der Datenschutz der Nutzer ist ein zentrales Prinzip dieses Dienstes. Wir protokollieren die Anzahl der Anfragen pro Benutzer sowie die zugehörigen Zeitstempel und die vorhergesagten Ergebnisse, die nach 30 Tagen automatisch gelöscht werden. Wir speichern keine Benutzereingaben, Chatverläufe oder Beschreibungen.
Web-Oberfläche und Nutzung
Wenn Sie ein Academic Cloud-Konto besitzen, kann die Web-Oberfläche von Protein AI einfach hier erreicht werden.
Aus der Web-Oberfläche heraus gibt es integrierte Aktionen, die ausgefüllt werden müssen, damit der Dienst funktionstüchtig ist. Dazu gehören:
Einzelprotein-Strukturvoraussage
Sequenz eingeben: Fügen Sie Ihre Proteinsequenz im FASTA-Format ein.
Ausführen: Klicken Sie, um den Vorhersageprozess zu starten.
Ergebnisse herunterladen: Laden Sie die Ausgabedateien herunter.
Ergebnisse anzeigen: Zeigen Sie die vorhergesagte Struktur an.
Hell/Dunkelmodus (Sonne/Mond-Button): Wechseln Sie zwischen hellen und dunklen Modus.
Fußzeile: Enthält „Datenschutzerklärung“, „Nutzungsbedingungen“, „FAQ“, Kontakt und die Möglichkeit, zwischen Deutsch und Englisch zu wechseln.
Unterabschnitte von Protein AI
Protein-KI FAQ
Datenschutz
Werden meine Proteinsequenzen oder Nutzungsdaten für die KI-Weiterbildung oder ähnliche Zwecke verwendet?
Nein, Ihre Proteinsequenzen und Vorhersagedaten werden nicht zur Weiterbildung von KI-Modellen verwendet.
Werden meine Sequenzen und vorhergesagten Strukturen zu irgendeinem Zeitpunkt auf Ihren Servern gespeichert?
Benutzersequenzen und vorhergesagte Strukturen werden temporär (für 30 Tage) auf dem GWDG-Server gespeichert. In dieser Zeit hat nur der jeweilige Benutzer Zugriff auf seine Daten. Wir greifen zu keinem Zeitpunkt ohne Zustimmung des Benutzers auf diese Daten auf unseren Servern zu.
Welche Daten speichert Protein-KI, wenn ich den Dienst nutze?
Wir speichern Proteinsequenzen und vorhergesagte Strukturen für 30 Tage auf unserem GWDG-Server. Wir erfassen einige Nutzungsstatistiken, um die Auslastung unseres Dienstes zu überwachen und die Benutzererfahrung zu verbessern. Dazu gehören Benutzernamen, Zeitstempel und die angeforderten Dienste.
Verfügbarkeit
Meine Institution ist an der Nutzung von Protein-KI interessiert. Können wir es für unsere Nutzer bewerben? Könnten Sie eine zusätzliche Last für XXX Nutzer bewältigen?
Für große Institutionen kontaktieren Sie uns bitte direkt unter info@kisski.de.
Sind die Protein-KI-Dienste kostenlos?
Protein-KI-Dienste, die mit einem Academic Cloud-Konto zugänglich sind, sind kostenlos.
Voice AI
Eines der herausragenden Angebote von KISSKI ist sein KI-basiertes Transkriptions- und Untertitelungsdienst, Voice AI. Mit Hochleistungsrechnen (HPC) nutzt Voice AI das Whisper-Modell (large-v2), um Audio schnell zu transkribieren und Videountertitel zu generieren. Auf 680.000 Stunden beschrifteten Daten trainiert, erreicht Whisper die Leistung professioneller menschlicher Transkribenten und bietet zuverlässige automatische Spracherkennung (ASR) und Sprachübersetzung über verschiedene Datensätze und Bereiche hinweg. Benutzer können zwischen Aufgaben wie Transkription und Übersetzung wählen, um ihre Bedürfnisse zu erfüllen. Besonders bemerkenswert ist, dass dieser KISSKI-Dienst kostenlos zur Verfügung steht.
Tipp
Sie benötigen ein Academic Cloud-Konto, um auf die KI-Dienste zugreifen zu können. Verwenden Sie die federierte Anmeldung oder erstellen Sie ein neues Konto. Details finden Sie auf dieser Seite.
Dienstkomponenten
Dieser Dienst besteht aus zwei Hauptteilen:
Verarbeitung hochgeladener Audio-Dateien: Verarbeitet Audio-Dateien, die von Nutzern hochgeladen wurden (<500 MB).
Verarbeitung von Streaming-Audio: Erfasst und verarbeitet Streaming-Audio aus dem Browser (dieser Teil wird in Zukunft verfügbar sein).
Audio-Datei-Transkriptions-/Übersetzungs-Dienst
Wenn Sie ein Academic Cloud-Konto besitzen, kann die Web-Oberfläche auch einfach hier erreicht werden.
Die Plattform bietet intuitive, integrierte Funktionen, die für eine nahtlose Audioverarbeitung konzipiert sind:
Eingabesprache: Wählen Sie die Sprache des hochgeladenen Audios für die Transkription.
Textformat: Wählen Sie das Ausgabeformat, das Text, SRT oder VTT sein kann.
Sprecher-Diariisierung: Aktivieren Sie die WhisperX-Diariisierung, um Sprecher in der Transkription zu identifizieren und zu kennzeichnen.
Datei auswählen: Laden Sie Ihre Audio-Datei hoch, die im Format wav, mp3 oder mp4 vorliegen kann.
KI-generierte Zusammenfassung: Bietet eine präzise Zusammenfassung Ihrer Transkription oder Übersetzung mithilfe von Chat AI. Die Ausgabe wird ausschließlich im IndexedDB des Benutzers gespeichert.
Ausgabe löschen: Löschen Sie die Transkriptionsergebnisse sofort und dauerhaft.
Hell/Dunkelmodus (Sonne/Mond-Button): Wechseln Sie zwischen hellen und dunklen Modus.
Fußzeile: Enthält „Datenschutzerklärung“, „Nutzungsbedingungen“, „FAQ“, Kontakt und die Möglichkeit, zwischen Deutsch und Englisch zu wechseln.
Kernfunktionen
Transkription von englischsprachigem Audio mit angehängten Zeitstempeln (abhängig vom gewählten Ausgabeformat).
Transkription von nicht-englischsprachigem Audio, unterstützt mehrere Sprachen, einschließlich Deutsch.
Übersetzung von Audio aus verschiedenen Sprachen ins Englische.
Sprecher-Diariisierung mit WhisperX.
Zusammenfassung.
So nutzen Sie den Dienst
Wählen Sie die Eingabesprache des Audios.
Wählen Sie das Ausgabeformat (Normaler Text/SRT/VTT).
Aktivieren Sie die Diariisierung, falls Sie Sprecherbezeichnungen wünschen.
Laden Sie Audio-Dateien in verschiedenen Formaten wie mp3, mp4, flac oder wav hoch.
Wählen Sie zwischen Transkription oder Übersetzung.
Die Ausgabe kann heruntergeladen werden, sobald die Transkription abgeschlossen ist.
Eine Zusammenfassung der Transkription/Übersetzung kann auf Anfrage erstellt werden.
Streaming-Audio-Transkriptions-Dienst (Beta)
Dieser browserbasierte Tool bietet Echtzeit-Transkription oder Übersetzung ins Englische während Meetings und Vorlesungen, was Klarheit, Zugänglichkeit und Engagement erhöht – besonders in lauten oder mehrsprachigen Umgebungen. Er unterstützt gehörlose und schwerhörige Teilnehmer, Sprachlernende sowie alle, die bessere Notizen oder eine bessere Inhaltsüberprüfung benötigen. Keine Installation erforderlich, funktioniert in jedem Browser. Transkriptionen und Zusammenfassungen werden in einer gemeinsamen Etherpad Lite-URL gespeichert, die beim Sitzungsbeginn generiert wird, was gemeinsame Bearbeitung und Überprüfung ermöglicht. Etherpad Lite ist ein Open-Source-Editor, der mehreren Nutzern erlaubt, gleichzeitig am selben Dokument zu arbeiten, wodurch die Kommunikation inklusiver und effizienter wird.
(Zukünftiger Dienst)
Intuitive, integrierte Funktionen umfassen:
Sitzung starten: Beginnt die Transkription und generiert eine Pad-URL.
Sitzung beenden: Beendet die aktuelle Sitzung.
Modus: Wählen Sie zwischen Transkription oder Übersetzung ins Englische.
Gesprochene Sprache: Standardmäßig automatische Erkennung, oder manuelle Auswahl einer Sprache.
Untertitel-Overlay: Öffnet ein abgetrenntes Fenster, um Untertitel über jede Webseite zu zeigen.
Finalisieren & Zusammenfassen: Generiert eine Zusammenfassung direkt im Pad.
Hell/Dunkelmodus: Wechseln Sie zwischen hellen und dunklen Themen (Sonne/Mond-Symbol).
Fußzeile: Enthält Links zu Datenschutzerklärung, Nutzungsbedingungen, Impressum, FAQ, Hilfe, Kontakt und Sprachwechsel (Englisch/Deutsch).
Datenschutz und Flexibilität gewährleisten
Wir legen Wert auf Sicherheit, um Zuverlässigkeit, regulatorische Compliance und Geschäftskontinuität zu gewährleisten. Der Datenschutz der Nutzer steht im Mittelpunkt unserer Gestaltung. Audio- und Gesprächseingaben werden unmittelbar nach der Transkription oder Übersetzung gelöscht.
Ausnahmen:
Transkriptions-Ergebnisse: Auf unserem Datenübertragungs-Knoten gespeichert, nach 30 Tagen gelöscht. Voice AI Ausgaben können auch über eine spezielle Löschschaltfläche sofort und dauerhaft gelöscht werden.
Live-Transkriptions-Ergebnisse (zukünftige Funktion): In MySQL gespeichert, automatisch nach 24 Stunden gelöscht.
Nutzungsaufzeichnung: Wir protokollieren Anzahl der Anfragen und Zeitstempel pro Benutzer für Systemüberwachung und Abrechnung.
Anerkennung
Jakob Hördt für die Entwicklung des Proxys. Marcel Hellkamp für die Entwicklung des BBB-Audio-Untertitelungs-Codes. Ali Doost Hosseini für den Kong-Gateway. Johannes Biermann für technische Unterstützung.
Autor
Narges Lux
Weitere Dienste
Falls Sie Fragen haben, lesen Sie zunächst die FAQ. Falls Sie spezifischere Fragen haben, kontaktieren Sie uns gerne unter support@gwdg.de.
Unterabschnitte von Voice AI
Voice AI FAQ
Wie nutze ich den Voice-live-Tool effektiv?
Für maximale Genauigkeit: Wählen Sie Ihre Eingabesprache aus! Obwohl die automatische Erkennungsfunktion leistungsstark ist, erreicht das Transkriptionsmodell die höchste Genauigkeit und Geschwindigkeit, wenn Sie die gesprochene Sprache vorab angeben. Wenn Sie wissen, welche Sprache gesprochen wird, wird dringend empfohlen, sie aus der Dropdown-Liste auszuwählen.
Wie erfolgt die Transkription/Übersetzung in einem Online-Meeting oder allgemein aus dem System-Audio?
Aus Sicherheits- und Datenschutzgründen können Web-Browser Ihre Computer-Lautsprecher-Ausgabe nicht direkt „hören“. Um ein Meeting (z. B. von Zoom, Teams usw.) oder jedes andere Audio, das auf Ihrem Computer abgespielt wird, zu transkribieren, müssen Sie ein virtuelles Audio-Kabel verwenden. Diese kostenlose Software erstellt ein virtuelles „Loopback“-Gerät, das Ihren Lautsprecher-Audio an ein virtuelles Mikrofon weiterleitet, das Sie dann in dieser Web-Anwendung auswählen können.
Einrichtungsanleitung:
Windows: Laden Sie und installieren Sie VB-CABLE. Stellen Sie in den Audio-Einstellungen Ihrer Meeting-App den Lautsprecher auf „CABLE Input“. Wählen Sie in diesem Browserfenster „CABLE Output“ als Mikrofon.
macOS: Laden Sie und installieren Sie BlackHole. Erstellen Sie in „Audio MIDI Setup“ ein „Multi-Output Device“, das sowohl Ihre normalen Lautsprecher als auch BlackHole enthält. Legen Sie dies als Standard-Ausgabe Ihres Systems fest. Verwenden Sie in Ihrer Meeting-App die Standard-Ausgabe. Wählen Sie in diesem Browserfenster BlackHole als Mikrofon.
Linux: Sie können das PulseAudio Loopback-Modul verwenden. Laden Sie es mit dem Befehl: pactl load-module module-loopback. Verwenden Sie ein Werkzeug wie pavucontrol, um den Audio-Stream aus der Meeting-Anwendung auf die Eingabe Ihres Browsers umzuleiten.
Datenschutz
Werden meine Gespräche oder Nutzungsdaten für die KI-Weiterbildung oder ähnliche Zwecke verwendet?
Nein, Ihre Gespräche und Daten werden nicht zur Weiterbildung von KI-Modellen verwendet.
Werden meine Audio-Dateien und Gespräche zu irgendeinem Zeitpunkt auf Ihren Servern gespeichert?
Nein, Benutzer-Audio-Dateien oder BBB-Gespräche werden zu keinem Zeitpunkt auf unseren Servern gespeichert. Sobald Ihr Audio gesendet und die Antwort erhalten wurde, ist das Ergebnis nur noch in Ihrem Browser verfügbar. Die Transkriptions-/Übersetzungs-Ergebnisse werden auf unserem Datenübertragungs-Knoten gespeichert und nach 30 Tagen gelöscht. Dies gibt den Nutzern die Möglichkeit, ihre Ergebnisse innerhalb von 30 Tagen herunterzuladen. BBB-Transkriptionen, die in Etherpad geschrieben und mit lokalem MySQL gespeichert werden, werden ebenfalls nach 30 Tagen gelöscht (zukünftiger Dienst).
Welche Daten speichert Voice AI, wenn ich den Dienst nutze?
Wir speichern keine Gespräche oder Audio-Dateien auf unseren Servern. Transkriptions-/Übersetzungs-Ergebnisse werden für 30 Tage auf unserem Datenübertragungs-Knoten gespeichert. BBB-Transkriptionen, die in lokalem MySQL gespeichert werden, werden ebenfalls nach 30 Tagen gelöscht (zukünftiger Dienst). Außerdem erfassen wir einige Nutzungsstatistiken, um die Auslastung unseres Dienstes zu überwachen und die Benutzererfahrung zu verbessern. Dazu gehören Benutzernamen, Zeitstempel und die angeforderten Dienste.
Konvertierung größerer Audio-Dateien in FLAC-Format
Wenn Ihre Datei zu groß ist, können Sie Tools wie FFmpeg oder Audacity verwenden, um sie in das FLAC-Format zu konvertieren, das ein verlustfreies Format ist. Zum Beispiel mit FFmpeg:
ffmpeg -i input.wav -vn -acodec flac output.flac
Verfügbarkeit
Meine Institution ist an der Nutzung von Voice AI interessiert. Können wir es für unsere Nutzer bewerben? Könnten Sie eine zusätzliche Last für XXX Nutzer bewältigen?
Für große Institutionen kontaktieren Sie uns bitte direkt unter info@kisski.de.
Ist der Voice AI Dienst kostenlos?
Der Voice AI Dienst, der mit einem Academic Cloud-Konto zugänglich ist, ist kostenlos.
KI-Schulungen
Die regulären KI-Schulungen werden über die GWDG Academy und KISSKI angeboten.
In unserer HPC-Dokumentation finden Sie zusätzliche Informationen zu den einzelnen Kursen, die wir hier auch bald verfügbar machen.
Grundlagen Wissen
Info
Auf diesen Seiten werden wir grundlegende Konzepte der KI Dienste und der Umsetzung dieser Konzept innerhalb unserer Infrastruktur erläutern.
Ein Token ist die kleinste Einheit, die ein Sprachmodell verarbeiten kann. Es ist nicht einfach ein einzelnes Wort, sondern ein Teil eines Wortes, ein Satzzeichen, ein Leerzeichen oder eine Kombination aus diesen Elementen. Tokens sind die Bausteine, aus denen der gesamte Text in einer Anfrage für ein KI-Modell zerlegt wird.
Wie werden Tokens erzeugt?
Die Umwandlung von Text in Tokens erfolgt durch ein Verfahren namens Tokenisierung. Dieser Prozess teilt den Eingabetext in kleinere Einheiten auf, die das Modell effizient verarbeiten kann. Die Art und Weise, wie ein Text in Tokens zerlegt wird, hängt von der spezifischen Architektur des Modells ab.
Beispiel:
Der Satz „Das ist ein Beispiel.“ wird möglicherweise in folgende Tokens zerlegt:
Das
ist
ein
Beispiel
.
Ein anderes Modell könnte den Satz anders aufteilen, z. B.:
Das
ist
ein
Bei
spiel
.
Hier wird „Beispiel“ in zwei Teile aufgeteilt, da diese Kombination nicht im Wörterbuch des Models vorkommt.
Warum sind Tokens wichtig?
Tokens sind entscheidend für die Leistung und Kosten von KI-Diensten:
Kostenberechnung: Die meisten KI-Dienste berechnen ihre Nutzung tokengenau. Das bedeutet, dass sowohl die Eingabe (Input-Tokens) als auch die Ausgabe (Output-Tokens) gezählt und abgerechnet werden. Je mehr Tokens eine Anfrage enthält, desto höher sind die Kosten.
Kontextfenster: Jedes Modell hat eine begrenzte Kapazität für gleichzeitig verarbeitbare Tokens, auch bekannt als Kontextfenster. Wenn eine Anfrage zu lang ist, kann das Modell sie nicht verarbeiten, da sie das Kontextfenster überschreitet. Dies ist besonders relevant bei komplexen Aufgaben wie der Analyse langer Dokumente.
Leistung: Die Anzahl der Tokens beeinflusst auch die Geschwindigkeit der Antwort. Je mehr Tokens verarbeitet werden müssen, desto länger dauert die Antwortgenerierung.
Fazit
Tokens sind die Grundlage der Kommunikation zwischen Ihnen und dem KI-Modell. Ein gutes Verständnis von Tokens hilft Ihnen, Ihre Anfragen effizienter zu gestalten, unnötige Kosten zu vermeiden und sicherzustellen, dass Ihre Anfragen innerhalb der technischen Grenzen des Modells bleiben.
Request
Wie eine Anfrage geprüft wird
Jede Anfrage durchläuft drei Schleusen, bevor sie ein Modell erreicht: den API-Schlüssel, mit dem sie erstellt wurde, das Benutzerkonto, zu dem dieser Schlüssel gehört, und die Organisation, zu der dieses Konto gehört. Jede Schleuse verfügt über eigene Limits, unterteilt in die zwei oben genannten Arten: eine Anfragerate, gezählt in Anfragen, und ein Budget, gezählt in Euro. Die Anfrage wird gegen jedes Limit gemessen, das auf dieser Ebene gesetzt ist, und sie wird abgelehnt, sobald eines davon überschritten wird, ohne dass die späteren Schleusen konsultiert werden. Erst wenn alle drei Schleusen passiert sind, erreicht die Anfrage ein Modell, und ihre Kosten werden dann gleichzeitig auf die Budgets aller drei Ebenen zurückgebucht.
Die Herkunft der Limits jeder Schleuse unterscheidet sich. Ein API-Schlüssel und eine Organisation unterliegen nur den Limits, die direkt auf sie gesetzt wurden. Wenn also keines gesetzt ist, lässt diese Schleuse die Anfrage einfach durch. Ihr Benutzerkonto ist die einzige Schleuse, die immer ein Limit hat: Ihr eigenes, falls Sie eines haben, andernfalls den Standardwert Ihrer Organisation für ihre Mitglieder, andernfalls den Plattform-Standardwert.
Eine Ebene ohne gesetztes Limit fügt einfach keine Einschränkung hinzu; sie befreit Sie nicht von den Ebenen danach. Was Sie tatsächlich tun können, wird durch das kleinste der drei Limits bestimmt, sodass ein Limit auf Ihrem API-Schlüssel Sie nur weiter einschränken kann. Es kann Ihnen niemals mehr gewähren, als Ihr Konto oder Ihre Organisation erlaubt.
Von Chat AI aus gilt die erste Box nicht: Es ist kein API-Schlüssel beteiligt, sodass die Anfrage bei Ihrem Benutzerkonto beginnt.
Anfrage-Rate-Limits werden über alle drei Ebenen hinweg evaluiert, bevor Budgets geprüft werden, sodass ein Aufrufer, dessen Budget erschöpft ist, weiterhin gedrosselt wird und nicht frei wiederholen kann.
Bei einer Ablehnung gibt der Header x-ratelimit-scope an, welche der drei Sie gestoppt hat.
Open-Weight-Modelle
Was sind Open-Weight-Modelle?
Open-Weight-Modelle sind große Sprachmodelle, deren Trainingsgewichte („Weights“) öffentlich zugänglich sind. Anders als kommerzielle Modelle, die von Unternehmen wie OpenAI oder Anthropic geschützt und nur über eine API zugänglich sind, können Open-Weight-Modelle von jedem frei heruntergeladen, lokal installiert und genutzt werden.
Wie unterscheiden sich Open-Weight-Modelle von kommerziellen Modellen?
Merkmal
Open-Weight-Modelle
Kommerzielle Modelle (z.B. GPT-4, Claude Opus)
Lokale Nutzung
Ja - können auf eigenen Servern oder Rechnern laufen
Nein - nur über Cloud-Endpunkte
Anpassung
Ja - können für spezifische Aufgaben finegetuned werden
Nein - nur über Prompt-Engineering
Transparenz
Hohe Transparenz: Quellcode und Gewichte sind öffentlich
Geringe Transparenz: Nur die API ist verfügbar
Datenschutz
Hoher Datenschutz: Daten bleiben lokal
Daten werden an externe Anbieter gesendet
Warum sind Open-Weight-Modelle wichtig?
Datenschutz und Kontrolle Da die Modelle lokal laufen, bleiben Ihre Daten auf eigenen Systemen. Keine Daten werden an Dritte übermittelt - ideal für sensible Forschungsdaten oder vertrauliche Unternehmensinformationen.
Kostenersparnis Open-Weight-Modelle sind in der Regel kostengünstiger. Durch kluge Auswahl der Modelle für einzelne Arbeitsprozesse lassen sich Kosten minimieren.
Anpassungsfähigkeit Die Modelle können auf spezifischen Anforderungen angepassen werden - z.B. durch Fine-Tuning mit eigenen Daten, um bessere Ergebnisse in spezifischen Fachgebieten und für spezifische Aufgaben zu erzielen.
Transparenz und Forschung Forscher können die Modelle analysieren, testen und weiterentwickeln. Dies fördert die wissenschaftliche Transparenz und Innovation.
Beispiele für Open-Weight-Modelle
Qwen3 (Alibaba Cloud) - stark in Code und Multimodalität
Devstral 2 (Mistral) - besonders gut für agente Aufgaben und Code
GLM 4.7 (Z.ai) - stark in Code und Tool-Use
Fazit
Open-Weight-Modelle sind eine leistungsstarke, transparente und datensichere Alternative zu kommerziellen KI-Modellen. Sie ermöglichen eine selbstbestimmte, kostengünstige und anpassbare Nutzung von KI - ideal für Forschung, Entwicklung und sensible Anwendungen.
Wenn Sie mehr über die verfügbaren Open-Weight-Modelle erfahren möchten, besuchen Sie die Modellübersicht.
Technische Dokumentation
Info
In Kürze finden Sie an dieser Stelle die Technische Dokumentation unserer KI-Dienste.
Sie wird Hintergrundinformationen und Beschreibungen der technischen Infrastruktur enthalten, die über die Inhalte der Benutzerdokumentation hinausgehen.
Aktuell finden Sie hier insbesondere die Dokumentation der SAIA Plattform. Im Rahmen der Überarbeitung dieser Dokumentation, werden wir bei der Zuordnung der Inhalte diverse Änderungen vornehmen.
SAIA ist der skalierbare KI-Accelerator (AI), der unsere KI-Dienste hostet. Zu diesen Diensten gehören Chat AI und CoCo AI, weitere werden in Kürze hinzukommen. API-Schlüssel für die SAIA-API (Application Programming Interface) können beantragt und innerhalb Ihres Codes zur Nutzung der Dienste verwendet werden.
API-Schlüssel sind nicht erforderlich, um die Web-Oberfläche von Chat AI zu nutzen Web-Oberfläche.
Die SAIA-API eignet sich für interaktive Inferenz-Szenarien. Falls Sie eine große Anzahl (z. B. Tausende von LLM-Anfragen) asynchron verarbeiten können, ist das Batch-Verfahren unseres HPC-Clusters die bessere Wahl. Ihre Batch-Aufgabe wird zuverlässiger, schneller und kostengünstiger abgeschlossen. Informieren Sie sich über die Einrichtung Ihres HPC-Clusters und die Nutzung von LLMs, um zu erfahren, wie Sie eine Batch-Inferenz-Aufgabe auf dem Cluster einrichten können. vLLM ist eine weitere beliebte Wahl für LLM-Inferenz.
API-Antrag
Wenn ein Benutzer über einen API-Schlüssel verfügt, kann er die verfügbaren Modelle direkt in seiner Terminal- oder Python-Umgebung nutzen. Um Zugang zu einem API-Schlüssel zu erhalten, besuchen Sie die KISSKI LLM-Service-Seite und klicken Sie auf „Buchen“. Dort finden Sie ein Formular, in dem Sie Ihre Anmeldeinformationen und Ihre Absichten bezüglich des API-Schlüssels angeben können. Bitte verwenden Sie dieselbe E-Mail-Adresse, die Ihrem Academic Cloud-Konto zugeordnet ist. Sobald Sie den Schlüssel erhalten haben, teilen Sie ihn nicht mit anderen Benutzern!
API-Nutzung
Der API-Service ist kompatibel mit dem OpenAI API-Standard. Wir bieten die folgenden Endpunkte:
/chat/completions
/completions
/embeddings
/models
/documents
Minimalbeispiel für die API
Sie können Ihren API-Schlüssel verwenden, um direkt über die Terminal-Eingabeaufforderung auf Chat AI zuzugreifen. Im Folgenden finden Sie ein Beispiel zur Text-Vervollständigung über die API.
curl -i -X POST \
--url https://chat-ai.academiccloud.de/v1/chat/completions \
--header 'Accept: application/json'\
--header 'Authorization: Bearer <api_key>'\
--header 'Content-Type: application/json'\
--data '{
"model": "meta-llama-3.1-8b-instruct",
"messages":[{"role":"system","content":"You are an assistant."},{"role":"user","content":"What is the weather today?"}],
"max_tokens": 7,
"temperature": 0.5,
"top_p": 0.5
}'
Ersetzen Sie <api_key> durch Ihren eigenen API-Schlüssel.
Modellnamen für die API
Weitere Informationen zu den jeweiligen Modellen finden Sie in der Modellliste.
Modellname
Funktionen
apertus-70b-instruct-2509
Text
devstral-2-123b-instruct-2512
Codierung
deepseek-v4-flash-0731
Text
gemma-4-31b-it
Text, Bild
glm-5.3-flash
Text, Bild
glm-4.7
Text
meta-llama-3.1-8b-instruct
Text
mistral-medium-3.5-128b
Text, Bild
openai-gpt-oss-120b
Text
qwen3.5-122b-a10b
Text, Bild
qwen3.5-397b-a17b
Text, Bild
qwen3.6-35b-a3b
Text, Bild
qwen3.8-27b
Text, Bild
qwen3-30b-a3b-instruct-2507
Text
qwen3-coder-next
Text, Code
qwen3-omni-30b-a3b-instruct
Text, Omni
e5-mistral-7b-instruct
Embeddings
multilingual-e5-large-instruct
Embeddings
qwen3-embedding-4b
Embeddings
Eine vollständige, aktuelle Liste der verfügbaren Modelle können Sie mit dem folgenden Befehl abrufen:
Die OpenAI (externen) Modelle sind nicht allgemein für die API-Nutzung verfügbar. Für eine detailliertere Konfiguration Ihrer Anfragen, z. B. die Einstellung von frequency_penalty, seed, max_tokens usw., verweisen wir auf die OpenAI-API-Referenzseite.
Chat
Es ist möglich, eine gesamte Unterhaltung in Ihre Anfrage einzubinden. Diese Unterhaltung kann aus einer vorherigen Sitzung mit demselben Modell oder einem anderen stammen, oder zwischen Ihnen und einem Freund/Kollegen, falls Sie weitere Fragen stellen möchten (stellen Sie sicher, dass Sie Ihre System-Nachricht entsprechend anpassen, z. B. „Du bist ein Freund/Kollege, der etwas erklären möchte, das verwirrend war“).
curl -i -N -X POST \
--url https://chat-ai.academiccloud.de/v1/chat/completions \
--header 'Accept: application/json'\
--header 'Authorization: Bearer <api_key>'\
--header 'Content-Type: application/json'\
--data '{
"model": "meta-llama-3.1-8b-instruct",
"messages": [{"role":"system","content":"You are a helpful assistant"},{"role":"user","content":"How tall is the Eiffel tower?"},{"role":"assistant","content":"The Eiffel Tower stands at a height of 324 meters (1,063 feet) above ground level. However, if you include the radio antenna on top, the total height is 330 meters (1,083 feet)."},{"role":"user","content":"Are there restaurants?"}],
"temperature": 0
}'
Für eine einfachere Nutzung können Sie die Chat AI-Modelle auch über die Ausführung einer Python-Datei nutzen. Fügen Sie dazu den folgenden Code in eine Datei ein:
from openai import OpenAI
# API-Konfigurationapi_key ='<api_key>'# Ersetzen Sie dies durch Ihren API-Schlüsselbase_url ="https://chat-ai.academiccloud.de/v1"model ="meta-llama-3.1-8b-instruct"# Wählen Sie ein verfügbares Modell# Starten des OpenAI-Clientsclient = OpenAI(
api_key=api_key,
base_url=base_url
)
# Abrufen der Antwortchat_completion = client.chat.completions.create(
messages=[
{"role": "system", "content": "You are a helpful assistant"},
{"role": "user", "content": "How tall is the Eiffel tower?"},
{"role": "assistant", "content": "The Eiffel Tower stands at a height of 324 meters (1,063 feet) above ground level. However, if you include the radio antenna on top, the total height is 330 meters (1,083 feet)."},
{"role": "user", "content": "Are there restaurants?"}
],
model=model,
)
# Vollständige Antwort als JSON ausgebenprint(chat_completion) # Sie können den Antworttext aus dem JSON-Objekt extrahieren
In bestimmten Fällen kann das Modell eine lange Antwort generieren, die mit der oben genannten Methode lange dauern kann, da die gesamte Antwort zunächst generiert und dann auf dem Bildschirm ausgegeben wird. Stattdessen können Sie Streaming verwenden, um die Antwort bereits während der Generierung zu erhalten.
from openai import OpenAI
# API-Konfigurationapi_key ='<api_key>'# Ersetzen Sie dies durch Ihren API-Schlüsselbase_url ="https://chat-ai.academiccloud.de/v1"model ="meta-llama-3.1-8b-instruct"# Wählen Sie ein verfügbares Modell# Starten des OpenAI-Clientsclient = OpenAI(
api_key=api_key,
base_url=base_url
)
# Stream startenstream = client.chat.completions.create(
messages=[
{
"role": "user",
"content": "Name the capital city of each country on earth, and describe its main attraction",
}
],
model=model,
stream=True)
# Antwort ausgebenfor chunk in stream:
print(chunk.choices[0].delta.content or"", end="")
Für bestimmte Reasoning-Modelle ist es möglich, über die API explizit das Reasoning zu aktivieren oder zu deaktivieren, was in der Modell-Dokumentation oft beschrieben ist. Zum Beispiel finden Sie die Dokumentation zur Aktivierung oder Deaktivierung des Reasoning für Qwen 3.6 35B A3B hier.
Wenn Sie Visual Studio Code oder Jetbrains als IDE verwenden, ist die empfohlene Methode, um die Nutzung Ihres API-Schlüssels zu maximieren, insbesondere für Code-Vervollständigung, die Installation des Continue-Plugins und die entsprechende Konfiguration. Weitere Details finden Sie unter CoCo AI.
Azure API
Einige unserer Kunden kommen möglicherweise mit der Azure OpenAI API in Kontakt. Diese API ist mit der OpenAI-API kompatibel, mit geringfügigen Unterschieden in den JSON-Antworten und der Endpunkt-Verarbeitung. Der offizielle OpenAI Python-Client bietet einen AzureOpenAI-Client, um diese Unterschiede zu berücksichtigen. In SAIA, da die externen, nicht-open-weight-Modelle von Microsoft Azure stammen, haben wir eine Übersetzungsschicht erstellt, um die OpenAI-Kompatibilität der Azure-Modelle sicherzustellen.
Bekannte Unterschiede:
Hinzufügen von content_filter_results in den Antworten von Azure-Modellen.
Bild
Die API-Spezifikation ist kompatibel mit der OpenAI Image API. Allerdings wird das Abrufen von Bildern aus dem Web nicht unterstützt und Bilder müssen als Teil der Anfrage hochgeladen werden.
Sehen Sie sich das folgende minimale Beispiel in Python an.
import base64
from openai import OpenAI
# API-Konfigurationapi_key ='<api_key>'# Ersetzen Sie dies durch Ihren API-Schlüsselbase_url ="https://chat-ai.academiccloud.de/v1"model ="internvl3.5-30b-a3b"# Wählen Sie ein verfügbares Modell# Starten des OpenAI-Clientsclient = OpenAI(
api_key=api_key,
base_url=base_url,
)
# Funktion zum Codieren des Bildesdefencode_image(image_path):
with open(image_path, "rb") as image_file:
return base64.b64encode(image_file.read()).decode('utf-8')
# Pfad zu Ihrem Bildimage_path ="test-image.png"# Abrufen der Base64-Zeichenkettebase64_image = encode_image(image_path)
response = client.chat.completions.create(
model=model,
messages=[
{
"role": "user",
"content": [
{
"type": "text",
"text": "What is in this image?",
},
{
"type": "image_url",
"image_url": {
"url": f"data:image/jpeg;base64,{base64_image}" },
},
],
}
],
)
print(response.choices[0])
Ersetzen Sie <key> durch den von GWDG bereitgestellten Schlüssel und <img> durch Ihr Bild. Dieser curl-Befehl verwendet Qwen-Image-Edit-2511 als Backend-Modell.
Sprache zu Text
curl -i 'https://saia.gwdg.de/v1/audio/<translations or transcriptions>'\
--header 'Accept: /'\
--header 'Authorization: Bearer <key>'\
-H "Content-Type: multipart/form-data"\
-F model="whisper-large-v2"\
-F "file=@./<voice.wav, mp4, mp3 or flac>"\
-F response_format=<vtt or text or srt>
Ersetzen Sie <key> durch den von GWDG bereitgestellten Schlüssel, wählen Sie zwischen Transkriptionen oder Übersetzungen, vtt oder srt oder text, und Ihre Audiodatei. Dieser curl-Befehl verwendet whisper-large-v2 als Backend-Modell.
Embeddings
Embeddings sind nur über die API verfügbar und unterstützen die gleiche API wie die OpenAI Embeddings API.
Sehen Sie sich das folgende minimale Beispiel an.
curl https://chat-ai.academiccloud.de/v1/embeddings \
-H "Authorization: Bearer <api_key>"\
-H "Content-Type: application/json"\
-d '{
"input": "The food was delicious and the waiter...",
"model": "e5-mistral-7b-instruct",
"encoding_format": "float"
}'
Um nur das Feld „markdown“ aus der Antwort zu extrahieren, können Sie das jq-Tool in der Kommandozeile verwenden (kann mit sudo apt install jq installiert werden). Sie können die Ausgabe auch einfach in einer Datei speichern, indem Sie > <output-file-name> an den Befehl anhängen.
Hier ist ein Beispiel, um eine PDF-Datei in Markdown zu konvertieren und sie in output.md zu speichern:
Sie können Ihre aktuellen API-Nutzungsgrenzen und verbleibenden Kontingente direkt in den HTTP-Antwortkopfzeilen überprüfen. Führen Sie den folgenden Befehl aus (ersetzen Sie <your-API-Key> durch Ihren tatsächlichen Schlüssel und passen Sie den Endpunkt bei Bedarf an):
X-RateLimit-Limit-*: Maximale Anzahl an Anfragen pro Zeitfenster (Minute, Stunde, Tag).
X-RateLimit-Remaining-*: Anzahl an verbleibenden Anfragen vor Erreichen des Limits.
ratelimit-reset: Zeit (in Sekunden), bis der Zähler zurückgesetzt wird.
Entwicklerreferenz
Die GitHub-Repositories SAIA-Hub, SAIA-HPC und Chat AI enthalten alle Komponenten für die Architektur im obigen Diagramm.
Zitierweise
Wenn Sie SAIA in Ihrer Forschung, Dienstleistungen oder Publikationen verwenden, zitieren Sie uns bitte wie folgt:
@article{doosthosseini_saia_2026,
    title = {{SAIA}: a seamless {Slurm}-native solution for {HPC}-based services},
    volume = {82},
    issn = {1573-0484},
    url = {https://doi.org/10.1007/s11227-026-08508-3},
    doi = {10.1007/s11227-026-08508-3},
    number = {7},
    journal = {The Journal of Supercomputing},
    author = {Doosthosseini, Ali and Decker, Jonathan and Nolte, Hendrik and Kunkel, Julian},
    month = may,
    year = {2026},
    pages = {403},
}
Weitere Dienste
Falls Sie weitere Fragen haben, kontaktieren Sie uns gerne unter support@gwdg.de.
Unterabschnitte von SAIA Plattform
Budget Limits
Vom Vertrag zum Budget
Die Budgets einer Organisation ergeben sich aus dem, was sie gekauft hat:
Schritt
Berechnung
Beispiel
Jahresbudget
nach Vertrag
72.000 €
Monatsbudget
Jahr ÷ 12
6.000 €
Tagesbudget
Monat ÷ 15
400 €
Der Tageswert wird durch 15 geteilt, nicht durch 30, und das ist absichtlich. Bei ÷ 30 könnten Sie nie mehr als den gleichmäßigen Tagesanteil nutzen, und eine Frist oder eine Lehrwoche würde an die Grenze stoßen. Die Division durch 15 ergibt etwa das Doppelte des gleichmäßigen Tagessatzes als Burst-Zulage: lastintensive Tage sind möglich, aber dieses Tempo den ganzen Monat aufrechtzuerhalten nicht.
Zwei Arten von Budgetlimits
„Budgetlimit" umfasst zwei Mechanismen, und sie verhalten sich unterschiedlich. Beide werden in Euro gemessen;
Ein Budget-Cap ist eine Obergrenze für eine Gesamt-Rechnung oder ein Prepaid-Guthaben. Sobald Sie es erreichen, werden Sie gestoppt, bis die Periode endet oder ein Administrator es erhöht. Ihre monatlichen und Gesamtbudgets sind Caps. Was von einem monatlichen Budget übrig bleibt, wird in den nächsten Monat übertragen und addiert, sodass nichts, was Sie nicht ausgeben, verloren geht.
Ein Budget-Rate-Limit ist eine Obergrenze für eine Rate (Geschwindigkeit). Sobald Sie es erreichen, werden Sie nur gestoppt, bis das Fenster weiterzieht, eine Stunde später oder am nächsten Tag. Es ist eher eine Drosselung als eine Obergrenze: Nichts geht verloren, wenn Sie das Tageskontingent nicht ausschöpfen. Hier gibt es keinen Übertrag: Jede neue Stunde und jeder neue Tag beginnt mit demselben Limit, unabhängig davon, was vom vorherigen übrig war.
Die vier Budgetlimits
#
Budgetlimit
Art
Periode
Übertrag: Wird das Nichtausgegebene in die nächste Periode übertragen?
Typischer Standardwert
Reaktion beim Erreichen
Wann Sie wieder ausgeben können
1
Gesamt
Cap
Lebensdauer des Schlüssels, Benutzers oder der Organisation
nicht zutreffend, ein einmaliges Kontingent, das nie neu startet
keines gesetzt
429, unter Angabe Ihrer Nutzung und Ihres Limits
erst wenn ein Administrator es erhöht
2
Monatlich
Cap
Kalendermonat
Ja, der Rest wird zum Budget des nächsten Monats addiert
1.000 € pro Benutzer
429, unter Angabe Ihrer Nutzung und Ihres Limits
vollständig, zu Beginn des nächsten Monats
3
Täglich
Rate-Limit
Kalendertag, Ortszeit
Nein, jeder Tag beginnt mit demselben Limit
100 €
429 mit einem Retry-After-Header
vollständig, um Mitternacht Ortszeit
4
Stündlich
Rate-Limit
Gleitende Stunde
Nein, jede Stunde beginnt mit demselben Limit
20 €
429 mit einem Retry-After-Header
schrittweise, sobald frühere Ausgaben aus dem Zeitfenster fallen, normalerweise deutlich unter einer Stunde
Standardwerte sind genau das. Ihre Organisation kann andere Werte festlegen.
Rate Limits
Wie haben wir Rate- und Budgetlimits für jede Organisation berechnet?
Zwei separate Fragen mit unterschiedlichen Antworten. Die Limits einer Organisation leiten sich aus ihrem Vertrag ab, sodass das, was sie gekauft hat, und das, was sie pro Tag ausgeben darf, übereinstimmen.
Die Einheit, die Euro mit Anfragen verbindet
Ein Budget wird in Euro gemessen und ein Rate-Limit in Anfragen, daher benötigt die Übersetzung des einen in das andere einen Umrechnungsfaktor. Abgeleitet aus echten Nutzungsstatistiken bei der GWDG: Eine durchschnittliche Anfrage besteht aus ungefähr 10.000 Token, was bei etwa 1 € pro Million Token etwa 0,01 € pro Anfrage entspricht.
1 Anfrage ≈ 10.000 Token ≈ 0,01 € (bei etwa 1 € pro Million Token)
Dies ist ein statistischer Durchschnittswert, der für die Rate-Limitierung verwendet wird, keine Abrechnungsregel. Ihnen wird immer die token-genaue Kosten des tatsächlich verwendeten Modells in Rechnung gestellt. Seine einzige Aufgabe ist es, ein Budget als Anzahl von Anfragen ausdrückbar zu machen.
Vom Tagesbudget zum Anfrage-Rate-Limit
Das Anfrage-Limit schützt den Dienst vor Überlastung. Es wird aus dem Tagesbudget (siehe Budgets) durch die durchschnittliche Anfrage oben abgeleitet:
Anfragen pro 10 s = Tagesbudget ÷ 0,01 € ÷ 3.600 s × 10 s
Durchgerechnet für ein Tagesbudget von 400 €:
Schritt
Berechnung
Ergebnis
Wert des Tagesbudgets in Anfragen
400 € ÷ 0,01 €
40.000 Anfragen
Verteilt über eine Stunde
40.000 ÷ 3.600 s
11,1 Anfragen pro Sekunde
Pro 10-Sekunden-Fenster
× 10
111 Anfragen / 10 s
Der erklärungsbedürftige Schritt ist die Division durch 3.600 Sekunden (eine Stunde) statt durch 86.400 (einen Tag). Ein Tagesbudget gleichmäßig über einen Tag zu verteilen, würde etwa 4,6 Anfragen pro 10 Sekunden ergeben. Es stattdessen über eine Stunde zu verteilen, ergibt 111, was 24-mal großzügiger ist, und das ist die Absicht: Das Rate-Limit ist nicht dazu da, das Budget durchzusetzen. Das Budget setzt sich selbst durch, token-genau, während Sie es ausgeben. Das Rate-Limit existiert nur, um zu verhindern, dass eine einzelne Organisation die gemeinsame Infrastruktur überfordert, daher ist es so dimensioniert, dass Bursts durchgelassen werden und nur anhaltender Missbrauch gedrosselt wird.
Dimensionierung stattdessen nach Kopfzahl
Wenn eine Organisation ein pauschales Kontingent für eine Anzahl von Benutzern hat statt eines Euro-Budgets, wird das Limit nach der Kopfzahl dimensioniert:
Anfragen pro 10 s = Anzahl der Benutzer ÷ 1.000
Eine Organisation mit 60.000 Benutzern erhält daher 60 Anfragen pro 10 Sekunden. Der Divisor geht davon aus, dass nur ein kleiner Bruchteil einer Institution jemals in denselben zehn Sekunden eine Anfrage stellt, was der tatsächlichen Nutzung entspricht.
Limits werden überprüft
Für die Nutzung im Free-Tier werden die genauen Limits regelmäßig entsprechend der tatsächlich verfügbaren Kapazität angepasst. Der freie Zugang läuft auf Fair-Share-Knoten, was definitionsgemäß freie Kapazität ist. Limits werden auch im Verhältnis zur Pay-per-Token-Preisgestaltung sinnvoll gehalten, sodass ein Rate-Limit einen Vertrag nie teurer in der Nutzung macht, als es die Zahlung pro Token gewesen wäre.
Token-Kostenberechnung
Info
Die untenstehenden GPU-Raten und Token-Preise sind die Werte, die für die Berechnung der hier gezeigten Beispiele verwendet werden. Die autoritativen und aktuellsten Preise für jedes Modell finden Sie in unserer aktuellen Preisliste.
Wie hoch sind unsere Kosten?
Alles, was Sie nutzen, wird tokengenau abgerechnet: Die Eingabe- und Ausgabetokens jeder Anfrage werden gezählt und entsprechend dem Modell, das sie verarbeitet hat, berechnet.
Externe Modelle
Interne Modelle
Wo das Modell läuft
auf den eigenen Servern des Cloud-Anbieters, z. B. OpenAI- und Anthropic-Modelle über Microsoft Azure in Schweden
auf unseren eigenen HPC-Clustern in Göttingen
Was Ihnen berechnet wird
die Standard-Token-Raten, die der Anbieter für dieses Modell zum Zeitpunkt jeder Anfrage veröffentlicht
ein Preis, den wir selbst aus den Kosten berechnen, die für den Betrieb dieses Modells auf unseren Clustern entstehen, wie unten detailliert
Entwickler, Systemadministratoren und Support; etwa ein Vollzeitmitarbeiter pro 400.000 Nutzer, geschätzt auf etwa 15 % der Hardware-Investition
Allgemeine Kosten
Allgemeine Kosten von GWDG
Stillstandszeiten
GPUs sind nicht ständig beschäftigt, und die Stunden, in denen sie stillstehen, müssen durch die Stunden, in denen sie arbeiten, finanziert werden
Die Basisgröße: eine GPU-Sekunde
Alle oben genannten Faktoren werden in eine einzige Zahl zusammengefasst: Was eine Sekunde einer GPU kostet. Die Kosten werden in eine-Sekunde-Intervallen berechnet.
GPU
Kosten pro Sekunde
A100
0,0005991 €
H100
0,0007408 €
H200
0,0008847 €
B200
0,0013898 €
Neuere und schnellere GPUs kosten pro Sekunde mehr (ein B200 kostet etwa 2,3-mal so viel wie ein A100), und ein Modell, das auf einer solchen GPU läuft, wird entsprechend teurer berechnet.
Von GPU-Sekunden zu Token-Preisen
Für jedes Modell definieren wir, auf welcher GPU-Art es läuft, wie viele GPUs es verwendet und wie viele Anfragen es gleichzeitig verarbeiten kann. Leistungsprüfungen messen dann für dieses Modell die Zeit pro Eingabetoken und die Zeit pro Ausgabetoken. Der Preis eines Tokens ergibt sich aus der Multiplikation dieser beiden Zahlen:
Kosten pro Token = Kosten pro GPU-Sekunde × Sekunden GPU-Zeit, die dieses Token verbraucht
Im Beispiel eines Modells:
Eingabeparameter
Wert
Modell
qwen3.6-35b-a3b
GPU
1 × H100 95 GB, zu 0,0007408 € pro Sekunde
Parallelität
16 Anfragen gleichzeitig
Zeit pro Eingabetoken
0,000162604 s
Zeit pro Ausgabetoken
0,001648210 s
Ergebnis
Berechnung
Preis
1 Million Eingabetoken
0,0007408 × 1.000.000 × 0,000162604
0,11 €
1 Million Ausgabetoken
0,0007408 × 1.000.000 × 0,001648210
1,11 €
Die Parallelität macht dies erschwinglich. Die GPU verarbeitet 16 Anfragen gleichzeitig, sodass die Kosten pro Sekunde effektiv auf sie verteilt werden. Dies ist bereits in den gemessenen Token-Zeiten enthalten.
Warum Ausgabetokens etwa zehnmal teurer sind als Eingabetokens
Im obigen Beispiel kosten Ausgabetokens etwa zehnmal mehr als Eingabetokens: 1,11 € gegenüber 0,11 € pro Million. Dies ist keine Preisentscheidung, sondern eine Eigenschaft, wie die Modelle funktionieren: Eingabetokens werden parallel in einem Durchlauf verarbeitet, während Ausgabetokens nacheinander generiert werden müssen, wobei jedes Token einen vollständigen Durchlauf durch das Modell erfordert. Das gleiche Verhältnis findet sich auch in den Preislisten der kommerziellen Anbieter.
Die praktische Konsequenz für Sie: Ein langer Prompt ist billig, eine lange Antwort dagegen nicht. Die Begrenzung der Ausgabelänge Ihrer Anfragen ist die wirksamste Möglichkeit, Ihre Ausgaben zu senken.
Externe Modelle
Kommerzielle Modelle (OpenAI, Anthropic und andere) werden von Microsoft auf Azure gehostet, nicht in Göttingen, daher sind ihre Kosten die Token-Preise des Anbieters, nicht eine Berechnung von GWDG. Sie werden nach Token-Nutzung abgerechnet und ziehen aus den Budgets für externe Modelle. Da sie in der Regel teurer pro Token sind als quelloffene Modelle, sind sie die Modelle, bei denen ein Kostenlimit am häufigsten angewendet wird.
AI Community
Info
An dieser Stelle ergänzen wir in Kürze weitere Informationen zur AI Community und Governance.
Ziele
Die KI-Entwicklung schreitet rasant voran. Ob Sie an fortschrittlichen Modellen arbeiten, Workflows optimieren oder Lösungen im großen Stil bereitstellen - die Navigation in diesem Umfeld erfordert Zusammenarbeit und kontinuierliches Lernen. Chat AI Community ist eine Plattform dafür. Ein Ort, an dem Wissen geteilt wird, Themen diskutiert werden und Zusammenarbeit entsteht.
Wir laden besonders zur Mitarbeit und Diskussion zu folgenden Themen ein:
Auswahl der aktuellen Open-Weight KI-Modelle
Skalierbare Infrastruktur für KI
MLOps und Automatisierung von Workflows
Effizientes Training und Feinabstimmung von Deep-Learning- und Grundmodellen
Wir stehen für Ihre Fragen gerne zur Verfügung und bieten Ihnen verschiedene Kontaktmöglichkeiten:
Support-Ticket
Wenn Sie Fragen haben oder auf Probleme stoßen, können Sie ein Support‑Ticket erstellen, indem Sie eine E‑Mail mit Ihrer Nachricht an die passende E‑Mail‑Adresse aus der nachfolgenden Tabelle senden. So kann Ihre Anfrage leicht an eine Fachperson für Ihr Anliegen weitergeleitet werden.
Für KI-Nutzer*innen des HPC-Systems mit Fragen zu HPC-Jobs, Slurm, etc.
Wenn Sie unseren Support kontaktieren, geben Sie bitte immer so viele relevante Informationen wie möglich an.
Öffentliche Anfragen via Matrix
Alternativ können Sie uns und andere Nutzer*innen über unseren öffentlichen Matrix‑Raum AI Community erreichen. Es handelt sich um einen Gruppen‑Chat, in dem eine Community aus AI‑Nutzer*innen und -Expert*innen Informationen austauschen kann.
Dies ist ein guter Ort, um aktuelle temporäre Probleme, Ausfälle und laufende Wartungen zu erfragen oder zu diskutieren. Sie können dort jedes beliebige Problem ansprechen; wenn die Antwort jedoch umfangreicher ist oder wir (oder Sie) persönliche Informationen benötigen, bitten wir Sie, stattdessen ein Support-Ticket zu öffnen.
Telefon-Support (dringende Fälle)
Für dringenden Support bietet die GWDG eine allgemeine Hotline an: +49 551 39‑30000.
Unterabschnitte von Support
FAQ (Häufig gestellte Fragen)
Info
Diese Seite ist in Bearbeitung.
Weitere FAQ werden demnächst hinzugefügt.
Stellen Sie gerne Ihre Fragen an den Support.
Wie kann ich einen SAIA API Key bekommen?
Das Vorgehen zur Beantragung eines SAIA API Keys ist in diesem Abschnitt beschrieben.